
Arrêtify
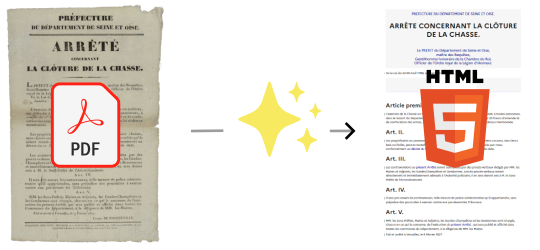
Arrêtify est une librairie Python permettant la conversion d’arrêtés préfectoraux français en HTML sémantique. Le document résultant est structuré au moyen de data attributes (ex. data-spec="header", data-spec="section", etc.) et enrichi de nombreuses métadonnées (dates, références juridiques, titres d’articles, etc.).
⚠️ Statut : ALPHA, développement actif. N’hésitez pas à l’essayer, à nous faire vos retours et à contribuer ! À ce stade, nous déconseillons un usage en production.
→ Pourquoi du HTML Sémantique ?
- Data & IA-ready : accès précis et facile aux données, ouvrant la voie à des cas d'usages variés - indexation, RAG, entrainement, etc.
- Web-ready : affichage direct dans un navigateur, intégration simple à toute stack web ou CMS.
- Léger et portable : un simple fichier HTML encapsule tout le contenu enrichi, sans dépendance serveur.
→ Fonctionnalités clés
- Formats d'entrée : PDF, Markdown
- Intégration OCR : compatible « out-of-the-box » avec Mistral OCR.
- Entièrement modulaire : collection de steps de traitement qui peuvent être chaînés pour construire un pipeline adapté aux besoins de l'utilisateur.
- Enrichissement sémantique : steps optionnels permettant d'enrichir le HTML en métadonnées :
- détection de références - droit français, droit européen, arrêtés connexes
- opérations de modification - abrogation, modification, d'arrêtés connexes
→ Exemples en ligne
Démarrage rapide
→ Installation :
# Installe la dernière version d'arrêtify
pip install arretify

# Modèles spacy
python -m spacy download fr_dep_news_trf
Plus d'options d'installation, voir la section options d'installation
→ Utilisation avec le CLI :
arretify -i /path/to/ocr.md -o /path/to/output.html
Pour directement convertir un document pdf, il vous faudra configurer votre clé mistral. Voir la partie configuration.
→ Utilisation depuis Python :
Convertir un document markdown (résultat d'une opération d'OCR) en HTML:
from pathlib import Path
from arretify.pipeline import save_html_file, run_pipeline, load_ocr_file
from arretify.types import SessionContext
from arretify.settings import Settings

save_html_file(
    Path('/path/to/output.html'),
    run_pipeline(
        load_ocr_file(
            SessionContext(settings=Settings()),
            Path('/path/to/ocr.md'),
        )
    ),
)
Configuration
La librairie se configure avec des variables d'environnement. Vous pourrez par exemple créer un fichier .env avec les variables suivantes :
# Si vous voulez utiliser Mistral OCR
MISTRAL_API_KEY ='<MISTRAL_API_KEY>'

# Si vous voulez utiliser la résolution de références
# aux textes de droit français.
LEGIFRANCE_CLIENT_ID = '<LEGIFRANCE_CLIENT_ID>'
LEGIFRANCE_CLIENT_SECRET = '<LEGIFRANCE_CLIENT_SECRET>'

# Si vous voulez utiliser la résolution de références
# aux textes de droit européen.
EURLEX_WEB_SERVICE_USERNAME = '<EURLEX_WEB_SERVICE_USERNAME>'
EURLEX_WEB_SERVICE_PASSWORD = '<EURLEX_WEB_SERVICE_PASSWORD>'

# Choix de l'environnement d'execution.
# Notez qu'en developpement tous les appels à API externe sont
# récupérés depuis le cache (voir `law_data\dev_cache.py`)
ENV = 'development'
CLI
Pour éxecuter le parsing sur un lot de fichiers OCRisés, copier le dossier de fichiers dans un dossier facilement accessible (e.g. ./tmp/arretes_ocr), et exécuter la commande main.py. Par exemple :
python -m main -i ./tmp/arretes_ocr -o ./tmp/arretes_html
Il est aussi possible d'éxecuter le parsing sur un fichier unique en passant en option le chemin complet d'entrée et de sortie, par exemple :
python -m main -i ./tmp/arretes_ocr/bla.txt -o ./tmp/arretes_html/bla.html
Options d'installation
Arretify est plus rapide et performant avec un GPU. Vous pouvez alors installer les dépendances optionnelles suivantes :
# Adapter selon votre version de cuda
# Pour torch : https://pytorch.org/get-started/locally/
# Pour spacy : https://spacy.io/usage
pip install torch~=2.8.0 --extra-index-url https://download.pytorch.org/whl/cu128
pip install spacy[cuda12x]~=3.8.7
Developpement
Setup
Installer la librairie et ses dépendances en mode développement :
pip install -e .[dev]  # Sur Linux
pip install -e .[dev] --extra-index-url https://download.pytorch.org/whl/cu128  # Sur Windows, version CUDA à adapter selon votre cas

# Modèles spacy
python -m spacy download fr_dep_news_trf
Initialiser les sous-modules Git (qui se trouvent dans arretify/_vendor) :
git submodule update --init --recursive
Outils de développement
La librairie utilise les outils suivants :
pytestpour les testsmypyfor static type-checkingblackpour le formattage de code automatiqueflake8etflake8-bugbearpour le lintingautoflakepour la suppression automatique des imports inutilisés. Utilisation :autoflake \ --in-place \ --recursive \ --remove-all-unused-imports \ --remove-unused-variables \ --exclude=__init__.py \ arretify scripts
licenseheaderspour la gestion des en-têtes de licence dans les fichiers de code source.pre-commitpour la gestion des git pre-commit hooks
Afin d'initialiser les pre-commit hooks dans votre repository, lancer la commande suivante :
pre-commit install
Ainsi avant chaque commit un run des outils de linting sera executé pour vérifier le formattage et les fautes de style.
Testing
Pour éxecuter les tests :
pytest
Snapshot testing
Le fichier arretify/main_test.py permet de détecter les regressions en effectuant le parsing sur tous les documents de notre base de tests de documents dans arretes_ocr/ et en comparant le résultat obtenu avec des résultats obtenus précédemment et stocké dans arretes_html/.
Si les tests échouent c'est que la génération d'html a changé. Il convient donc de vérifier que c'est bien une évolution voulue et non une régression. Pour ça voici une proposition de process :
- Re-générer les fichiers html de référence en utilisant la commande
python -m arretify.main -i test_data/arretes_ocr -o test_data/arretes_html - Utiliser l'outil de diff de git (ou de vscodium) pour comparer la nouvelle version avec la version de référence
- Régler les problèmes éventuels, puis répéter étape 1.
Évaluation de qualité
Le module quality_evaluation permet de suivre la qualité du pipeline sur différentes métriques en comparant les résultats avec une vérité terrain (ou "ground truth").
Expériences disponibles :
segmentation_in_sections: qualité de la segmentation en sectionstables_detection: qualité de la détection des tableaux
Installer les dépendances avec la commande suivante :
pip install -e .[quality_evaluation]
Pour évaluer le pipeline (après chaque modification majeure) :
python -m quality_evaluation.main segmentation_in_sections evaluate --cache-dir ./tmp/ocr_cache
L'évaluation compare les métriques avec le run précédent et affiche les régressions et améliorations par fichier. Les résultats sont sauvegardés dans quality_evaluation/segmentation_in_sections.json. L'option --cache-dir permet de ne pas répeter l'opération d'OCR si la commande est exécutée plusieurs fois.
Pour produire des vérités de terrain :
python -m quality_evaluation.main segmentation_in_sections generate_ground_truth --cache-dir ./tmp/ocr_cache
Pour produire des vérités de terrain, on pourra s'aider de la commande generate_ground_truth. Cette dernière permet de générer des fichiers contenant les données qui seront utilisée pour effectuer l'évaluation de qualité. Il est nécessaire ensuite de reprendre ces fichiers générés automatiquement afin de corriger manuellement toutes les erreurs.
Téléchargement des données de bases de droit
Afin de parser et résoudre les références citées dans les AP à des textes du droit français ou européen, nous téléchargeons grâce à divers scripts des fichiers contenant des listes de références à vérifier. Les fonctionalités pour accéder à ces références se trouvent dans le dossier arretify/law_data, les scripts se trouvent dans le dossier scripts.
Pour utiliser ces scripts, il faut installer et configurer la librairie du Data Studio Risques py-clients-api-droit.
Légifrance
Télécharger la liste des codes :
python ./scripts/download_data_legifrance.py -o ./arretify/law_data/legifrance
Publication sur PyPI
La publication sur PyPI se fait automatiquement à travers GitHub Actions. Cette action est définie dans le workflow .github/workflows/publish.yml.
Pour publier une nouvelle version :
- Créer une branche de release
git checkout -b release-v1.2.3 - Incrémenter le numéro de version dans
pyproject.toml - Ajouter un log dans le fichier
CHANGELOG.md - Réinstaller la librairie si besoin, puis regénérer les HTML des exemples pour mettre à jour le numéro de version
- Effectuer un commit et pusher la branche
- Ajouter un tag de version correspondant au nouveau numéro de version de la librairie :
git tag v1.2.3                  # Crée le tag localement
git push origin refs/tags/v1.2.3  # Push le tag sur github
- Terminer par une PR
1 maintainer

Metadata
1 maintainer
Release files for arretify 0.2.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| arretify-0.2.0.tar.gz | 6.3 MB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| arretify-0.2.0-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 12.6 MB
Release files / arretify-0.2.0.tar.gz
| Download URL | arretify-0.2.0.tar.gz |
|---|---|
| Size | 6.3 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
bfde04fecfcd21e1a9111e0ef3f2d60562e8546148a3993ff1314bfcd9b4e756
|
|
BLAKE2b-256 checksum How to use checksums |
853df7363f76524a1bb19ec9717fa3cb6054dd3c958ffbe82b43bf57e6c28c23
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/6.1.0 CPython/3.13.12
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.


PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Apr 10, 2026.
Transparency logRelease files / arretify-0.2.0-py3-none-any.whl
| Download URL | arretify-0.2.0-py3-none-any.whl |
|---|---|
| Size | 6.2 MB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
8d99ca00a552995268bc401388369d060edf2d6097c39080c8043b27ad95fd94
|
|
BLAKE2b-256 checksum How to use checksums |
7498adf17b4cc7101363e09a9b405f8c06d64fd5cd77baefb04ab1f632aad19e
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/6.1.0 CPython/3.13.12
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Apr 10, 2026.
Transparency log













