

DataComPolars
Comparação de DataFrames e arquivos em Polars, no estilo do datacompy, mas pensada para tabelas grandes: usa hash de linha, janelas por faixa da chave primária (o pico de memória depende do tamanho da janela, não do dataset) e gera um relatório completo em texto, Markdown, HTML ou JSON.
- Fontes: caminho de arquivo, pasta ou glob (parquet, csv ou sas),
pl.DataFrameoupl.LazyFrame. - Execução lazy e em streaming; nenhuma das duas tabelas precisa caber inteira na memória.
- Tipos de divergência cobertos: linhas só de um lado, valores diferentes por coluna, colunas só de um lado, tipos incompatíveis e chave duplicada.
Sumário
- Instalação
- Início rápido
- Desempenho
- Como funciona
- API
- Configuração
- Exemplo de relatório
- Estrutura do repositório
- Testes
- Benchmarks
- Licença
Instalação
Requisitos: Python >= 3.11, polars >= 1.30, pydantic >= 2.7.
pip install datacompolars
pip install "datacompolars[sas]"   # opcional: leitura de .sas7bdat/.xpt
Para desenvolver (núcleo + grupo dev com pytest, psutil e datacompy):
git clone https://github.com/blzrosa/datacompolars.git
cd datacompolars
uv sync                 # ou: uv sync --extra sas
Início rápido
import polars as pl
from datacompolars import CompareSettings, ReportSettings, compare
from datacompolars.report import emit

left = pl.DataFrame({"id": [1, 2, 3], "valor": [10.0, 20.0, 30.0]})
right = pl.DataFrame({"id": [1, 2, 4], "valor": [10.0, 20.5, 40.0]})

result = compare(
    left,
    right,
    CompareSettings(join_columns=["id"], left_name="producao", right_name="homologacao"),
)

print(result.is_match)                  # False
print(result.rows.common)               # 2  (ids 1 e 2)
print(result.rows.mismatched)           # 1  (id 2: valor diferente)
emit(result, ReportSettings(print_output=True))   # imprime o relatório
Há uma demonstração maior, com igualdade exata, tolerância e relatório HTML, em examples/demo.py (no repositório clonado):
uv run python examples/demo.py
Desempenho
Comparação com datacompy (Polars e pandas) e diffly, em igualdade exata, de 100 a 10 milhões de linhas e de 10 a 300 colunas (a curva datacompolars usa as configurações padrão):
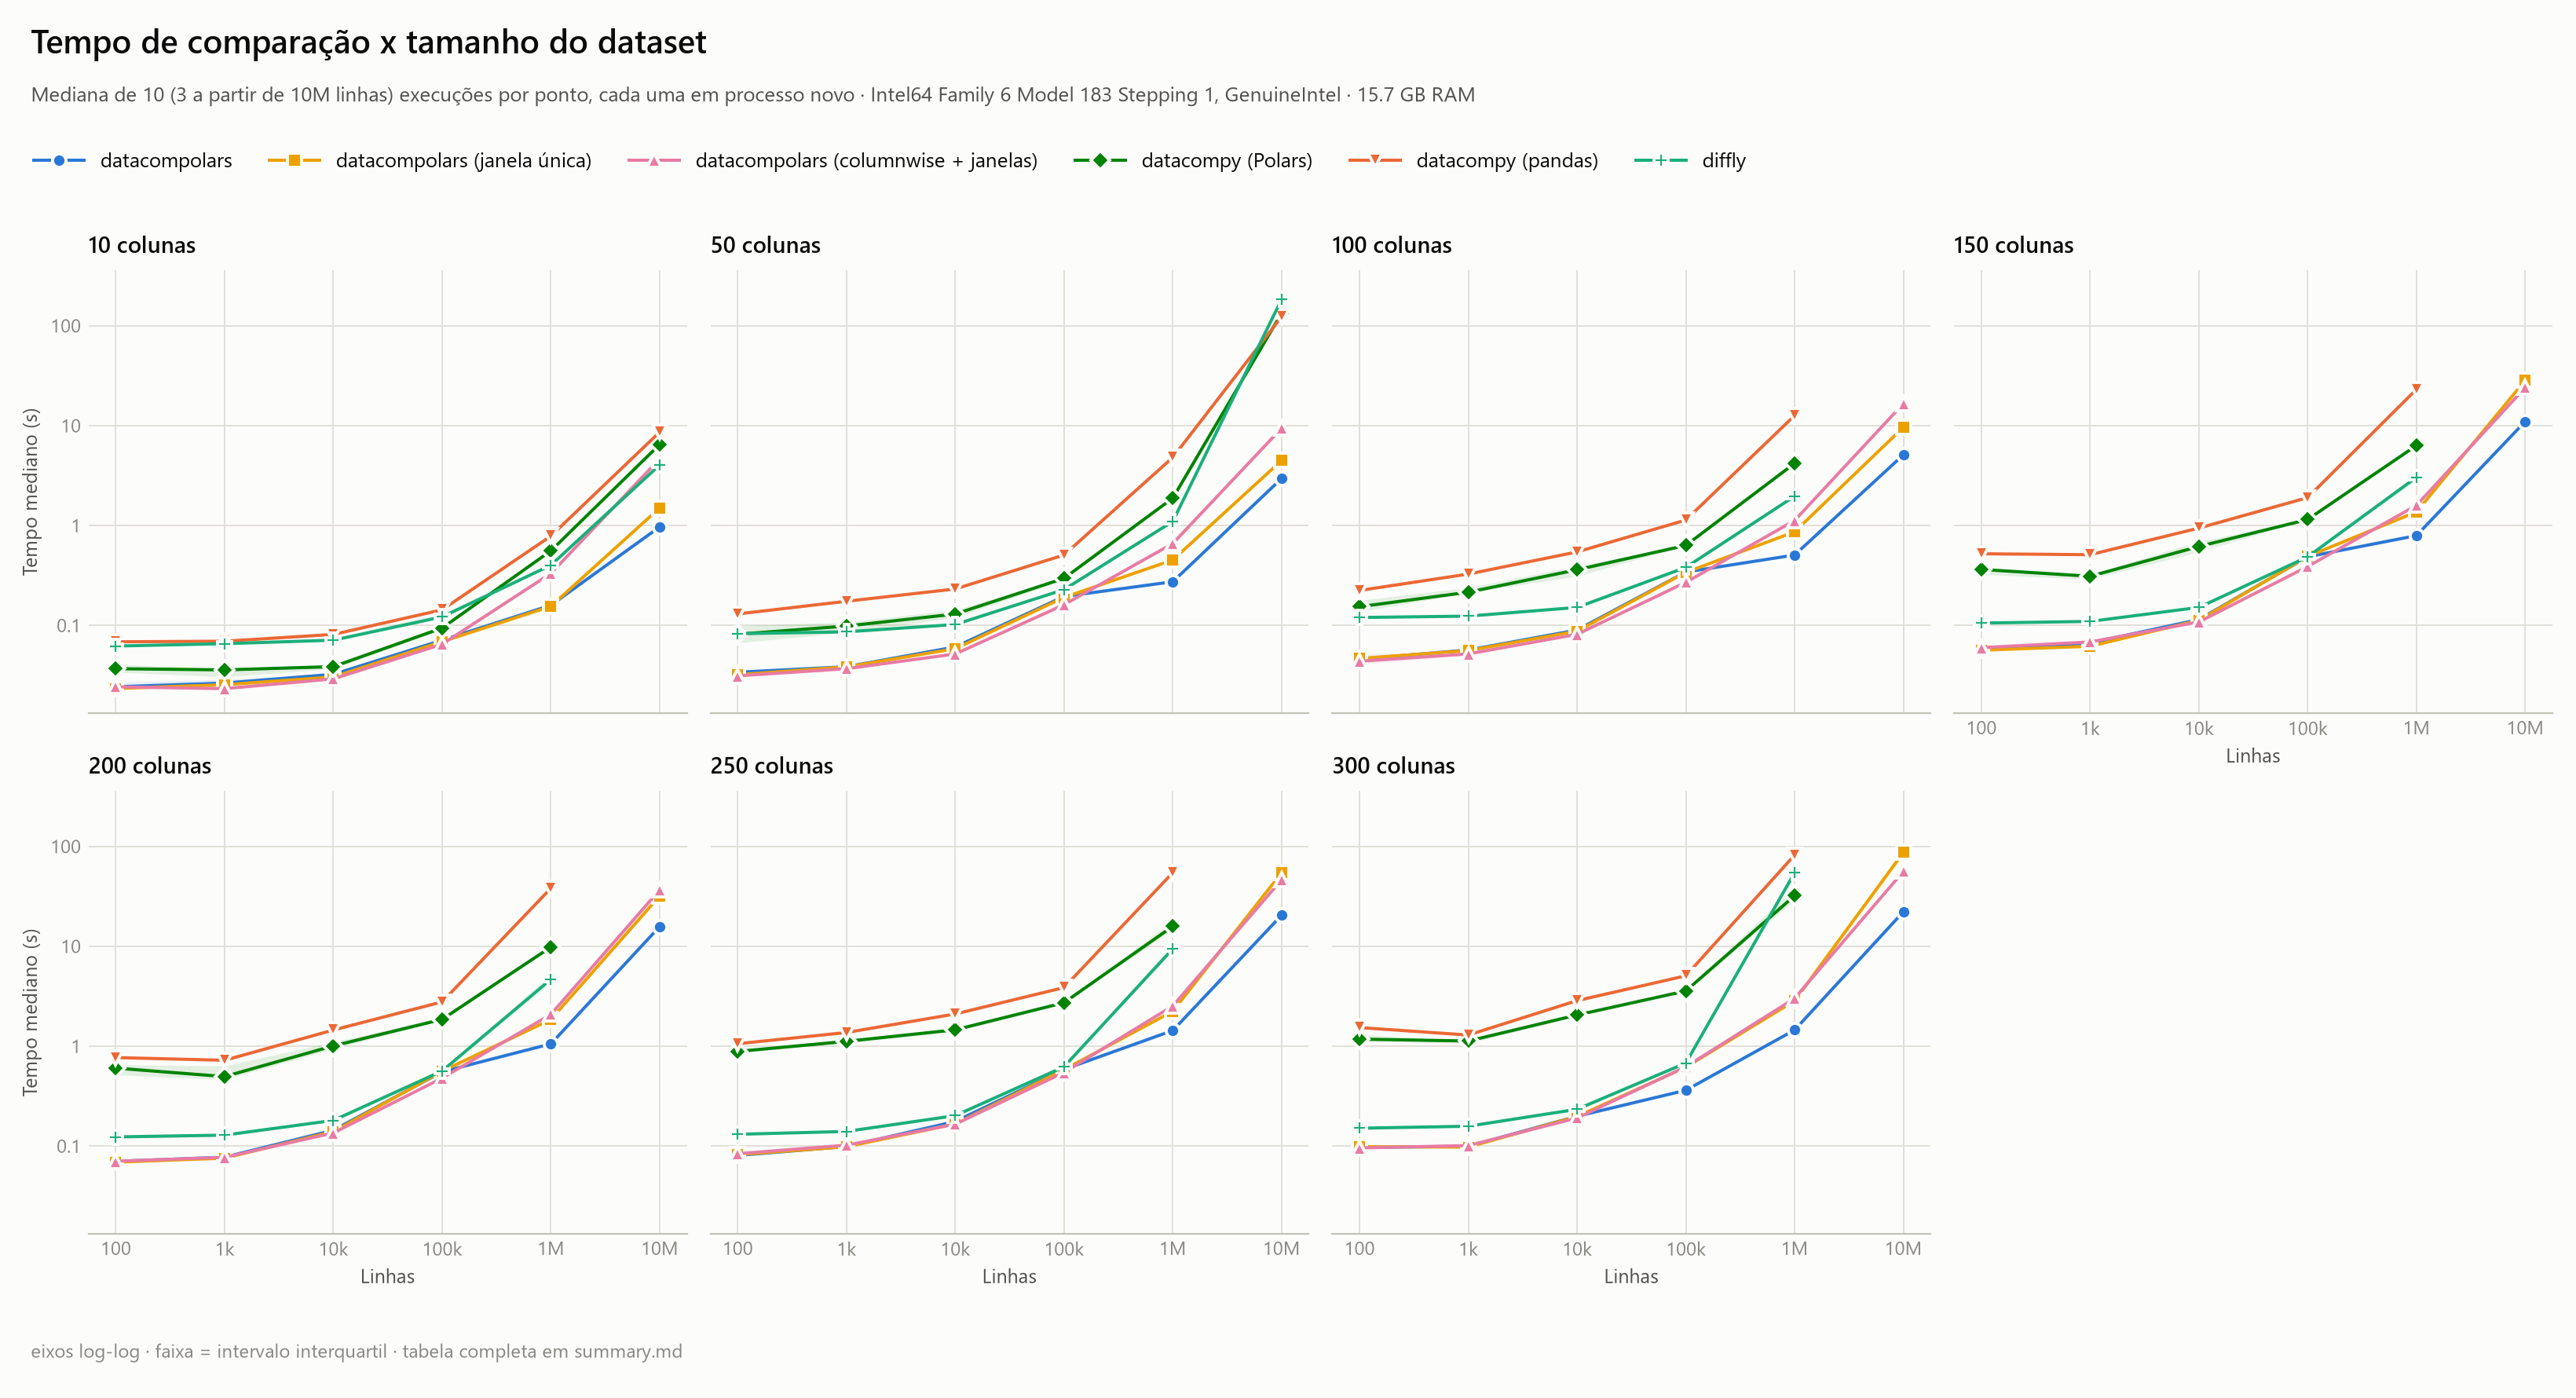
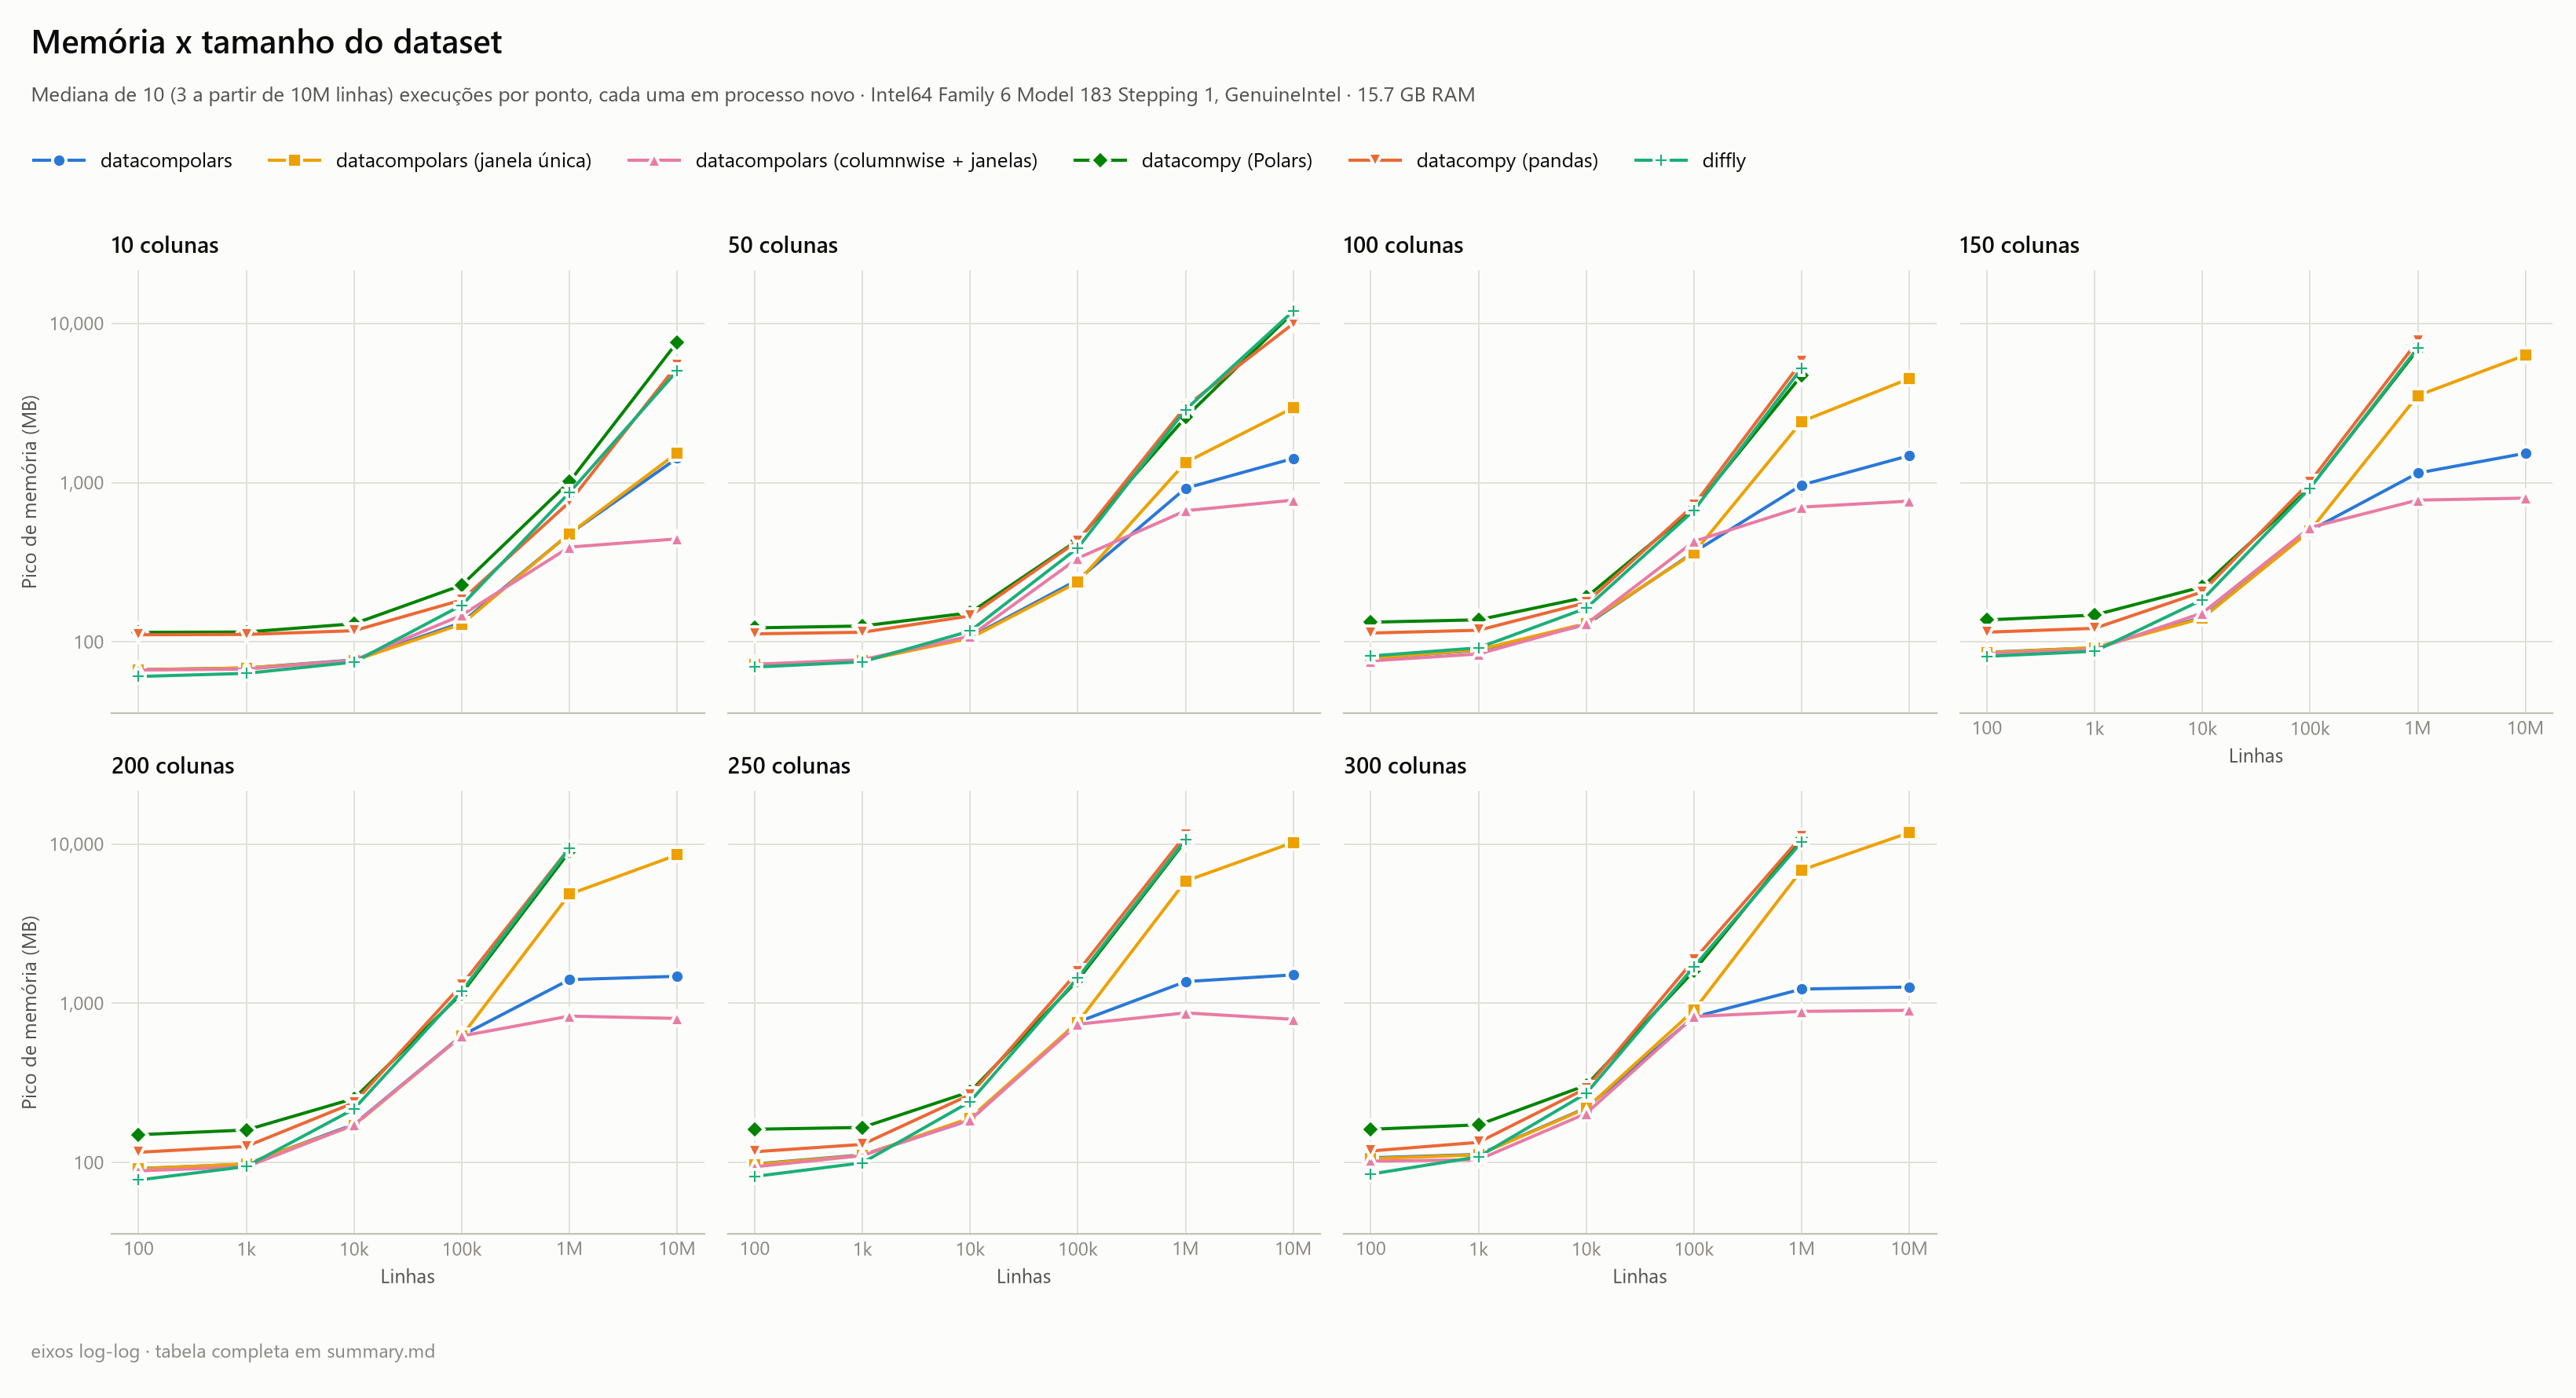
| Linhas × colunas | datacompolars | datacompy (Polars) | datacompy (pandas) | diffly |
|---|---|---|---|---|
| 1.000.000 × 300 | 1,45 s · 1,2 GB | 32,1 s · 10,6 GB (22×) | 82,0 s · 10,9 GB (56×) | 54,6 s · 10,1 GB (38×) |
| 10.000.000 × 50 | 2,96 s · 1,4 GB | 133 s · 11,5 GB (45×) | 123 s · 9,7 GB (42×) | 184 s · 11,7 GB (62×) |
| 10.000.000 × 300 | 22,2 s · 1,2 GB | — | — | — |
Em 1M × 300 o datacompolars leva ~1,5 s com ~1,2 GB, contra 32 a 82 s e ~10 GB nas demais; com 10M de linhas o pico de memória fica em ~1,2 a 1,5 GB para qualquer número de colunas, e datacompy e diffly já não completam com 100 colunas (—). Tempo mediano · pico de memória (e quantas vezes mais lento que o datacompolars). Metodologia, tabelas completas e como reproduzir: docs/benchmarks.
Como funciona
compare() segue este fluxo (detalhado no docstring de engine.py):
- Abre as fontes (lazy), normaliza nomes de colunas, alinha os schemas e escolhe o caminho de comparação.
- Planeja janelas por faixa da 1ª coluna da chave (
join_columns[0], precisa ser inteira). A mesma chave cai sempre na mesma janela, então os resultados de cada janela simplesmente se somam. - Para cada janela:
- checa chave duplicada (só se
check_duplicate_keysestiver ligado); - compara com um dos dois caminhos abaixo;
- se
column_detailsestiver ligado, conta divergências por coluna e coleta amostras.
- checa chave duplicada (só se
Caminhos de comparação
| Caminho | Quando é usado | Como compara |
|---|---|---|
hash |
Igualdade exata em todas as colunas e nenhuma coluna aninhada | Uma única query de full join (chave + hash por linha). Os detalhes por coluna só são lidos nas janelas que têm divergência, e só para as linhas divergentes. |
columnwise |
Há tolerância, opções de string (ignore_spaces, ignore_case), comparadores customizados ou colunas aninhadas (não hasheáveis) |
Join de chaves e comparadores por coluna, em lotes de columns_per_batch colunas. |
O caminho escolhido e o motivo aparecem no relatório (seção Execution) e em result.execution.
Regras de comparação
- Nulos: nulo com nulo é igual; nulo de um lado só é diferença.
- Números: tolerância absoluta (
abs_tol) e relativa (rel_tol), globais ou por coluna. - Strings: opções
ignore_spaceseignore_case. - Listas: comparador próprio para colunas
List. - Chave duplicada: se
check_duplicate_keysestiver ligado e houver duplicidade em qualquer lado, a comparação é abortada (result.aborted == True) e o erro vai pararesult.fatal_errors. - Colunas com tipos diferentes: são listadas no relatório e não comparadas, a menos que o
castingdoCompareSettingsresolva o alinhamento. - Nomes de colunas: com
lowercase_columns, nomes de colunas, chave, tolerâncias e comparadores customizados são normalizados para minúsculas.
Ids muito diferentes (common_keys_only)
Por padrão, cada janela faz um full join que carrega as linhas dos dois lados, inclusive as sem par (e, no caminho hash, calcula o hash de linha de todas elas). Quando as tabelas têm poucos ids em comum, ligue common_keys_only=True:
- Se a 1ª coluna da chave é inteira, só a interseção das faixas de ids dos dois lados (
[max(mínimos), min(máximos)]) é dividida em janelas. As chaves fora dela não podem ter par e são apenas contadas, lendo só a coluna da chave; em parquet, o predicado de faixa poda row groups. - Em cada janela, uma varredura só das colunas da chave encontra as chaves em comum e um semi join filtra os dois lados. O hash e os comparadores processam apenas essas linhas, com inner join.
- As linhas exclusivas continuam no relatório: só esquerda = total da esquerda − em comum (idem à direita).
O resultado é o mesmo do modo padrão; muda só o custo. Pontos de atenção:
- A contagem de exclusivas pressupõe chaves únicas.
check_duplicate_keys(padrão) garante isso, inclusive fora da interseção; com ele desligado e havendo duplicatas, as contagens já eram infladas. - Com muita sobreposição de ids a flag só acrescenta uma varredura das chaves, por isso é opt-in.
- O semi join, sozinho, não evita ler as colunas de valor (o filtro é aplicado depois da leitura). Quem reduz a leitura é a restrição por faixa, que rende mais quando as faixas de ids diferem; com sobreposição espalhada, o ganho vem de não hashear nem comparar as linhas sem par.
- As chaves em comum de cada janela ficam em memória (só as colunas da chave).
- Chaves nulas casam entre si, como no modo padrão.
O ganho depende de quanto os ids se sobrepõem e de quantas colunas a tabela tem; meça com os benchmarks (--id-overlap e as engines *_common).
API
compare(left, right, settings, source=None) -> ComparisonResult
| Parâmetro | Tipo | Descrição |
|---|---|---|
left, right |
caminho, pasta ou glob (parquet, csv ou sas), pl.DataFrame ou pl.LazyFrame |
As duas fontes. |
settings |
CompareSettings ou dict |
Configuração da comparação. Um dict é convertido com CompareSettings(**settings). |
source |
SourceOptions (opcional) |
Opções de leitura dos arquivos (parquet/csv/sas). |
CompareSettingseSourceOptionsestão documentados na seção Configuração.
ComparisonResult
Objeto devolvido por compare() (definido em results.py).
| Atributo | Conteúdo |
|---|---|
is_match |
True quando linhas, valores e colunas são idênticos. |
aborted |
True quando a comparação de linhas não pôde ser feita (erro fatal). |
rows |
RowSummary: left_total, right_total, common, left_only, right_only, mismatched, além de matched e mismatch_rate. |
columns |
ColumnSummary: join_columns, compared, left_only, right_only, type_mismatches. |
column_stats |
Lista de ColumnStat(column, dtype, mismatches, rate), ordenada da coluna com mais divergências para a com menos. |
samples |
Lista de SampleTable(column, total_mismatches, headers, rows): linhas divergentes (chave + valor de cada lado). |
fatal_errors, warnings |
Mensagens de erro e aviso. |
execution |
ExecutionInfo: path, path_reason, windows, rows_per_window, column_details_computed, polars_version, total_seconds, timings (por fase). |
created_at |
Data/hora UTC da comparação. |
to_json() |
Serializa o resultado completo em JSON. |
emit(result, settings=None) -> str
Em datacompolars.report. Renderiza o relatório, salva em UTF-8 se save_path estiver definido, imprime se print_output estiver ligado e devolve o texto.
Formatos: text, markdown, html e json. O conteúdo é montado uma única vez (build_blocks) e cada renderizador só decide a apresentação.
Todas as opções do ReportSettings estão em Configuração.
HTML e JSON sempre trazem tudo, sem os limites acima. O HTML é um arquivo único, sem dependências externas, com tema claro/escuro automático.
Configuração
Tudo que o usuário controla passa por três modelos Pydantic, definidos em settings.py:
| Modelo | Controla | Onde é usado |
|---|---|---|
CompareSettings |
Como comparar (chave, tolerâncias, tipos, desempenho) | 3º argumento de compare() |
SourceOptions |
Como abrir arquivos (formato, separador do CSV etc.) | source= de compare() |
ReportSettings |
Como apresentar o relatório (formato, largura, destino) | 2º argumento de emit() |
Os três usam extra="forbid": um parâmetro com nome errado levanta ValidationError em vez de ser ignorado silenciosamente. Onde compare() aceita CompareSettings, também aceita um dict equivalente.
from datacompolars import CompareSettings, ReportSettings, SourceOptions, compare
from datacompolars.report import emit

result = compare(
    "dados/producao.csv",
    "dados/homologacao.csv",
    CompareSettings(
        join_columns=["id"],
        left_name="producao",
        right_name="homologacao",
        abs_tol={"valor": 0.01},      # tolerância só na coluna "valor"
        ignore_case=True,
        sample_count=10,
    ),
    source=SourceOptions(csv_separator=";"),
)

emit(result, ReportSettings(save_path="reports/comparacao.html", print_output=False))
CompareSettings
Chave e rótulos
| Campo | Padrão | Descrição |
|---|---|---|
join_columns |
obrigatório | Colunas da chave primária (PK) do join. Precisa ter ao menos uma. A primeira é usada para o janelamento e, nesse caso, precisa ser inteira. |
left_name |
"left" |
Rótulo do lado esquerdo no relatório. |
right_name |
"right" |
Rótulo do lado direito no relatório. |
Alinhamento de schemas
| Campo | Padrão | Descrição |
|---|---|---|
lowercase_columns |
True |
Compara nomes de colunas sem diferenciar caixa. Normaliza para minúsculas os nomes de colunas, a chave, as tolerâncias por coluna e os comparadores customizados. |
casting |
"none" |
O que fazer quando a mesma coluna tem tipos diferentes nos dois lados (ver tabela abaixo). |
Valores de casting:
| Valor | Efeito |
|---|---|
"none" |
Só reporta. A coluna com tipos divergentes é listada no relatório e não é comparada. Se o tipo divergente for de uma coluna da chave, é erro fatal. |
"left" |
Converte a coluna da direita para o tipo da esquerda. |
"right" |
Converte a coluna da esquerda para o tipo da direita. |
Regras de igualdade
| Campo | Padrão | Descrição |
|---|---|---|
abs_tol |
0.0 |
Tolerância absoluta. Um float vale para todas as colunas; um dict[str, float] define por coluna. |
rel_tol |
0.0 |
Tolerância relativa, com o mesmo formato de abs_tol. |
ignore_spaces |
False |
Ignora espaços em branco em strings. |
ignore_case |
False |
Ignora maiúsculas/minúsculas em strings. |
custom_comparators |
{} |
dict[str, BaseComparator] com um comparador próprio por coluna, por exemplo {"valor": MeuComparador()}. Veja comparators.py. Não pode conter colunas da chave. |
Nulo com nulo é sempre igual; nulo de um lado só é diferença.
Integridade da chave
| Campo | Padrão | Descrição |
|---|---|---|
check_duplicate_keys |
True |
Valida a unicidade da PK em cada lado. Se encontrar duplicatas, a comparação é abortada (result.aborted). Desligado, e havendo duplicatas, as contagens ficam infladas. |
Nível de detalhe
| Campo | Padrão | Descrição |
|---|---|---|
column_details |
True |
Calcula as divergências por coluna e as amostras. No caminho hash, custa uma leitura extra das janelas que têm divergência. Desligue para apenas contar linhas. |
sample_count |
5 |
Máximo de linhas de amostra por coluna divergente. 0 desativa as amostras. |
Desempenho e memória
| Campo | Padrão | Descrição |
|---|---|---|
columns_per_batch |
50 |
Quantas colunas são avaliadas por lote no caminho columnwise. Reduza se faltar memória em tabelas muito largas. |
window_rows |
"auto" |
Janelas de execução por faixa da 1ª coluna da PK (veja abaixo). |
common_keys_only |
False |
Restringe a comparação às chaves presentes nos dois lados e, com PK inteira, à interseção das faixas de ids. Para tabelas com ids muito diferentes; veja Ids muito diferentes. |
window_rows controla o fatiamento da comparação:
| Valor | Efeito |
|---|---|
"auto" |
Dimensiona em células (linhas × colunas): até 30 milhões de células usa janela única (mais rápida em tabelas pequenas ou estreitas, ex.: 1M × 10 colunas); acima disso fatia em janelas de ~30 milhões de células (no mínimo 100 mil linhas) e guarda cada janela em memória. Ex.: 300 colunas → 100 mil linhas por janela; 100 colunas → 300 mil; 10 colunas → 3 milhões. Constantes AUTO_WINDOW_CELLS e AUTO_WINDOW_MIN_ROWS em settings.py. |
inteiro > 0 |
Força janelas desse tamanho. |
None |
Desliga o janelamento (janela única). |
A mesma chave cai sempre na mesma janela, então o pico de memória passa a depender do tamanho da janela, não do dataset. Se a 1ª coluna da chave não for inteira, o janelamento é ignorado e o motor emite um aviso. Para referência, no benchmark de 30M linhas × 50 colunas a query única de hash usou cerca de 3,7 GB.
Validações
O CompareSettings recusa configurações inválidas na criação:
join_columnsvazio, com nomes em branco ou com colunas repetidas (sem diferenciar caixa);abs_tol/rel_tolnegativos,NaNou infinitos (inclusive dentro dodict);window_rowsigual a zero, negativo,boolou uma string diferente de"auto";sample_count < 0oucolumns_per_batch <= 0;custom_comparatorscontendo colunas da chave.
Qual caminho de comparação será usado
O método uses_exact_hash() informa se a comparação pode usar o hash de linha (mais rápido). Ele devolve False, e o motor usa o caminho columnwise, se qualquer uma destas opções estiver ativa:
| Opção | Faz o motor usar columnwise quando... |
|---|---|
abs_tol / rel_tol |
algum valor for diferente de zero (global ou por coluna) |
ignore_spaces |
for True |
ignore_case |
for True |
custom_comparators |
tiver ao menos um comparador |
Colunas aninhadas (não hasheáveis) também forçam columnwise. O caminho escolhido e o motivo aparecem no relatório e em result.execution.
SourceOptions
Como abrir arquivos. Só afeta fontes dadas como caminho; pl.DataFrame e pl.LazyFrame não são alterados.
| Campo | Padrão | Descrição |
|---|---|---|
format |
None |
Força o formato: "parquet", "csv" ou "sas". Por padrão, é deduzido da extensão do arquivo. |
csv_infer_schema_length |
10_000 |
Linhas usadas para inferir os tipos do CSV. None lê o arquivo inteiro (mais lento, porém mais seguro se os tipos mudam ao longo do arquivo). |
csv_separator |
"," |
Separador do CSV. Precisa ter exatamente 1 caractere. |
recursive |
True |
Ao receber um diretório, procura arquivos também nas subpastas. |
A leitura de SAS exige o extra opcional: pip install "datacompolars[sas]" (ou uv sync --extra sas no repositório).
ReportSettings
Como apresentar o relatório. É passado a emit().
| Campo | Padrão | Descrição |
|---|---|---|
print_output |
True |
Imprime o relatório no console. |
format |
None |
"text", "markdown", "html" ou "json". Se None, é deduzido da extensão de save_path (veja abaixo); sem save_path, usa "text". |
save_path |
None |
Salva o relatório neste arquivo (UTF-8). |
style |
"auto" |
Bordas e barras do formato texto: "unicode", "ascii" ou "auto" (cai para ASCII se o console não suportar unicode). |
width |
100 |
Largura do formato texto. Aceita de 60 a 200. |
max_columns |
20 |
Máximo de colunas divergentes listadas na tabela Differences by column (texto e Markdown). |
max_sample_columns |
10 |
Máximo de colunas com tabela de amostras (texto e Markdown). 0 oculta as amostras. |
Dedução do formato a partir de save_path (quando format é None):
| Extensão | Formato |
|---|---|
.md, .markdown |
markdown |
.html, .htm |
html |
.json |
json |
| qualquer outra | text |
max_columns, max_sample_columns e width só valem para texto e Markdown. HTML e JSON sempre trazem tudo.
Exemplo de relatório
Saída em texto de uma comparação de 1.000.000 de linhas (valores ilustrativos do formato; rode o examples/demo.py do repositório para ver o seu):
════════════════════════════════════════════════════════════════════════════════════════════════════
  DataComPolars Comparison Report
════════════════════════════════════════════════════════════════════════════════════════════════════

  Compared     producao  vs  homologacao
  Join key(s)  id
  Generated    2026-10-01 22:10:43 UTC

┌────────────────────────────────────────────────────────────────────────────────────────────────┐
│ ✘ DIFFERENCES FOUND                                                                            │
│ 9,870 of 999,990 common rows differ (0.99%); 10 rows only in producao; the column sets differ; │
│ 1 columns have different types.                                                                │
└────────────────────────────────────────────────────────────────────────────────────────────────┘

ROWS
────

  ┌──────────────────────┬───────────┬─────────────┬──────────────┐
  │ Category             │ Rows      │ % of common │              │
  ├──────────────────────┼───────────┼─────────────┼──────────────┤
  │ In common            │   999,990 │             │              │
  │   equal              │   990,120 │      99.01% │ ████████████ │
  │   with differences   │     9,870 │       0.99% │ █░░░░░░░░░░░ │
  │ Only in producao     │        10 │             │              │
  │ Only in homologacao  │         0 │             │              │
  │ Total in producao    │ 1,000,000 │             │              │
  │ Total in homologacao │   999,990 │             │              │
  └──────────────────────┴───────────┴─────────────┴──────────────┘

COLUMNS
───────

  Compared                   3
  Only in producao           1
  Only in homologacao        0
  Different types (skipped)  1
  · Only in producao: flag_legado

  Columns with different types (not compared)
  ┌────────┬──────────────────┬─────────────────────┐
  │ Column │ Type in producao │ Type in homologacao │
  ├────────┼──────────────────┼─────────────────────┤
  │ data   │ Date             │ String              │
  └────────┴──────────────────┴─────────────────────┘

DIFFERENCES BY COLUMN
─────────────────────

  ┌────────┬─────────┬─────────────┬─────────────┬──────────────┐
  │ Column │ Type    │ Differences │ % of common │              │
  ├────────┼─────────┼─────────────┼─────────────┼──────────────┤
  │ valor  │ Float64 │       9,500 │       0.95% │ █░░░░░░░░░░░ │
  │ status │ String  │         420 │       0.04% │ █░░░░░░░░░░░ │
  │ nome   │ String  │           3 │      <0.01% │ █░░░░░░░░░░░ │
  └────────┴─────────┴─────────────┴─────────────┴──────────────┘

SAMPLE DIFFERING ROWS
─────────────────────

  valor: 9,500 differing rows, showing 3
  ┌─────┬──────────────────┬─────────────────────┐
  │ id  │ valor (producao) │ valor (homologacao) │
  ├─────┼──────────────────┼─────────────────────┤
  │ 17  │ 10.5             │ 10.7                │
  │ 203 │ 99.99            │ 100                 │
  │ 998 │ null             │ 0                   │
  └─────┴──────────────────┴─────────────────────┘

  status: 420 differing rows, showing 2
  ┌────┬───────────────────┬──────────────────────┐
  │ id │ status (producao) │ status (homologacao) │
  ├────┼───────────────────┼──────────────────────┤
  │ 5  │ ATIVO             │ INATIVO              │
  │ 88 │ ATIVO             │ null                 │
  └────┴───────────────────┴──────────────────────┘

EXECUTION
─────────

  Method             hash  (exact equality on all columns (row hash))
  Execution windows  1
  Column details     computed
  Total time         1.23 s
  Time by phase      open 10 ms, plan 0 ms, duplicates 310 ms, compare 620 ms, details 290 ms
Quando a comparação é abortada (por exemplo, chave duplicada), o veredito vira COMPARISON ABORTED e a seção Errors lista os motivos.
Estrutura do repositório
datacompolars/
├─ pyproject.toml
├─ docs/
│  └─ benchmarks/          # resultados e gráficos do benchmark final (README, summary.md, images/, data/)
├─ examples/
│  └─ demo.py              # demonstração de uso
├─ src/datacompolars/
│  ├─ __init__.py          # exporta compare, CompareSettings, ReportSettings, SourceOptions
│  ├─ engine.py            # compare(): motor (janelas, hash, columnwise, amostras)
│  ├─ io.py                # abertura lazy de parquet/csv/sas, DataFrame e LazyFrame
│  ├─ report.py            # emit(): relatório em text, markdown, html e json
│  ├─ settings.py          # CompareSettings, ReportSettings, SourceOptions
│  ├─ results.py           # ComparisonResult e modelos do resultado
│  ├─ schema.py            # normalização e alinhamento de schemas
│  ├─ hashing.py           # hash de linha
│  ├─ windows.py           # planejamento de janelas por PK
│  └─ comparators.py       # comparadores numérico, string e lista
├─ tests/
│  ├─ __init__.py
│  ├─ helpers.py
│  ├─ fixtures/
│  │  └─ sample.sas7bdat   # amostra real para os testes de SAS
│  ├─ test_engine.py  test_windows.py  test_schema_settings.py  test_report.py  test_common_keys.py
│  └─ test_io.py  test_sas.py
└─ benchmarks/
   ├─ __init__.py
   ├─ datagen.py           # gerador de dados (módulo + CLI)
   ├─ run.py               # uma engine em um dataset
   ├─ suite.py             # grade linhas x colunas x engines
   ├─ final_benchmark.py   # benchmark final padronizado (suite + gráficos)
   ├─ plot.py              # gráficos e summary.md
   └─ results/             # saídas dos benchmarks (locais)
tests/, benchmarks/, docs/ e examples/ existem apenas no repositório do GitHub; o pacote publicado no PyPI contém só src/datacompolars.
Os diretórios data/ (datasets gerados) e reports/ (relatórios salvos) são locais.
Testes
uv run --extra sas pytest      # suíte completa (inclui SAS)
uv run --exact pytest          # núcleo; os testes de SAS são pulados sem o extra
Marcadores disponíveis: sas (exige polars-readstat/pyreadstat) e slow (datasets maiores). Exemplo: uv run --extra sas pytest -m "not slow".
Benchmarks
Os resultados do benchmark final (gráficos, tabelas e metodologia) estão em Desempenho e em docs/benchmarks. Os baselines são o datacompy e o diffly (instalados no grupo dev).
Geração de dados:
uv run python benchmarks/datagen.py --rows 1000000 --cols 50 --divergence 0.01 --tag div1pct
uv run python benchmarks/datagen.py --rows 5000000 --cols 100 --divergence 0.01 --tag div1pct
uv run python benchmarks/datagen.py --rows 30000000 --cols 50 --partitions 300 --divergence 0.01 --tag div1pct
# ids parcialmente em comum (aqui, só 10% dos ids do base existem no compare), para medir common_keys_only
uv run python benchmarks/datagen.py --rows 5000000 --cols 100 --id-overlap 0.1 --tag ov10pct
Execução:
uv run python benchmarks/run.py data/1000000_50cols_div1pct
uv run python benchmarks/run.py data/30000000_50cols_div1pct --engines hash,hash_windows --repeats 2 --window-rows 5_000_000
uv run python benchmarks/run.py data/5000000_100cols_div1pct --engines hash_windows --repeats 2 --window-rows 100_000 --min-free-gb 0
# com e sem common_keys_only (sufixo _common) em ids pouco sobrepostos
uv run python benchmarks/run.py data/5000000_100cols_ov10pct --engines hash,hash_common --repeats 2
Benchmark final padronizado (todas as engines em toda a grade, numa suíte nova; falhas já conhecidas são puladas):
uv run python benchmarks/final_benchmark.py             # grade completa + gráficos e summary.md (várias horas)
uv run python benchmarks/final_benchmark.py --dry-run   # só mostra os comandos
Os resultados vão para benchmarks/results/final_version/; para publicá-los, copie os PNGs, o summary.md e os dados para docs/benchmarks/.
Licença
Distribuído sob a Apache License 2.0.
1 maintainer

Metadata
1 maintainer
Release files for datacompolars 0.4.3
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | Provenance | Actions |
|---|---|---|---|---|
| datacompolars-0.4.3.tar.gz | 50.3 kB | Without provenance | Details for datacompolars-0.4.3.tar.gz |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Actions Reset |
|---|---|---|---|---|
| datacompolars-0.4.3-py3-none-any.whl | Python 3 | none | any | Details for datacompolars-0.4.3-py3-none-any.whl |
Total release size: 97.2 kB
Release files / datacompolars-0.4.3.tar.gz
| Download URL | datacompolars-0.4.3.tar.gz |
|---|---|
| Size | 50.3 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
b9aad3b5cea1671532277343da0bc59aa72764dbb7b66183c5eb58ae34b152b7
|
|
BLAKE2b-256 checksum How to use checksums |
6b1feeed45364edc53feb8cda1aeb2947aa321bd8ef56cf98e85bff53d3f5f02
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
uv/0.11.26 {"installer":{"name":"uv","version":"0.11.26","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":null,"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":null}
|
Release files / datacompolars-0.4.3-py3-none-any.whl
| Download URL | datacompolars-0.4.3-py3-none-any.whl |
|---|---|
| Size | 47.0 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
657506ced00a926eb899f5316b6a7289f23777d43a4134faad13200d856065bd
|
|
BLAKE2b-256 checksum How to use checksums |
98aba91e6a3b4af3b23509aa1ac9dc2fcfbfc3bb4c7ada20ad23f802b6500650
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
uv/0.11.26 {"installer":{"name":"uv","version":"0.11.26","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":null,"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":null}
|
Security for datacompolars 0.4.3
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
No provenance found
None of the files in this release were uploaded with provenance metadata.
A note on package security
PyPI is a repository for distributing packages, not a service for auditing them. While third-party security researchers and our staff do their best to detect and remove malicious packages, PyPI cannot guarantee the quality, security or suitability of any given package.
To learn more about protecting yourself from malicious actors, visit our package security documentation.














