
EvalRag


Composable RAG evaluation library. Build experiments by plugging together extractors, chunkers, embedders, retrievers, generators, and evaluators — then compare results across configurations.
- Composable pipeline — swap extractors, chunkers, embedders, retrievers, generators, evaluators like LEGO
- Hybrid search proving ground — built-in demo shows BM25+Vector outperforms either alone (+21% F1 lift)
- Interactive HTML reports — F1 scorecards, D3 charts, light/dark mode, timestamped exports
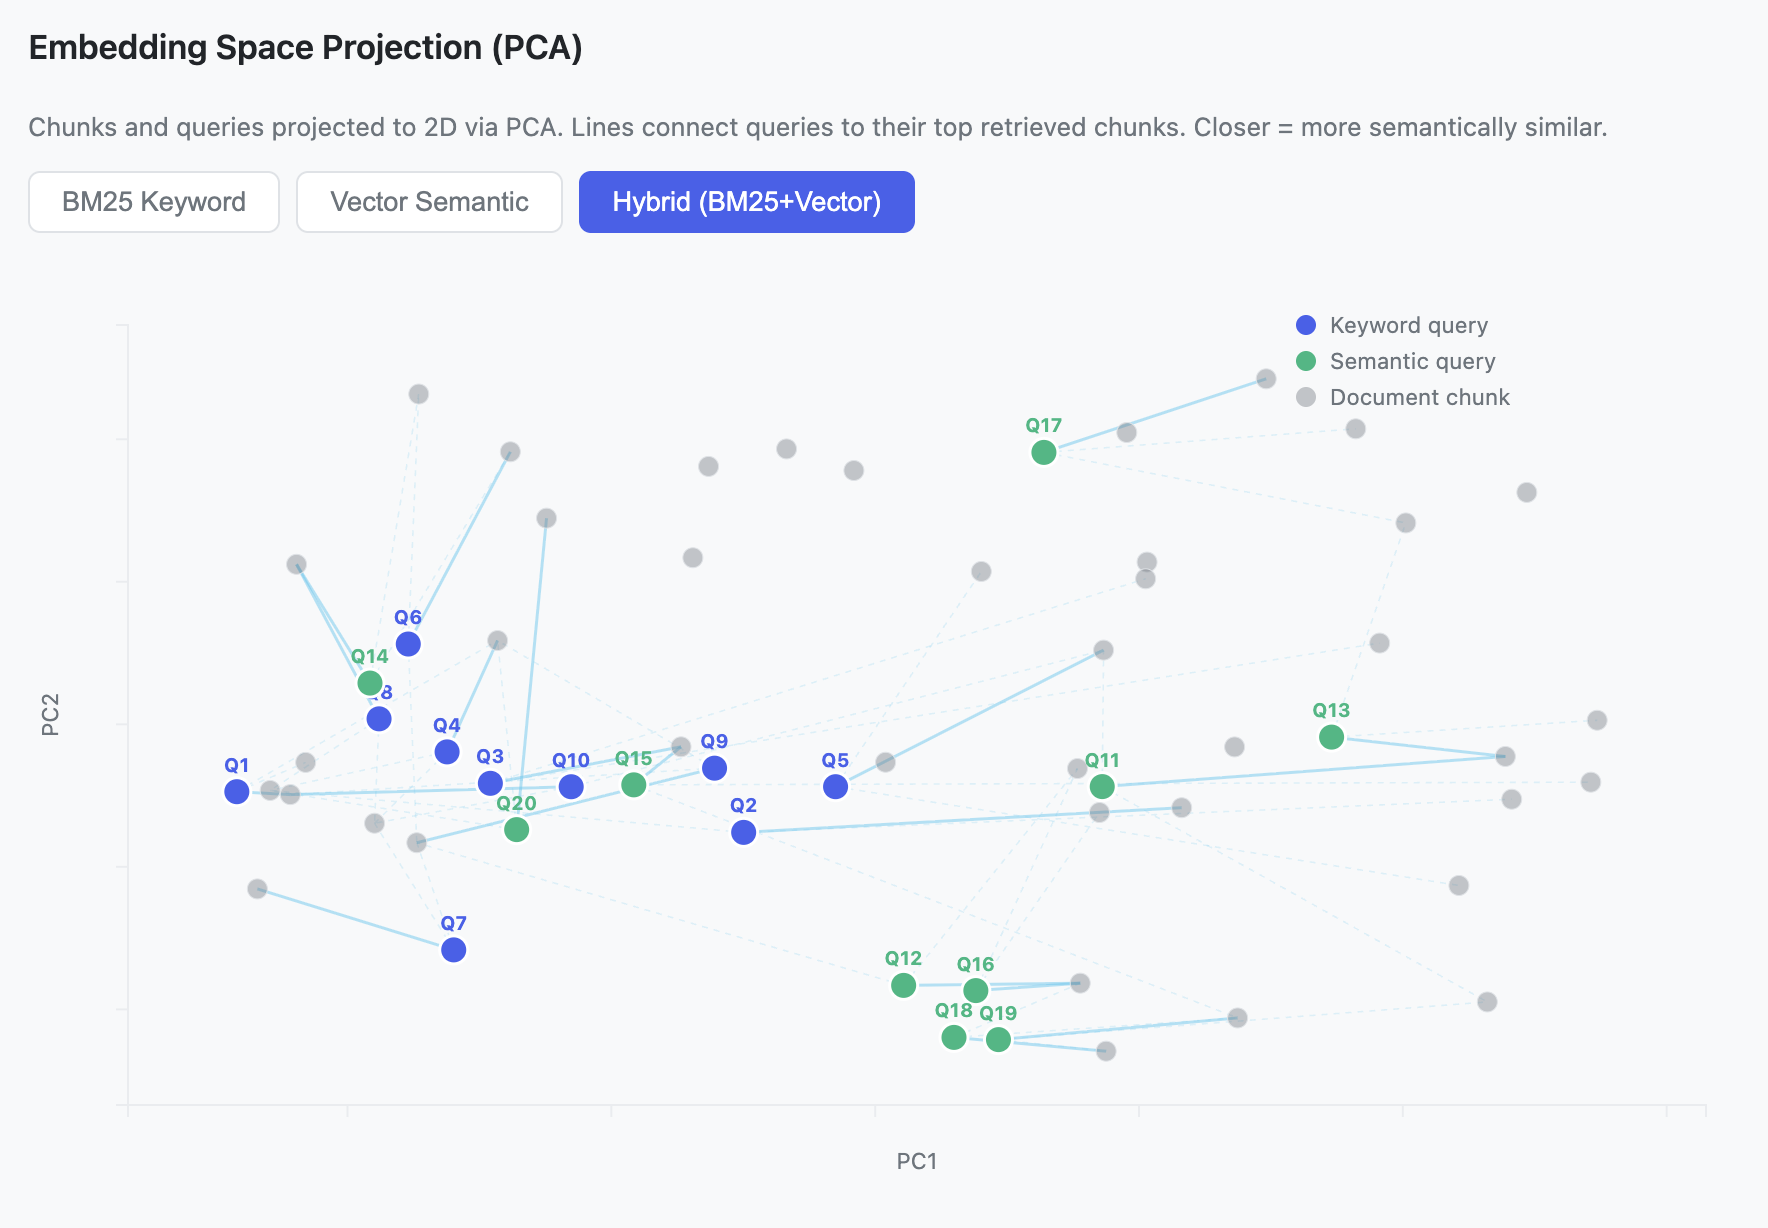
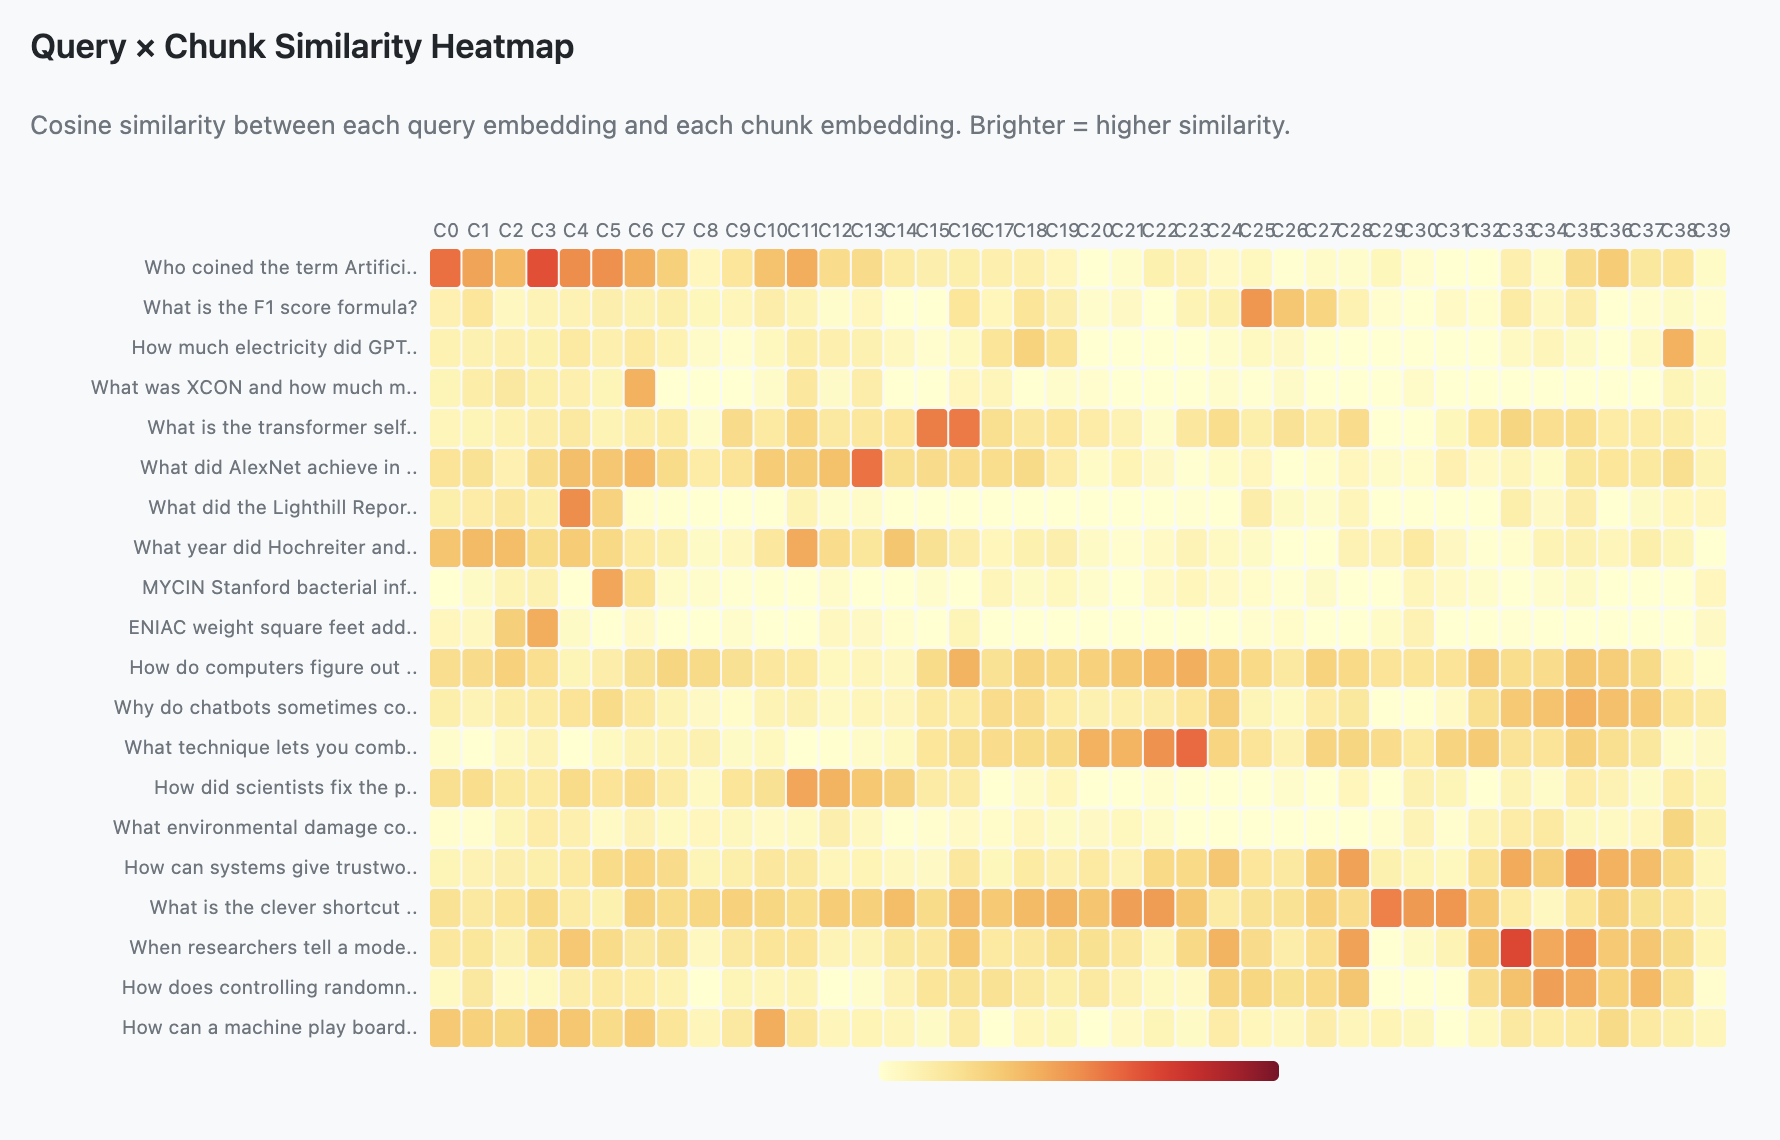
- Embedding space visualizations — PCA scatter plot with retrieval edges + cosine similarity heatmap
- Local or cloud models — run fully local with SentenceTransformers + Ollama (no API keys), or plug in cloud providers like OpenAI
- Zero-config hello world — one command, full experiment, publication-ready report
- Pure Python BM25 — no native dependencies, no numpy
- 20 metrics out of the box — F1, Precision, Recall, MRR, MAP at configurable k values
Install
pip install evalragkit                  # core only
pip install evalragkit[chromadb,openai] # with ChromaDB + OpenAI
pip install evalragkit[all]             # everything
Quickstart
from evalragkit.extractors.unstructured import PlainTextExtractor
from evalragkit.chunkers.token import TokenChunker
from evalragkit.embedders.openai import OpenAIEmbedder
from evalragkit.stores.chromadb import ChromaDBStore
from evalragkit.retrievers.vector import VectorRetriever
from evalragkit.generators.openai import OpenAIGenerator
from evalragkit.evaluators.ragas import RagasEvaluator
from evalragkit.core.experiment import Experiment, QAPair

# wire up the pipeline
extractor = PlainTextExtractor()
chunker = TokenChunker(chunk_size=500, chunk_overlap=50)
embedder = OpenAIEmbedder()
store = ChromaDBStore()
retriever = VectorRetriever(embedder=embedder, store=store)
generator = OpenAIGenerator()
evaluator = RagasEvaluator()

exp = Experiment(
    name="baseline",
    extractor=extractor,
    chunker=chunker,
    embedder=embedder,
    store=store,
    retriever=retriever,
    generator=generator,
    evaluator=evaluator,
)

# ingest documents
exp.ingest("docs/my_knowledge_base.txt")

# evaluate
dataset = [
    QAPair(question="What is RAG?", ground_truth="RAG combines retrieval with generation."),
]
result = exp.run(dataset)

print(result.mean_scores)
# {'faithfulness': 0.92, 'answer_relevancy': 0.88, ...}

Experiment.save_result(result, "results/baseline.json")
Swap components
from evalragkit.retrievers.keyword import BM25Retriever
from evalragkit.retrievers.hybrid import HybridRetriever

keyword = BM25Retriever()
keyword.add(chunks)  # chunks from ingest

hybrid = HybridRetriever(retrievers=[retriever, keyword], weights=[0.7, 0.3])
Ranking evaluation
from evalragkit.ranking.metrics import RankingEvaluator

ranker = RankingEvaluator(k_values=[1, 3, 5, 10])
results = ranker.rank(
    queries=["What is RAG?"],
    retrievals=[["doc1", "doc2", "doc3"]],
    relevance=[{"doc1", "doc3"}],
)
for r in results:
    print(f"{r.metric}: {r.value:.3f}")
Hello World — Hybrid vs BM25 vs Vector
Run the built-in demo that proves hybrid search outperforms either approach alone:
PYTHONPATH=src python experiments/hello_world/run.py
Generates a timestamped interactive HTML report with F1 scorecards, D3 charts, PCA embedding scatter plot, and cosine similarity heatmap. See the demo report for sample output.
To create your own experiment, duplicate the experiments/hello_world/ folder or start from experiments/template.py.
Docs
- LLM Agent Guide — comprehensive guide for AI coding agents
- Functional Requirements — FR01–FR13
- Architecture ADR
Compare experiments
from evalragkit.exploration.reporter import Reporter

table = Reporter.to_table([result_a, result_b])
print(table)
CLI
evalragkit run experiment.json --output results.json
evalragkit compare results_a.json results_b.json
evalragkit datasets
evalragkit download sample
Architecture
Strategy + Composition pattern. Every pipeline stage is a Python Protocol — implement the interface and plug it in. No base classes, no registration required.
| Stage | Protocol | Built-in implementations |
|---|---|---|
| Extract | Extractor |
PlainTextExtractor, UnstructuredExtractor, OCRExtractor |
| Chunk | Chunker |
TokenChunker |
| Embed | Embedder |
SentenceTransformerEmbedder, OpenAIEmbedder, OllamaEmbedder |
| Store | Store |
ChromaDBStore |
| Retrieve | Retriever |
VectorRetriever, BM25Retriever, HybridRetriever |
| Generate | Generator |
OpenAIGenerator, OllamaGenerator |
| Evaluate | Evaluator |
RagasEvaluator |
| Rank | Ranker |
RankingEvaluator |
License
MIT
1 maintainer

Metadata
1 maintainer
Release files for evalragkit 0.0.20260707040144
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | Provenance | Actions |
|---|---|---|---|---|
| evalragkit-0.0.20260707040144.tar.gz | 1.3 MB | Without provenance | Details for evalragkit-0.0.20260707040144.tar.gz |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Actions Reset |
|---|---|---|---|---|
| evalragkit-0.0.20260707040144-py3-none-any.whl | Python 3 | none | any | Details for evalragkit-0.0.20260707040144-py3-none-any.whl |
Total release size: 1.4 MB
Release files / evalragkit-0.0.20260707040144.tar.gz
| Download URL | evalragkit-0.0.20260707040144.tar.gz |
|---|---|
| Size | 1.3 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
5cedb2d7731af3fa4b827eae7852ec5c319a7c7b37fb158c5de0060faa52926c
|
|
BLAKE2b-256 checksum How to use checksums |
b0a619f9b6aee8a69bbeb0e01c0876b4d5515067234d1b4978134d087e7d74a6
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
uv/0.4.20
|
Release files / evalragkit-0.0.20260707040144-py3-none-any.whl
| Download URL | evalragkit-0.0.20260707040144-py3-none-any.whl |
|---|---|
| Size | 36.0 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
d593ebd633e64a3c59d55e9f41280ab9cf8b19af2e224304cc9b14cb84cf3995
|
|
BLAKE2b-256 checksum How to use checksums |
f4d5434d666c6670ad3aadac316e75f440f73704595ae6c3f018b1d4c27743f2
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
uv/0.4.20
|
Security for evalragkit 0.0.20260707040144
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
No provenance found
None of the files in this release were uploaded with provenance metadata.
A note on package security
PyPI is a repository for distributing packages, not a service for auditing them. While third-party security researchers and our staff do their best to detect and remove malicious packages, PyPI cannot guarantee the quality, security or suitability of any given package.
To learn more about protecting yourself from malicious actors, visit our package security documentation.













