
hscredit



面向信贷风控的全流程量化工具箱
🔍 鉴真伪 · 📊 斟信用 · ⚖️ 衡风险 · 🎯 枢定策
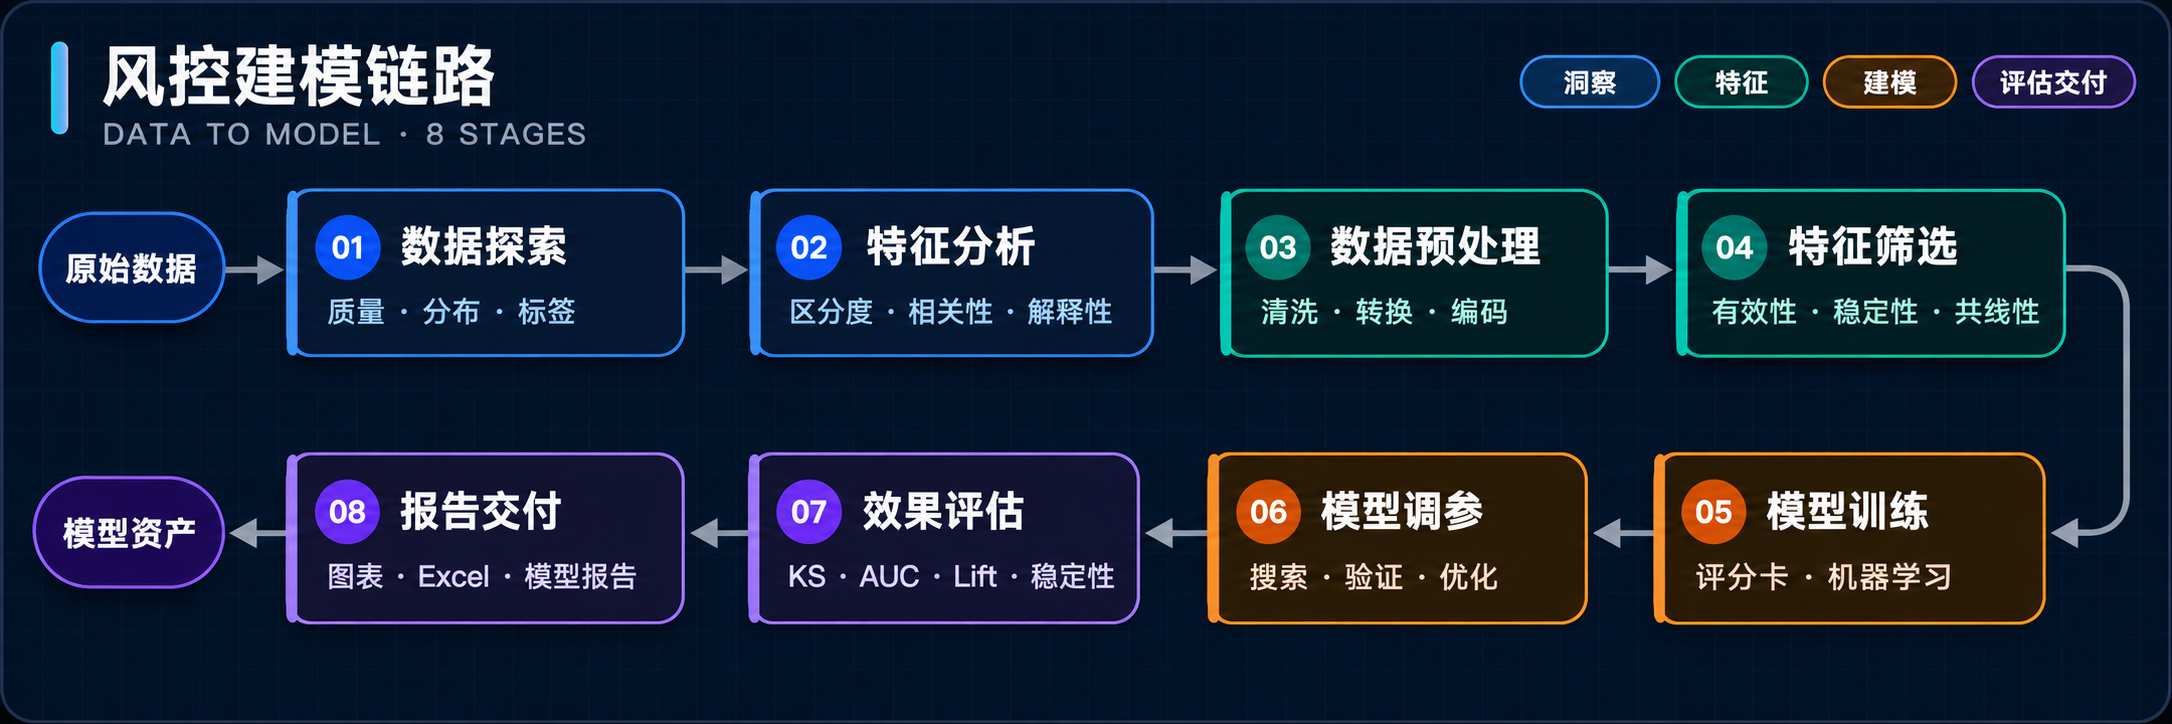
hscredit(衡枢真信)将数据探索、分箱编码、特征筛选、评分卡与机器学习、规则分析和 Excel 报告串成一套工作流。分箱、编码和筛选组件兼容 sklearn Pipeline,分析结果以中文指标、表格和图表返回。
为什么选择 hscredit · 功能模块 · 安装 · 功能演示 · 在线文档
为什么选择 hscredit
- 面向信贷业务。 在同一套分析中处理逾期标签、灰客户、金额口径、账龄、客群和规则置换,减少分析与报告之间的重复计算。
- 贯通变量、模型与策略。 从 EDA、分箱编码、组合筛选到逻辑回归、评分卡、集成模型和规则挖掘,复用相同的指标与报告入口。
- 兼容现有建模流程。 分箱、编码、筛选等组件遵循 sklearn 接口;既支持
fit(X, y),也可用target指定 DataFrame 中的标签列。 - 保留过程,便于复盘。 可查看筛选决策、模型统计、试验指标、Pareto 候选、SHAP 解释和规则效果,并保存模型与训练记录。
- 分析结果直接交付。 方法返回的 DataFrame、原生图表和多 Sheet Excel 可继续用于评审、监控和归档,支持百分比、条件格式、冻结窗格、超链接与透视表。
核心功能模块
| 模块 | 具体功能点 | 演示 |
|---|---|---|
| 数据探索 EDA | 数据质量、缺失与分布、IV/KS/PSI、跨期稳定性、客群、Vintage、Roll Rate、自动特征报告 | EDA |
| 分箱与编码 | 等频、等宽、卡方、树/CART、Best IV/KS/Lift、单调、二维分箱;WOE、Target、Count、OneHot 等编码 | 分箱对比与指标 |
| 分箱可视化 | 单变量分箱、二维交互、跨月趋势、多 DPD 风险、手工与自动分箱效率对比 | 四类分箱图 |
| 特征筛选 | 缺失率、集中度、IV、KS、PSI、相关性、VIF、模型重要性、RFE、Boruta、组合筛选及完整过程报告 | 组合筛选 |
| 逻辑回归 | 系数、标准误、显著性、置信区间、VIF、权重误差图 | 逻辑回归 |
| 评分卡 | WOE 转换、基础分/基准 odds/PDO 配置、完整 points 表、评分分布、保存与 PMML 导出 | 评分卡 |
| 规则评估 | Rule 逻辑组合、先验规则、规则集、多标签金额评估、Swap 置入置出、策略迭代报告 |
规则与策略 |
| 规则挖掘 | 单变量、多变量、多标签、树规则提取;自动训练与人工干预决策树 | 手工树 |
| 模型训练 | RandomForest、ExtraTrees、GradientBoosting、XGBoost、LightGBM、CatBoost、NGBoost、校准、自定义损失与完整评估 | 模型与报告 |
| 超参数搜索 | 多框架空间声明适配、单/多目标 CV、剪枝、Pareto、试验复盘、Optuna Dashboard | 搜索与训练过程 |
| 模型可解释性 | 全局重要性、SHAP 分布与依赖、单样本贡献、原因码与反事实分析 | 模型解释 |
| 报告与 Excel | 自动变量/模型/策略报告、DataFrame 导出、自动列宽、数字格式、图片、条件格式、冻结、超链接、透视表 | Excel |
| 数据接入与计算 | SQL / NoSQL 连接池、流式读写、表结构导出;表达式衍生、现金流与金融计算 | 数据库 · 特征工程 · 金融计算 |
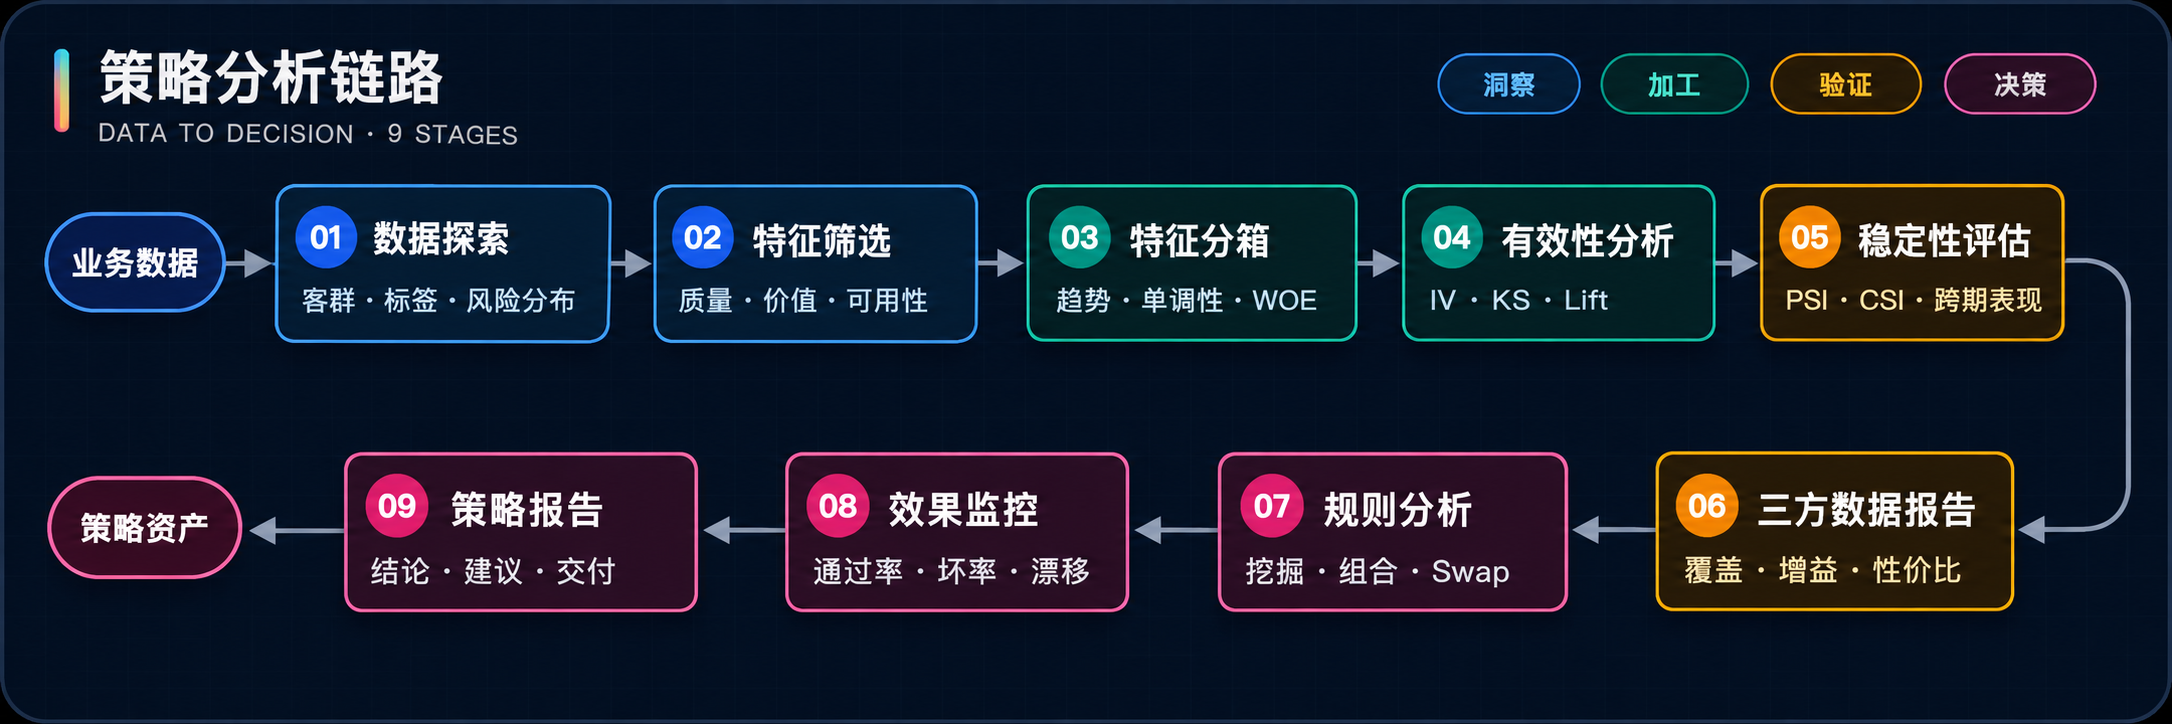
查看建模与策略分析流程
安装
支持 Python 3.9–3.14。
pip install hscredit
基础安装包含分箱、编码、筛选、评分卡、经典模型、SHAP 解释、可视化与 Excel 报告。其他能力按需安装:
| 安装命令 | 能力 |
|---|---|
pip install "hscredit[boost]" |
XGBoost、LightGBM、CatBoost、NGBoost |
pip install "hscredit[tune]" |
Optuna 调参、搜索空间与调参看板 |
pip install "hscredit[net]" |
PyTorch、TabNet |
pip install "hscredit[pmml]" |
PMML 导出与加载 |
pip install "hscredit[database-all]" |
全部数据库与 NoSQL 适配器 |
pip install "hscredit[all]" |
上述所有依赖安装 |
数据库驱动也可单独安装,例如 hscredit[db-mysql]、hscredit[db-clickhouse]。全部选项见安装指南,连接池、流式读写和表结构导出见数据库指南。
核心功能演示
分箱评估 · 分箱图 · EDA · 筛选 · 逻辑回归 · 评分卡 · 规则评估 · 手工树 · 模型训练 · 超参数搜索 · 模型解释 · Excel
以下演示使用本地真实放款工作簿 examples/hscredit_yyp.xlsx,该文件不随仓库和安装包分发。替换路径及字段名即可使用自己的数据;无需本地工作簿的入门流程见快速开始 Notebook。
图表由 API 直接生成,保留方法原生格式。表格保留完整返回字段和多级表头;Excel 截图展示整张返回表,宽表可点击原图或下载工作簿查看。导出参数使用 auto_width=True,比例字段配置百分比,评估指标配置条件格式。
公共数据准备:在仓库根目录运行,后续示例共用这些变量
from pathlib import Path

import hscredit
import pandas as pd
from IPython.display import display
from sklearn.model_selection import train_test_split
from hscredit.core.viz import bin_plot, bin_2d_plot, bin_trend_plot, bin_overdues_plot
from hscredit.report import (
    feature_bin_stats, feature_binning_summary, feature_group_binning_summary,
    feature_efficiency_analysis, auto_feature_analysis,
)

df = pd.read_excel("examples/hscredit_yyp.xlsx")
features = ["衡枢鉴真分老客版", "近六个月非银多头机构数", "手机号近一个月非银多头机构数"]
X, y = df[features], df["FPD"]
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42,
)
train_df = df.loc[X_train.index]
test_df = df.loc[X_test.index]

ASSET_DIR = Path("docs/assets/readme/binning-eda")
strategy_dir = Path("docs/assets/readme/strategy")
model_assets = Path("docs/assets/readme/models")
for directory in (ASSET_DIR, strategy_dir, model_assets):
    directory.mkdir(parents=True, exist_ok=True)
1. 分箱方法对比与指标评估
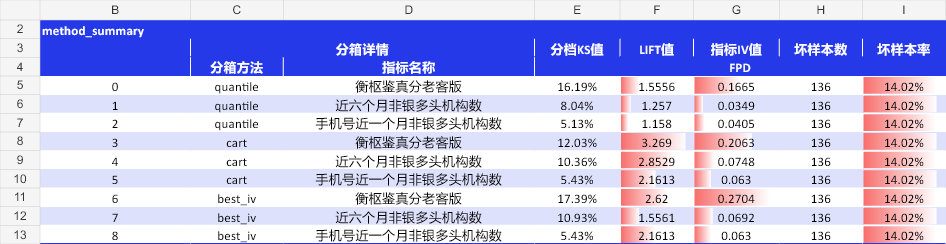
不同分箱方法:完整分箱明细与 KS、Lift、IV 评估
在相同数据、目标和最大箱数下比较等频、CART 和最优 IV;summary 的指标聚合由 feature_binning_summary 原生完成。
method_tables, method_summary = feature_binning_summary(
    df, feature=features, methods=["quantile", "cart", "best_iv"],
    target="FPD", max_n_bins=4, margins=True, random_state=42, n_jobs=1,
)
display(method_summary)
method_summary.save(
    str(ASSET_DIR / "method-summary.xlsx"), index=True, auto_width=True,
    percent_cols=[("分档KS值", "FPD"), ("坏样本率", "FPD")],
    condition_cols=[("LIFT值", "FPD"), ("指标IV值", "FPD")],
)
for feature_name, by_method in method_tables.items():
    for method_name, table in by_method.items():
        print(feature_name, method_name)
        display(table)
查看所有完整返回表与 Excel
method_summary:9 行 × 7 列;完整 HTML · Excel:原始表1method_tables/衡枢鉴真分老客版/quantile:5 行 × 22 列;完整 HTML · Excel:原始表2method_tables/衡枢鉴真分老客版/cart:5 行 × 22 列;完整 HTML · Excel:原始表3method_tables/衡枢鉴真分老客版/best_iv:5 行 × 22 列;完整 HTML · Excel:原始表4method_tables/近六个月非银多头机构数/quantile:5 行 × 22 列;完整 HTML · Excel:原始表5method_tables/近六个月非银多头机构数/cart:5 行 × 22 列;完整 HTML · Excel:原始表6method_tables/近六个月非银多头机构数/best_iv:4 行 × 22 列;完整 HTML · Excel:原始表7method_tables/手机号近一个月非银多头机构数/quantile:5 行 × 22 列;完整 HTML · Excel:原始表8method_tables/手机号近一个月非银多头机构数/cart:5 行 × 22 列;完整 HTML · Excel:原始表9method_tables/手机号近一个月非银多头机构数/best_iv:5 行 × 22 列;完整 HTML · Excel:原始表10
feature_bin_stats:多标签、金额口径与类别特征
MOB1 与 7、3、0 三个阈值在同一次调用中展开;amount 加入放款金额口径,margins=True 保留方法生成的合计。
multi_dpd_table = feature_bin_stats(
    df, feature=features, overdue=["MOB1"], dpds=[7, 3, 0],
    amount="放款金额", method="quantile", max_n_bins=4, margins=True, n_jobs=1,
)
category_table = feature_bin_stats(
    df, feature="商品类别", target="FPD", method="quantile",
    max_n_bins=4, margins=True, n_jobs=1,
)
display(multi_dpd_table)
display(category_table)

查看所有完整返回表与 Excel
multi_dpd_table:13 行 × 56 列;完整 HTML · Excel:原始表1category_table:3 行 × 22 列;完整 HTML · Excel:原始表2
feature_group_binning_summary:跨月份与商品类别比较
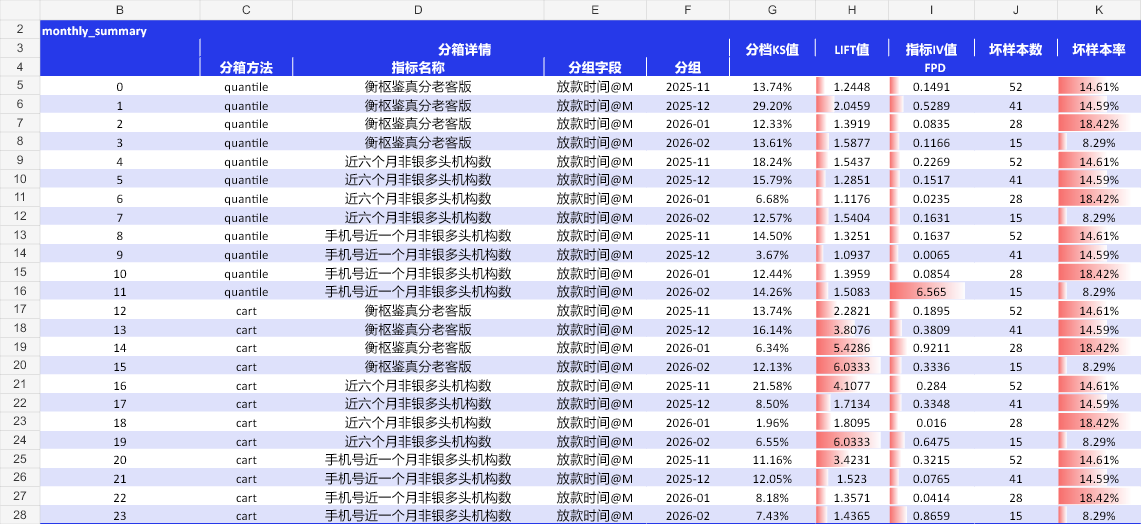
同一特征和方法在全量数据上拟合一次,各月份或商品类别复用切点,完整返回每组明细与汇总。
monthly_tables, monthly_summary = feature_group_binning_summary(
    df, feature=features, methods=["quantile", "cart"],
    date_col="放款时间", freq="M", target="FPD",
    max_n_bins=4, margins=True, random_state=42, n_jobs=1,
)
category_tables, category_summary = feature_group_binning_summary(
    df, feature=features, methods="quantile", group_col="商品类别", target="FPD",
    max_n_bins=4, margins=True, n_jobs=1,
)
display(monthly_summary)
display(category_summary)
for grouped_result in (monthly_tables, category_tables):
    for feature_name, by_method in grouped_result.items():
        for method_name, by_group in by_method.items():
            for group_name, table in by_group.items():
                print(feature_name, method_name, group_name)
                display(table)
查看所有完整返回表与 Excel
monthly_summary:24 行 × 9 列;完整 HTML · Excel:原始表1category_summary:18 行 × 9 列;完整 HTML · Excel:原始表2monthly_tables/衡枢鉴真分老客版/quantile/2025-11:5 行 × 22 列;完整 HTML · Excel:原始表3monthly_tables/衡枢鉴真分老客版/quantile/2025-12:5 行 × 22 列;完整 HTML · Excel:原始表4monthly_tables/衡枢鉴真分老客版/quantile/2026-01:5 行 × 22 列;完整 HTML · Excel:原始表5monthly_tables/衡枢鉴真分老客版/quantile/2026-02:5 行 × 22 列;完整 HTML · Excel:原始表6monthly_tables/衡枢鉴真分老客版/cart/2025-11:5 行 × 22 列;完整 HTML · Excel:原始表7monthly_tables/衡枢鉴真分老客版/cart/2025-12:5 行 × 22 列;完整 HTML · Excel:原始表8monthly_tables/衡枢鉴真分老客版/cart/2026-01:5 行 × 22 列;完整 HTML · Excel:原始表9monthly_tables/衡枢鉴真分老客版/cart/2026-02:5 行 × 22 列;完整 HTML · Excel:原始表10monthly_tables/近六个月非银多头机构数/quantile/2025-11:5 行 × 22 列;完整 HTML · Excel:原始表11monthly_tables/近六个月非银多头机构数/quantile/2025-12:5 行 × 22 列;完整 HTML · Excel:原始表12monthly_tables/近六个月非银多头机构数/quantile/2026-01:5 行 × 22 列;完整 HTML · Excel:原始表13monthly_tables/近六个月非银多头机构数/quantile/2026-02:5 行 × 22 列;完整 HTML · Excel:原始表14monthly_tables/近六个月非银多头机构数/cart/2025-11:5 行 × 22 列;完整 HTML · Excel:原始表15monthly_tables/近六个月非银多头机构数/cart/2025-12:5 行 × 22 列;完整 HTML · Excel:原始表16monthly_tables/近六个月非银多头机构数/cart/2026-01:4 行 × 22 列;完整 HTML · Excel:原始表17monthly_tables/近六个月非银多头机构数/cart/2026-02:5 行 × 22 列;完整 HTML · Excel:原始表18monthly_tables/手机号近一个月非银多头机构数/quantile/2025-11:5 行 × 22 列;完整 HTML · Excel:原始表19monthly_tables/手机号近一个月非银多头机构数/quantile/2025-12:5 行 × 22 列;完整 HTML · Excel:原始表20monthly_tables/手机号近一个月非银多头机构数/quantile/2026-01:5 行 × 22 列;完整 HTML · Excel:原始表21monthly_tables/手机号近一个月非银多头机构数/quantile/2026-02:5 行 × 22 列;完整 HTML · Excel:原始表22monthly_tables/手机号近一个月非银多头机构数/cart/2025-11:5 行 × 22 列;完整 HTML · Excel:原始表23monthly_tables/手机号近一个月非银多头机构数/cart/2025-12:5 行 × 22 列;完整 HTML · Excel:原始表24monthly_tables/手机号近一个月非银多头机构数/cart/2026-01:5 行 × 22 列;完整 HTML · Excel:原始表25monthly_tables/手机号近一个月非银多头机构数/cart/2026-02:5 行 × 22 列;完整 HTML · Excel:原始表26category_tables/衡枢鉴真分老客版/quantile/家用电器:2 行 × 22 列;完整 HTML · Excel:原始表27category_tables/衡枢鉴真分老客版/quantile/手机通讯:5 行 × 22 列;完整 HTML · Excel:原始表28category_tables/衡枢鉴真分老客版/quantile/智能设备:4 行 × 22 列;完整 HTML · Excel:原始表29category_tables/衡枢鉴真分老客版/quantile/珠宝首饰:5 行 × 22 列;完整 HTML · Excel:原始表30category_tables/衡枢鉴真分老客版/quantile/电脑数码:5 行 × 22 列;完整 HTML · Excel:原始表31category_tables/衡枢鉴真分老客版/quantile/礼包:5 行 × 22 列;完整 HTML · Excel:原始表32category_tables/近六个月非银多头机构数/quantile/家用电器:2 行 × 22 列;完整 HTML · Excel:原始表33category_tables/近六个月非银多头机构数/quantile/手机通讯:5 行 × 22 列;完整 HTML · Excel:原始表34category_tables/近六个月非银多头机构数/quantile/智能设备:5 行 × 22 列;完整 HTML · Excel:原始表35category_tables/近六个月非银多头机构数/quantile/珠宝首饰:5 行 × 22 列;完整 HTML · Excel:原始表36category_tables/近六个月非银多头机构数/quantile/电脑数码:5 行 × 22 列;完整 HTML · Excel:原始表37category_tables/近六个月非银多头机构数/quantile/礼包:5 行 × 22 列;完整 HTML · Excel:原始表38category_tables/手机号近一个月非银多头机构数/quantile/家用电器:2 行 × 22 列;完整 HTML · Excel:原始表39category_tables/手机号近一个月非银多头机构数/quantile/手机通讯:5 行 × 22 列;完整 HTML · Excel:原始表40category_tables/手机号近一个月非银多头机构数/quantile/智能设备:4 行 × 22 列;完整 HTML · Excel:原始表41category_tables/手机号近一个月非银多头机构数/quantile/珠宝首饰:5 行 × 22 列;完整 HTML · Excel:原始表42category_tables/手机号近一个月非银多头机构数/quantile/电脑数码:5 行 × 22 列;完整 HTML · Excel:原始表43category_tables/手机号近一个月非银多头机构数/quantile/礼包:5 行 × 22 列;完整 HTML · Excel:原始表44
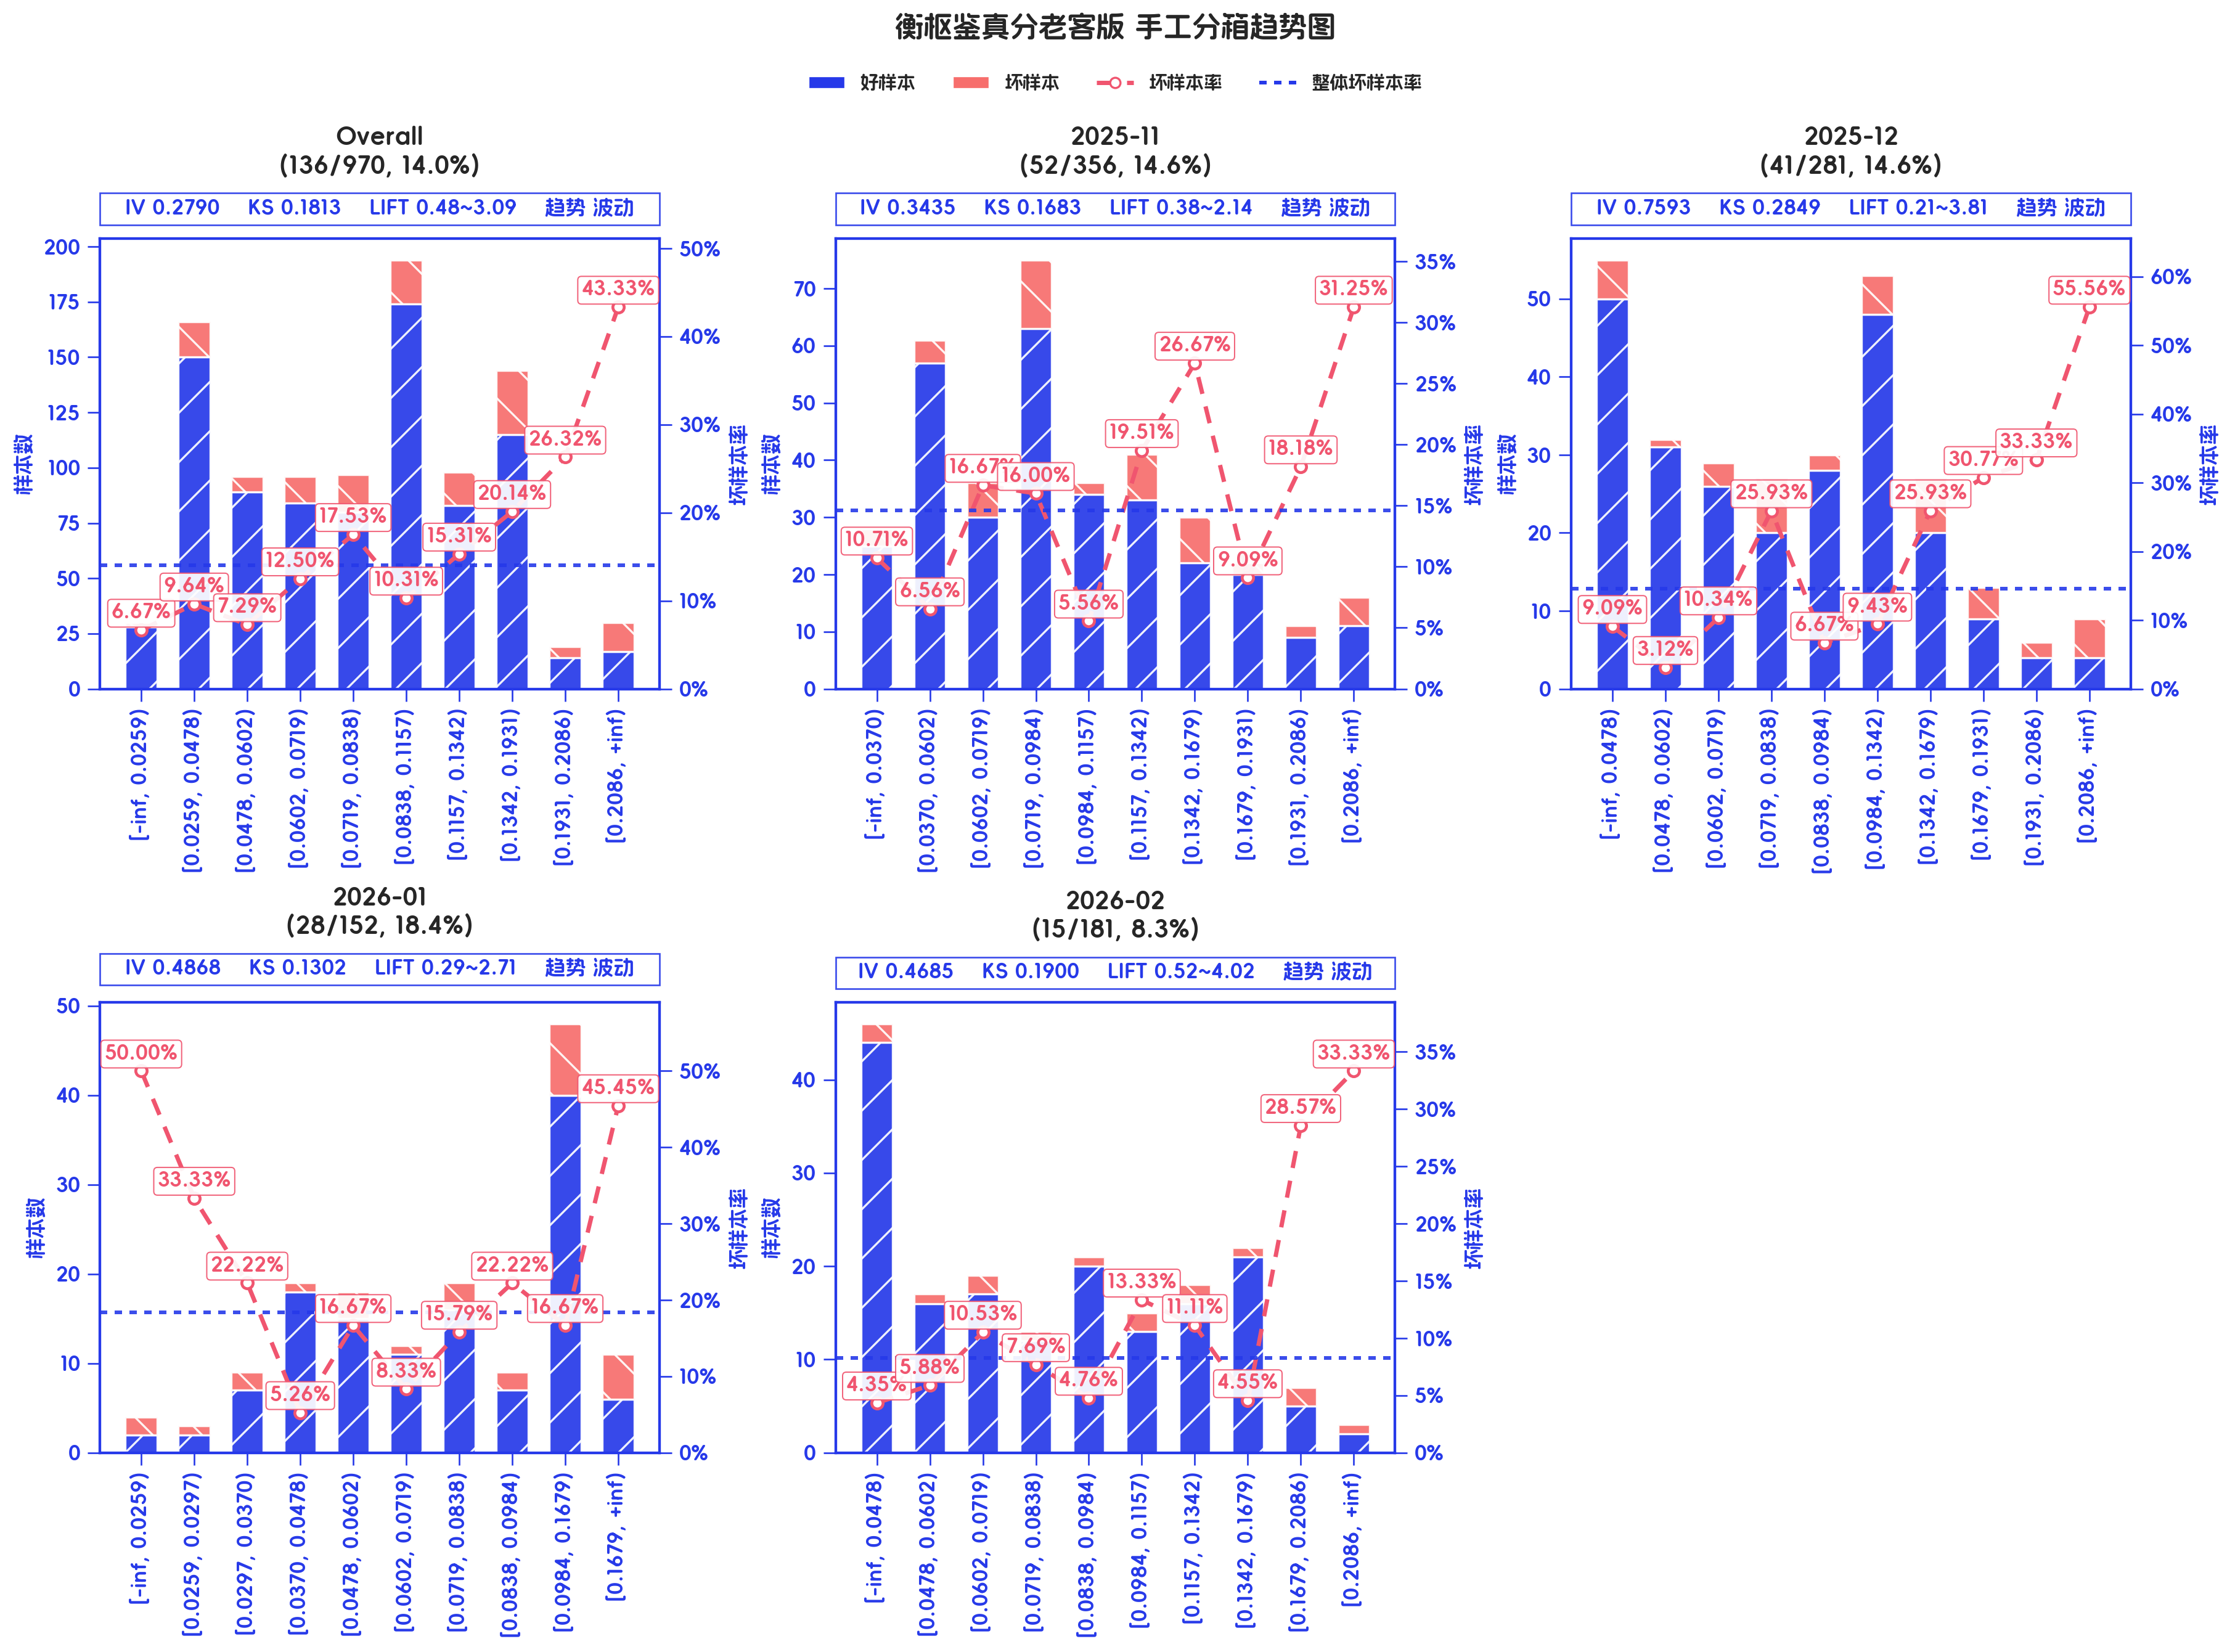
feature_efficiency_analysis:手工与自动分箱效率
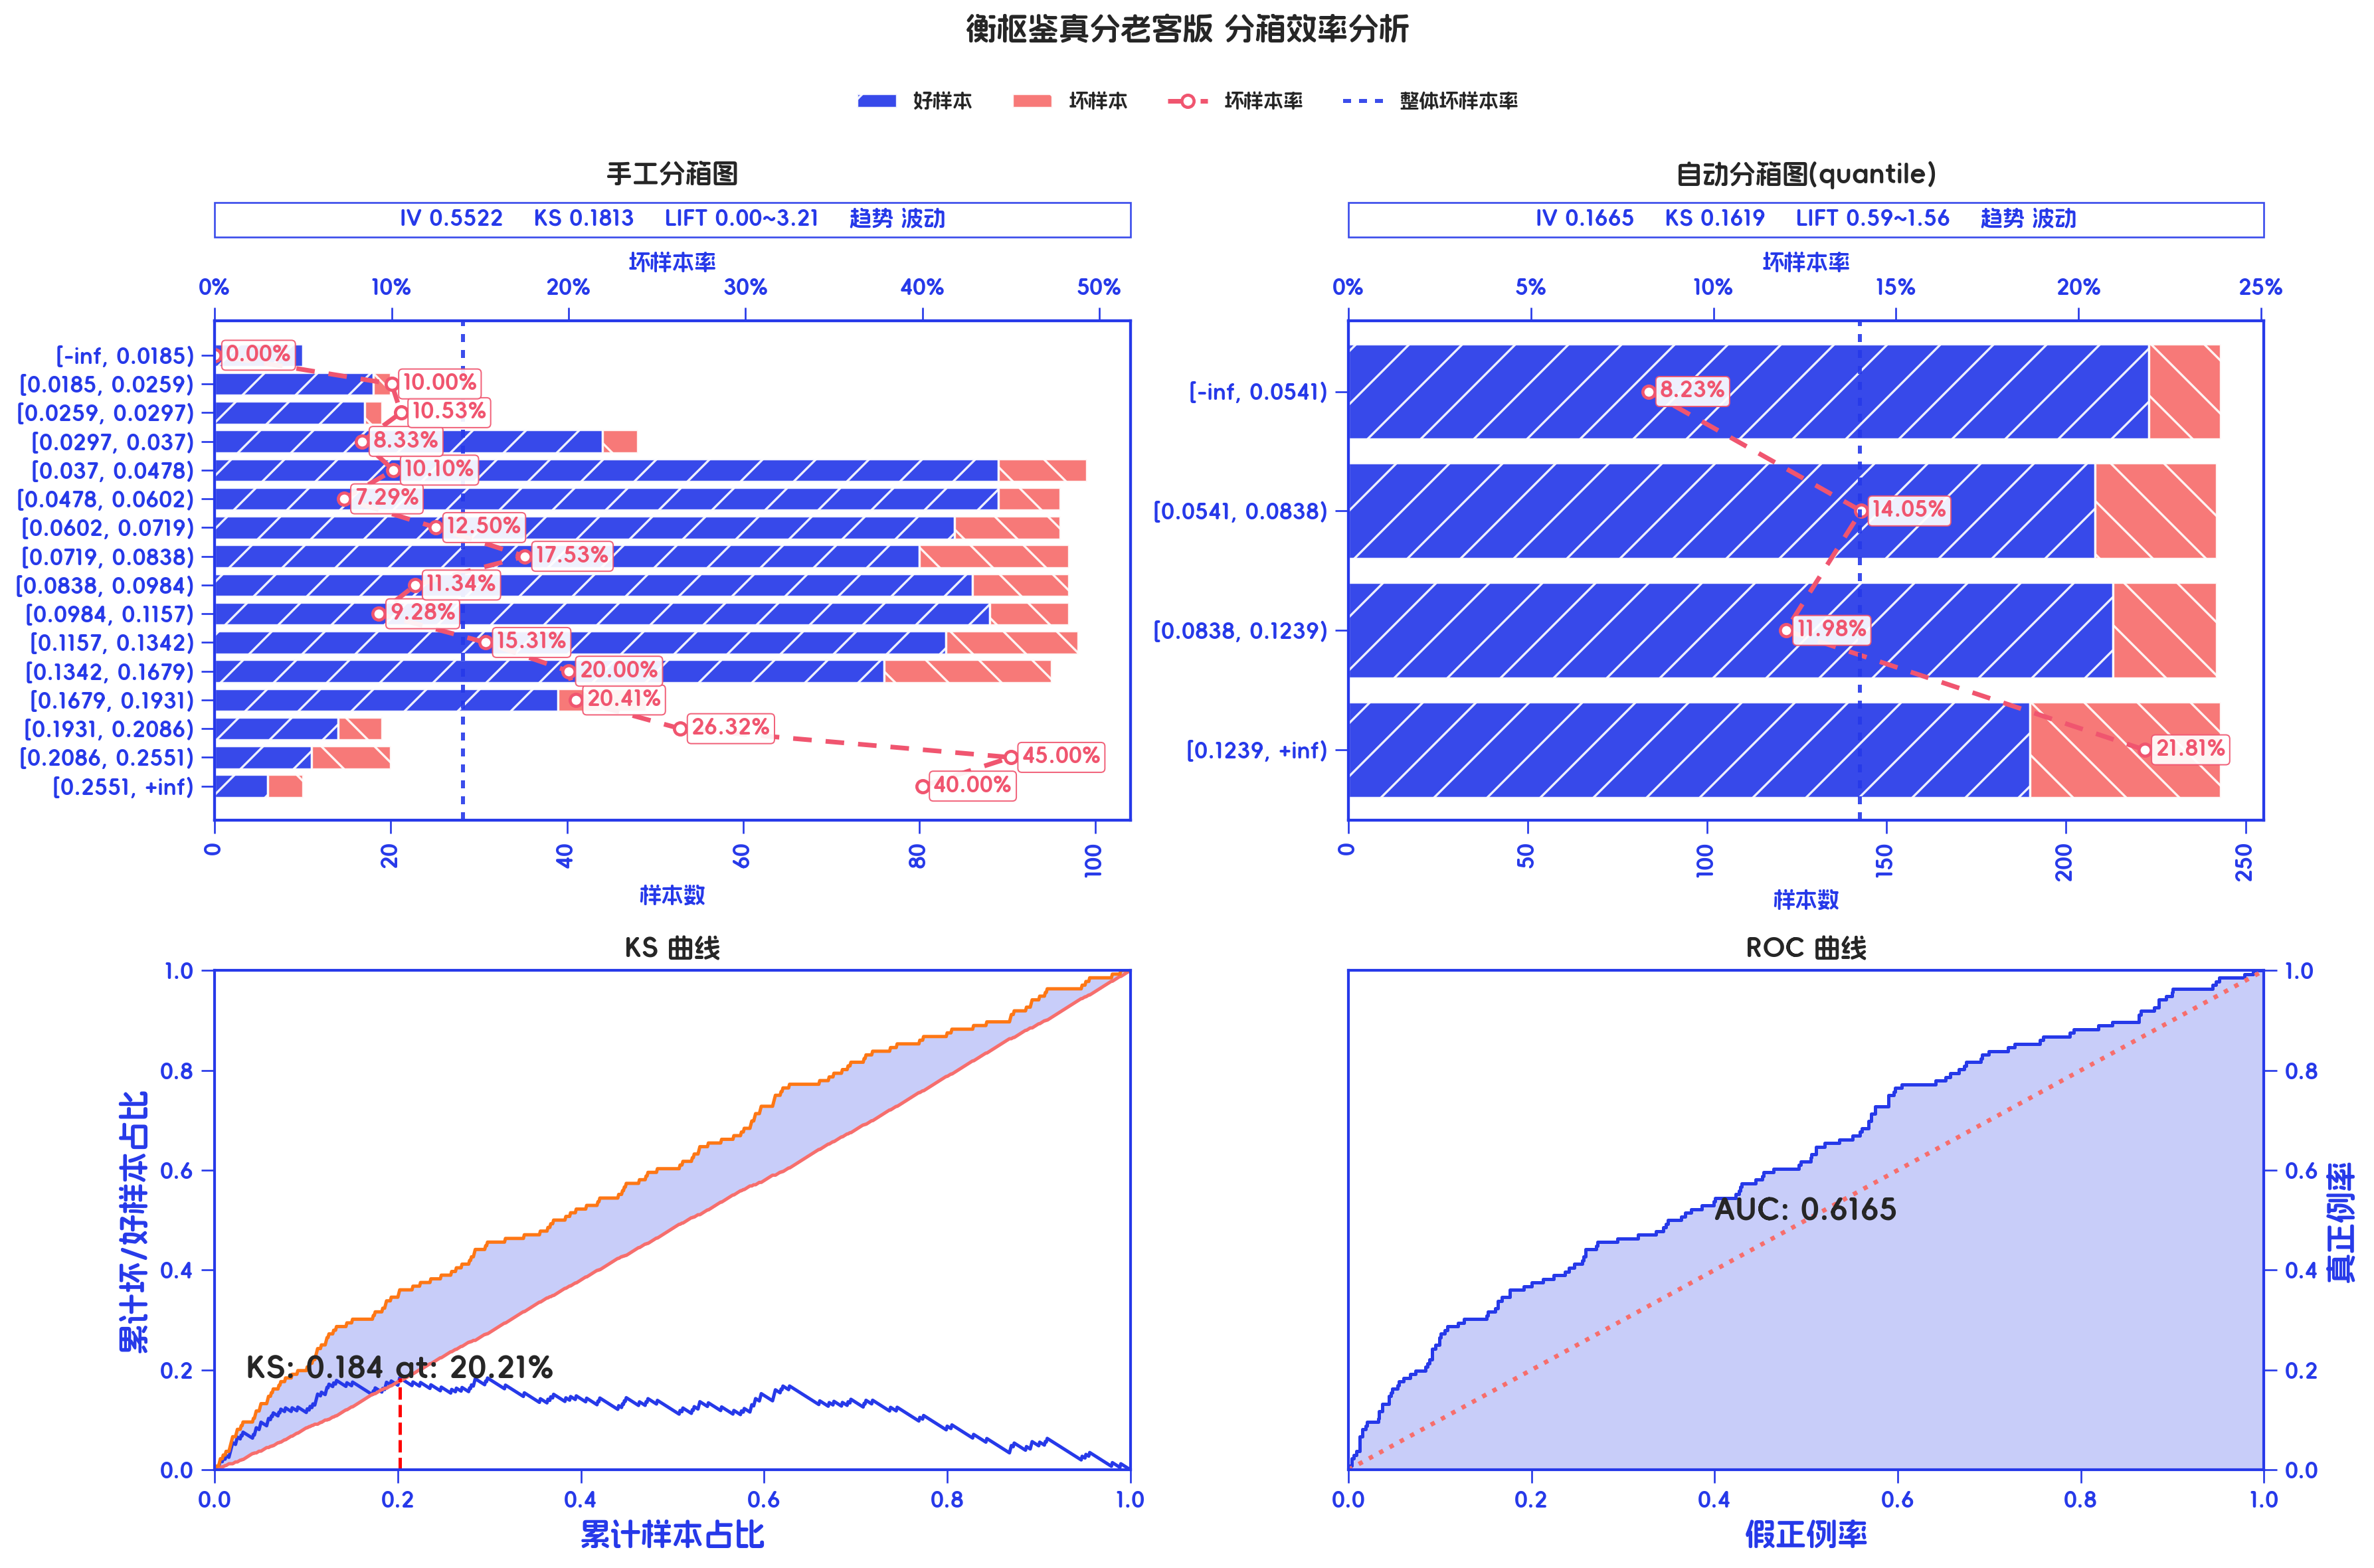
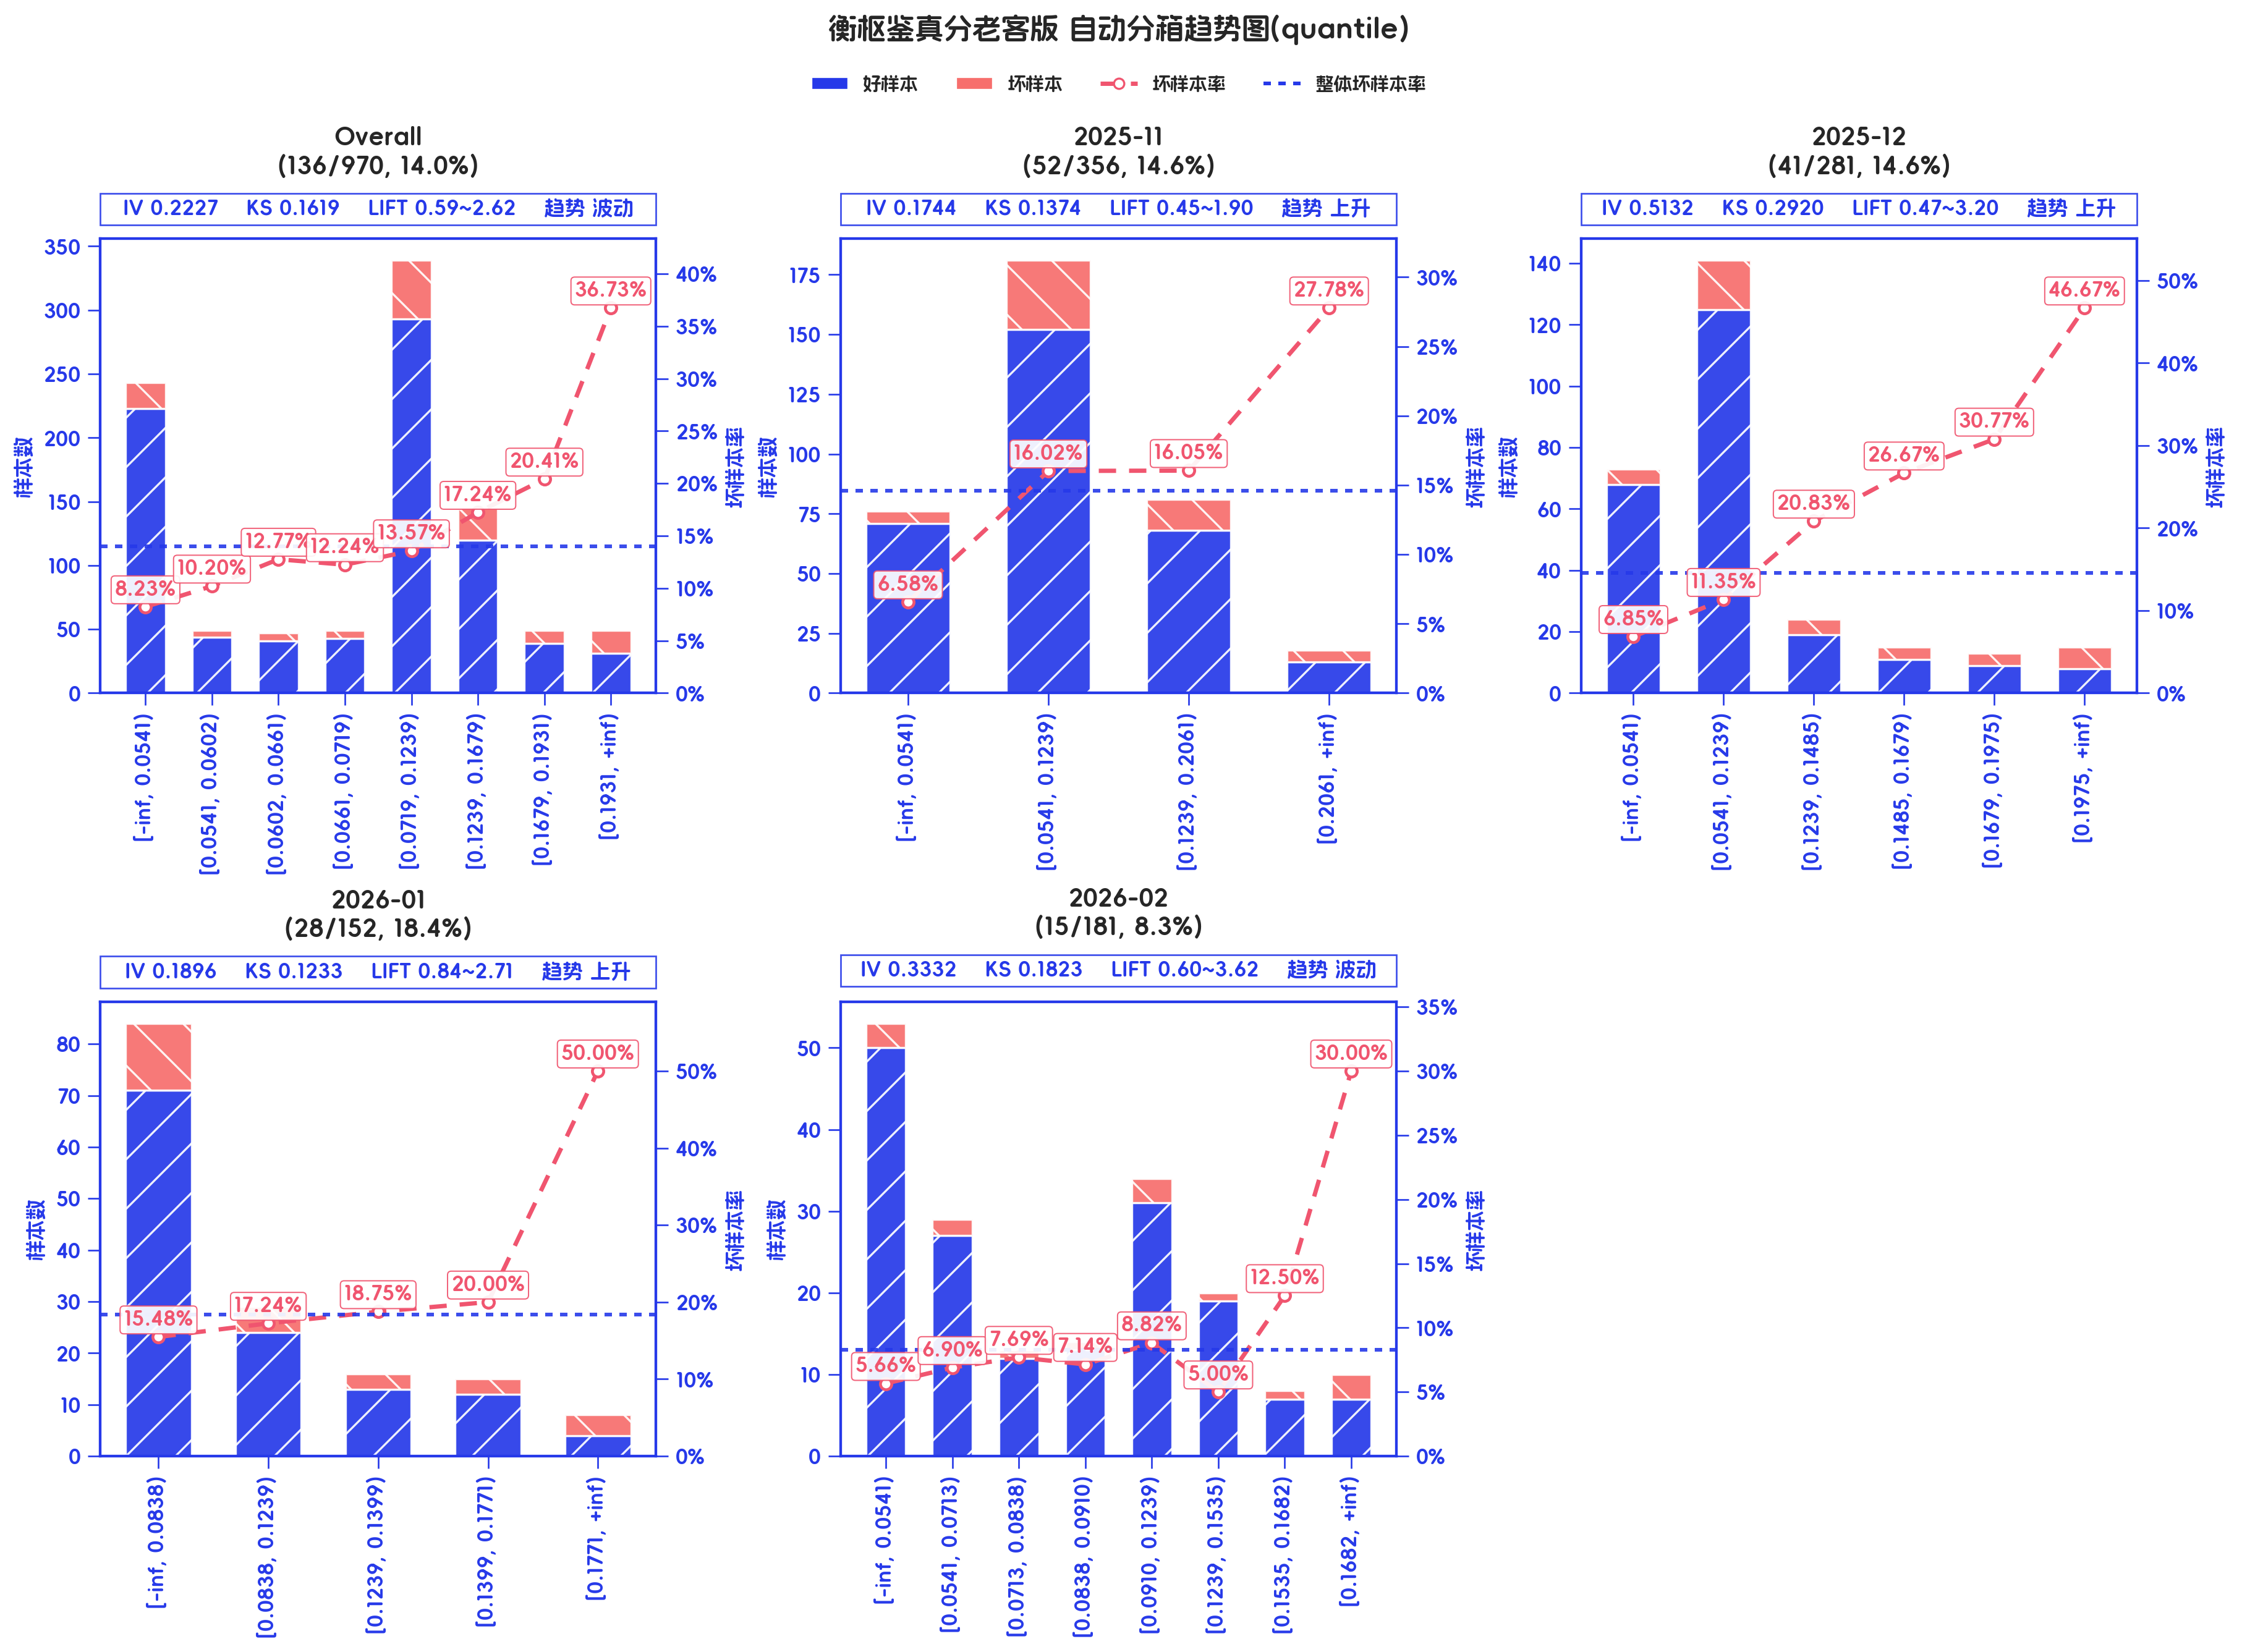
手工规则未传入时使用方法内置分位数切点;自动分箱最多四箱。返回两张完整统计表、原始规则、2×2 对比图及两张月份趋势图。
efficiency = feature_efficiency_analysis(
    df, feature="衡枢鉴真分老客版", target="FPD", auto_method="quantile",
    max_n_bins=4, date_col="放款时间", margins=True, n_jobs=1,
    trend_kwargs={"n_jobs": 1}, output_dir=str(ASSET_DIR / "efficiency"),
)
display(efficiency["manual_table"])
display(efficiency["auto_table"])
display(efficiency["manual_rules"])
display(efficiency["auto_rules"])
display(efficiency["comparison_figure"])
for figure in efficiency["trend_figures"].values():
    display(figure)
查看所有完整返回表与 Excel
efficiency/manual_table:17 行 × 22 列;完整 HTML · Excel:原始表1efficiency/auto_table:5 行 × 22 列;完整 HTML · Excel:原始表2
2. 四类原生分箱图
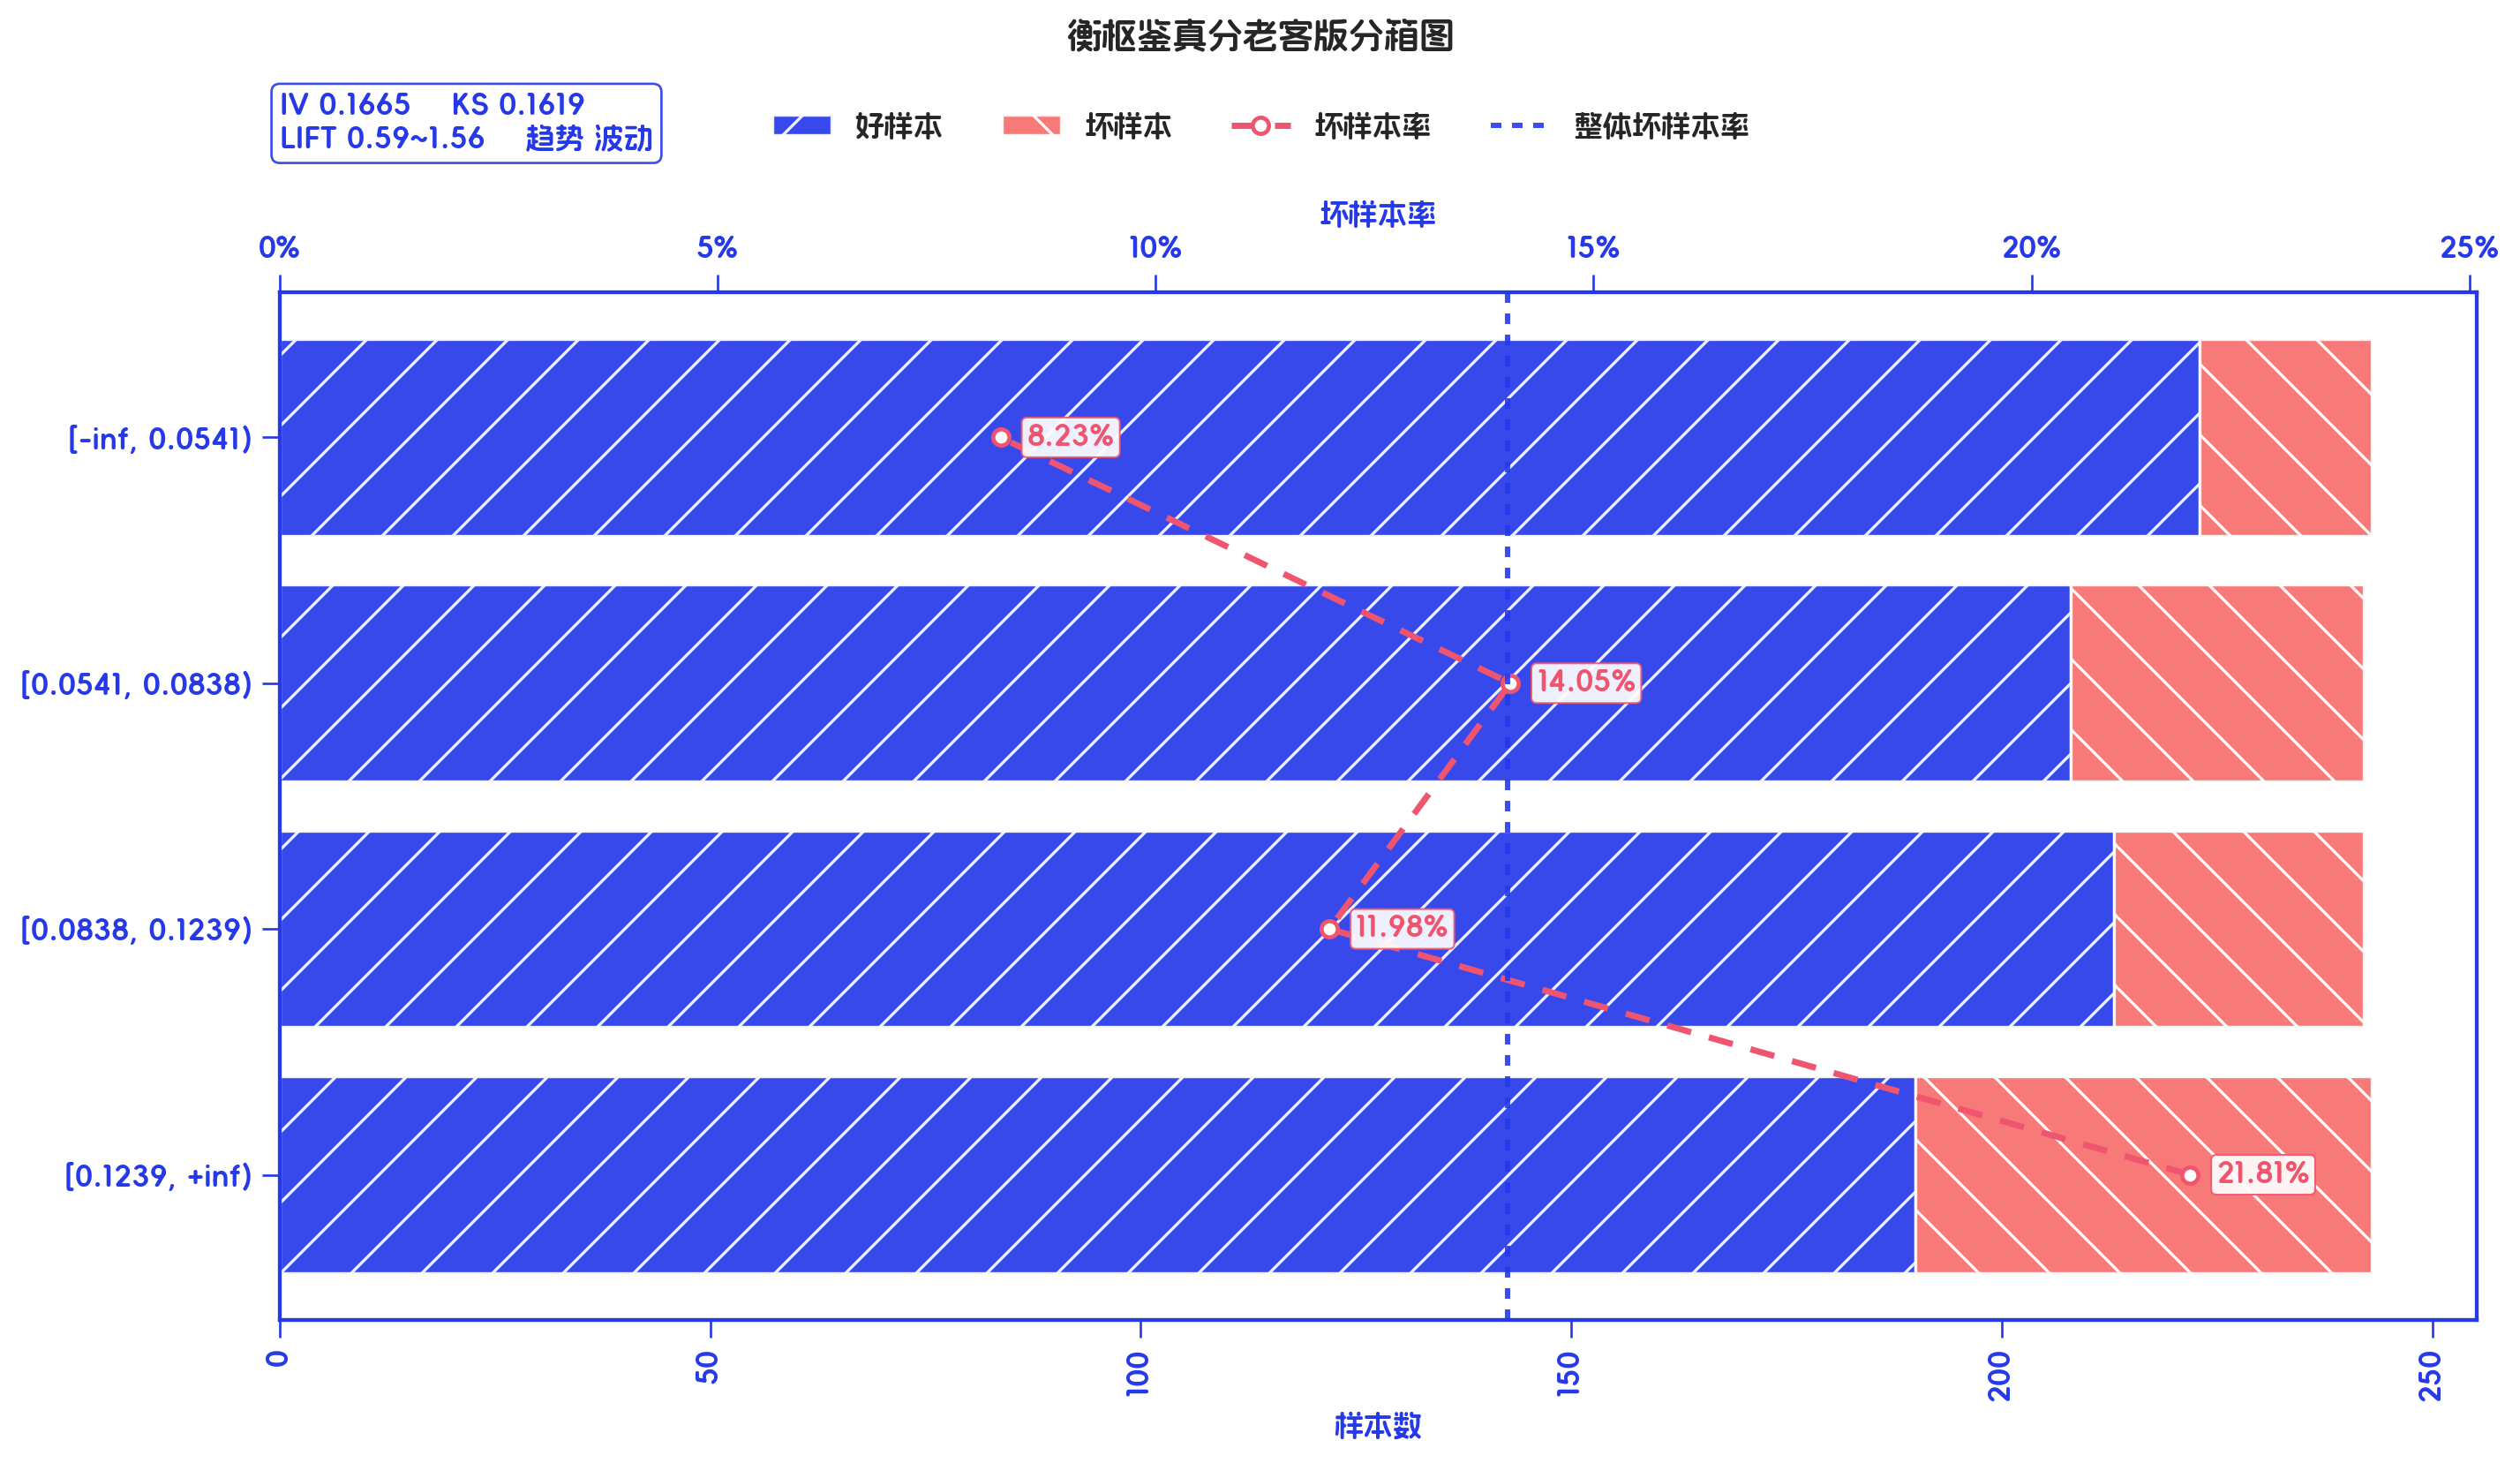
bin_plot:单变量的样本结构与坏率
直接传入完整原生分箱统计表;图片通过 save 参数输出。
single_bin_table = feature_bin_stats(
    df, feature="衡枢鉴真分老客版", target="FPD",
    method="quantile", max_n_bins=4, margins=True, n_jobs=1,
)
figure = bin_plot(
    single_bin_table, desc="衡枢鉴真分老客版",
    save=str(ASSET_DIR / "bin-plot.png"),
)
display(single_bin_table)
display(figure)
查看所有完整返回表与 Excel
single_bin_table:5 行 × 22 列;完整 HTML · Excel:原始表1
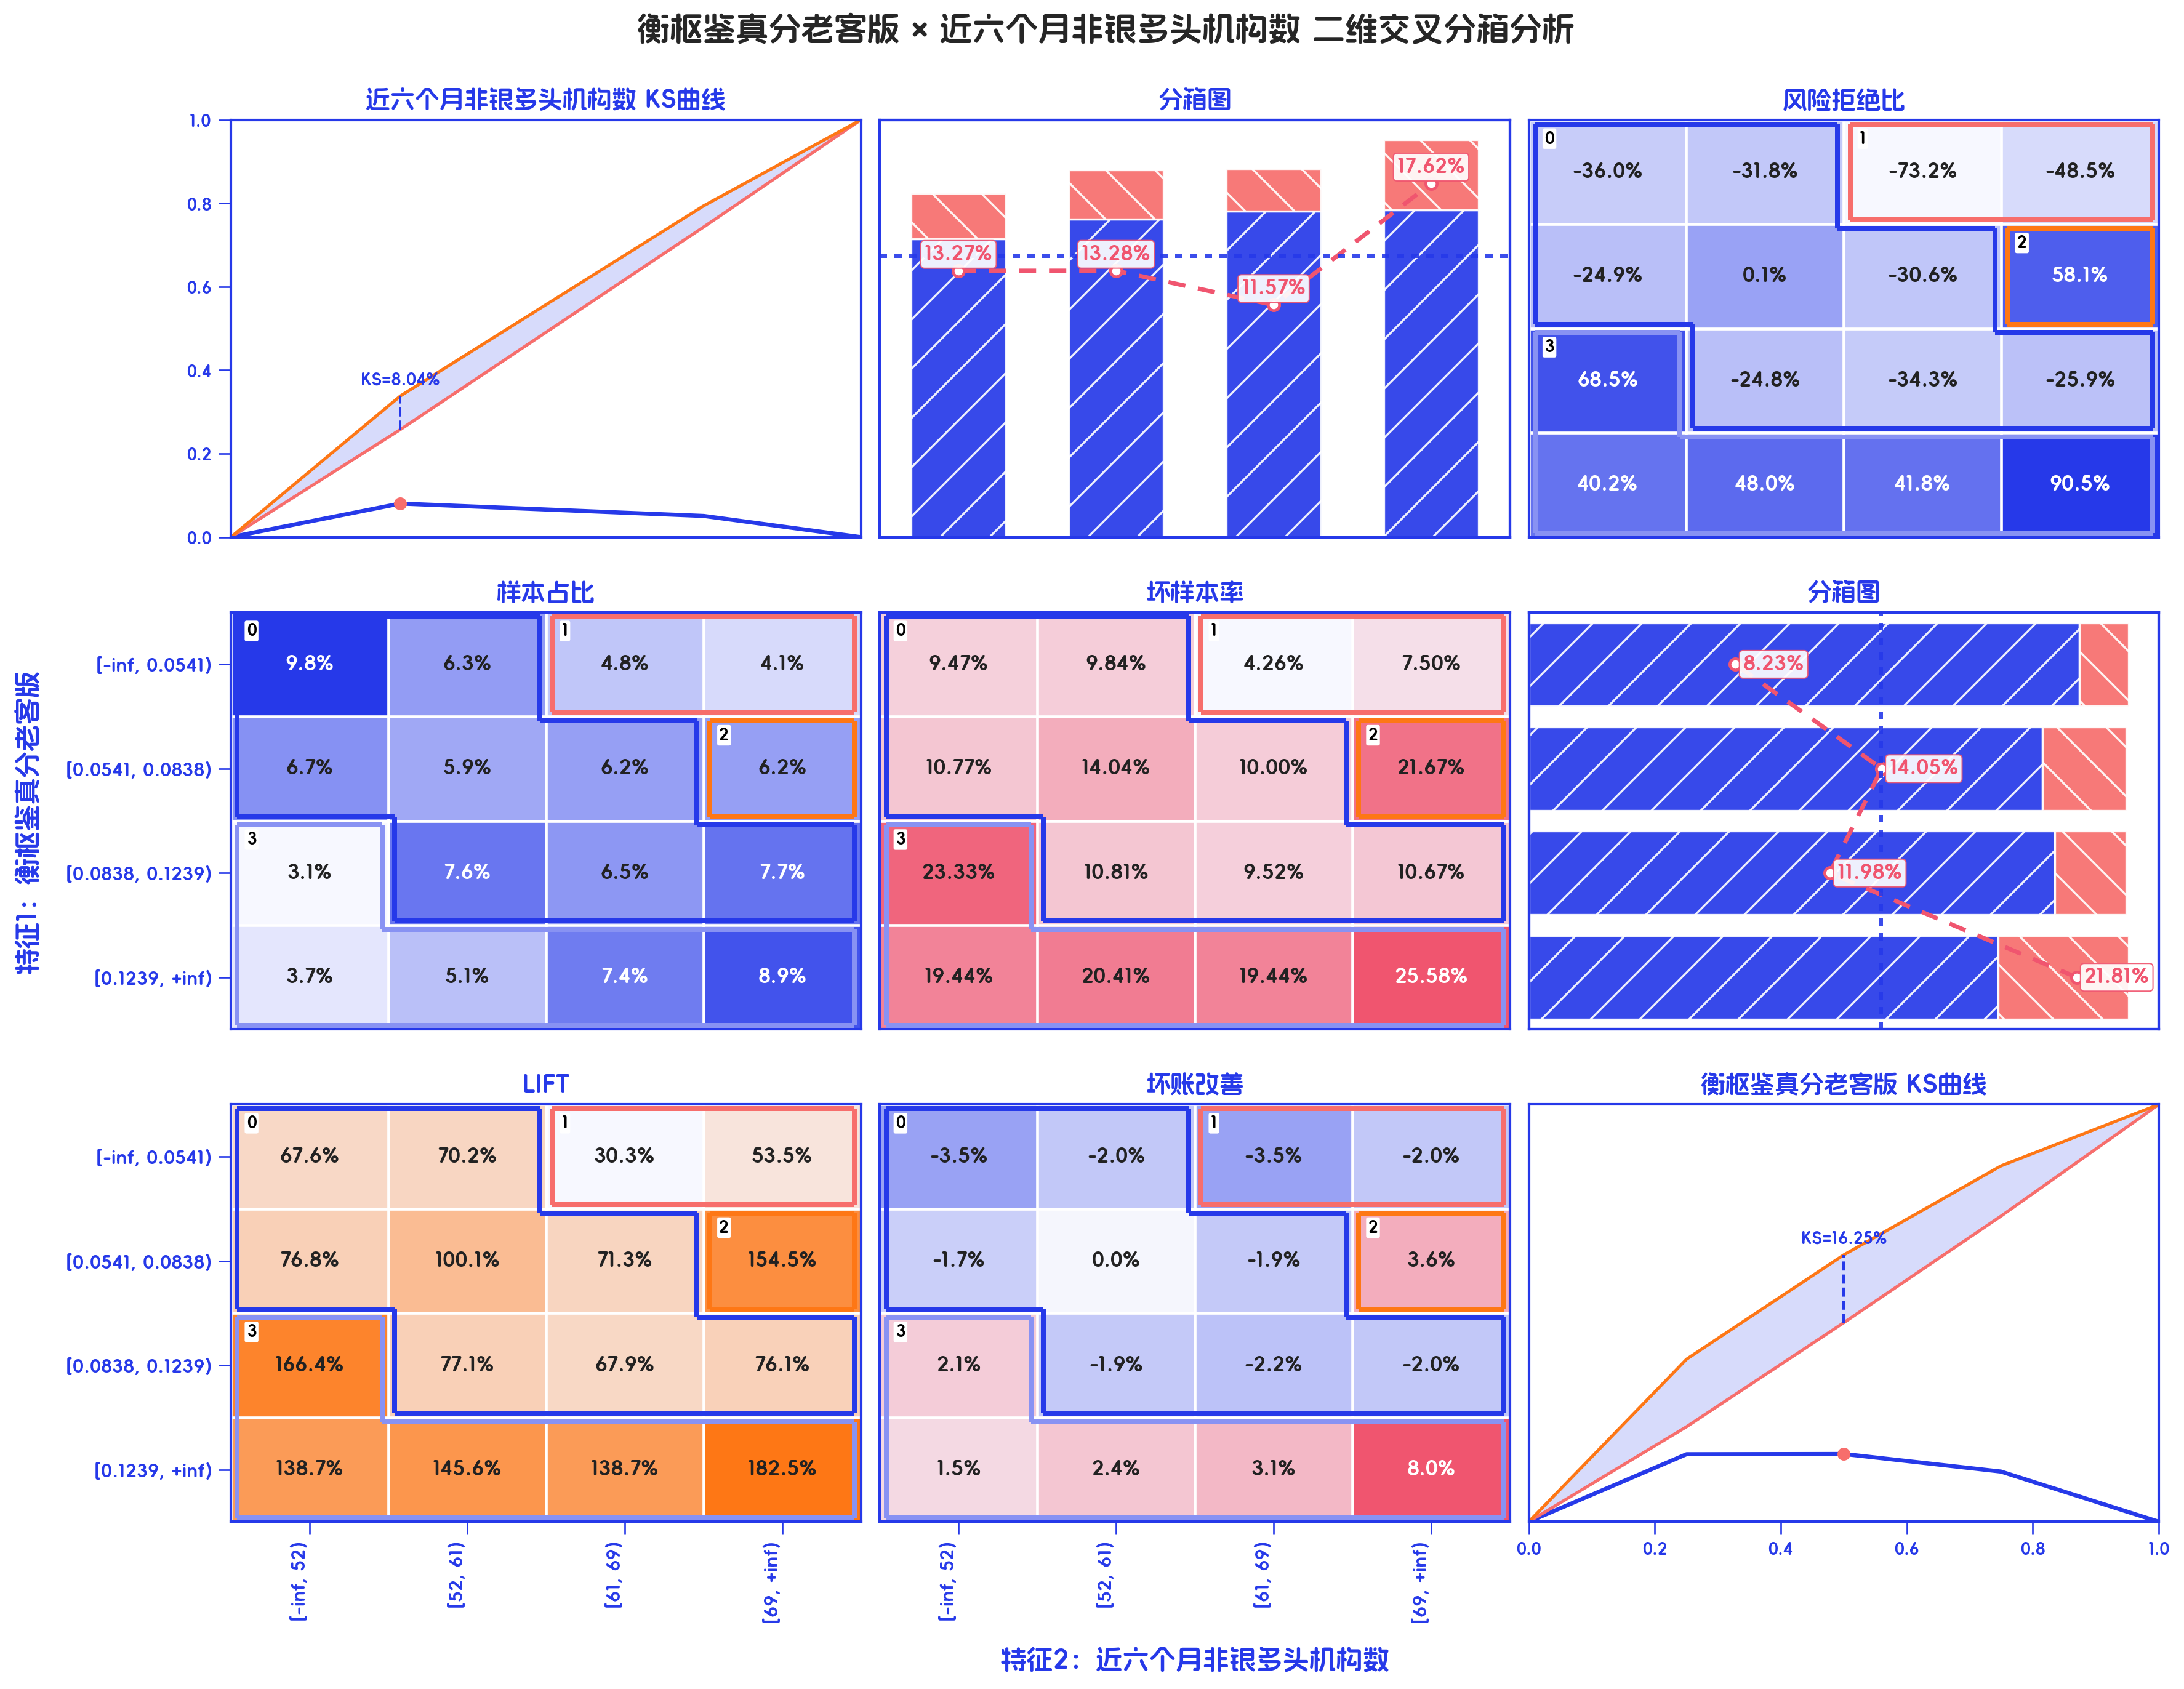
bin_2d_plot:两变量交叉风险与二维分箱
原生九宫格同时展示单变量分箱、分箱后的 KS 曲线和五类交叉指标。
figure = bin_2d_plot(
    df, features=["衡枢鉴真分老客版", "近六个月非银多头机构数"],
    target="FPD", method="quantile", max_n_bins=4,
    binner_kwargs={"n_jobs": 1}, save=str(ASSET_DIR / "bin-2d.png"),
)
display(figure)
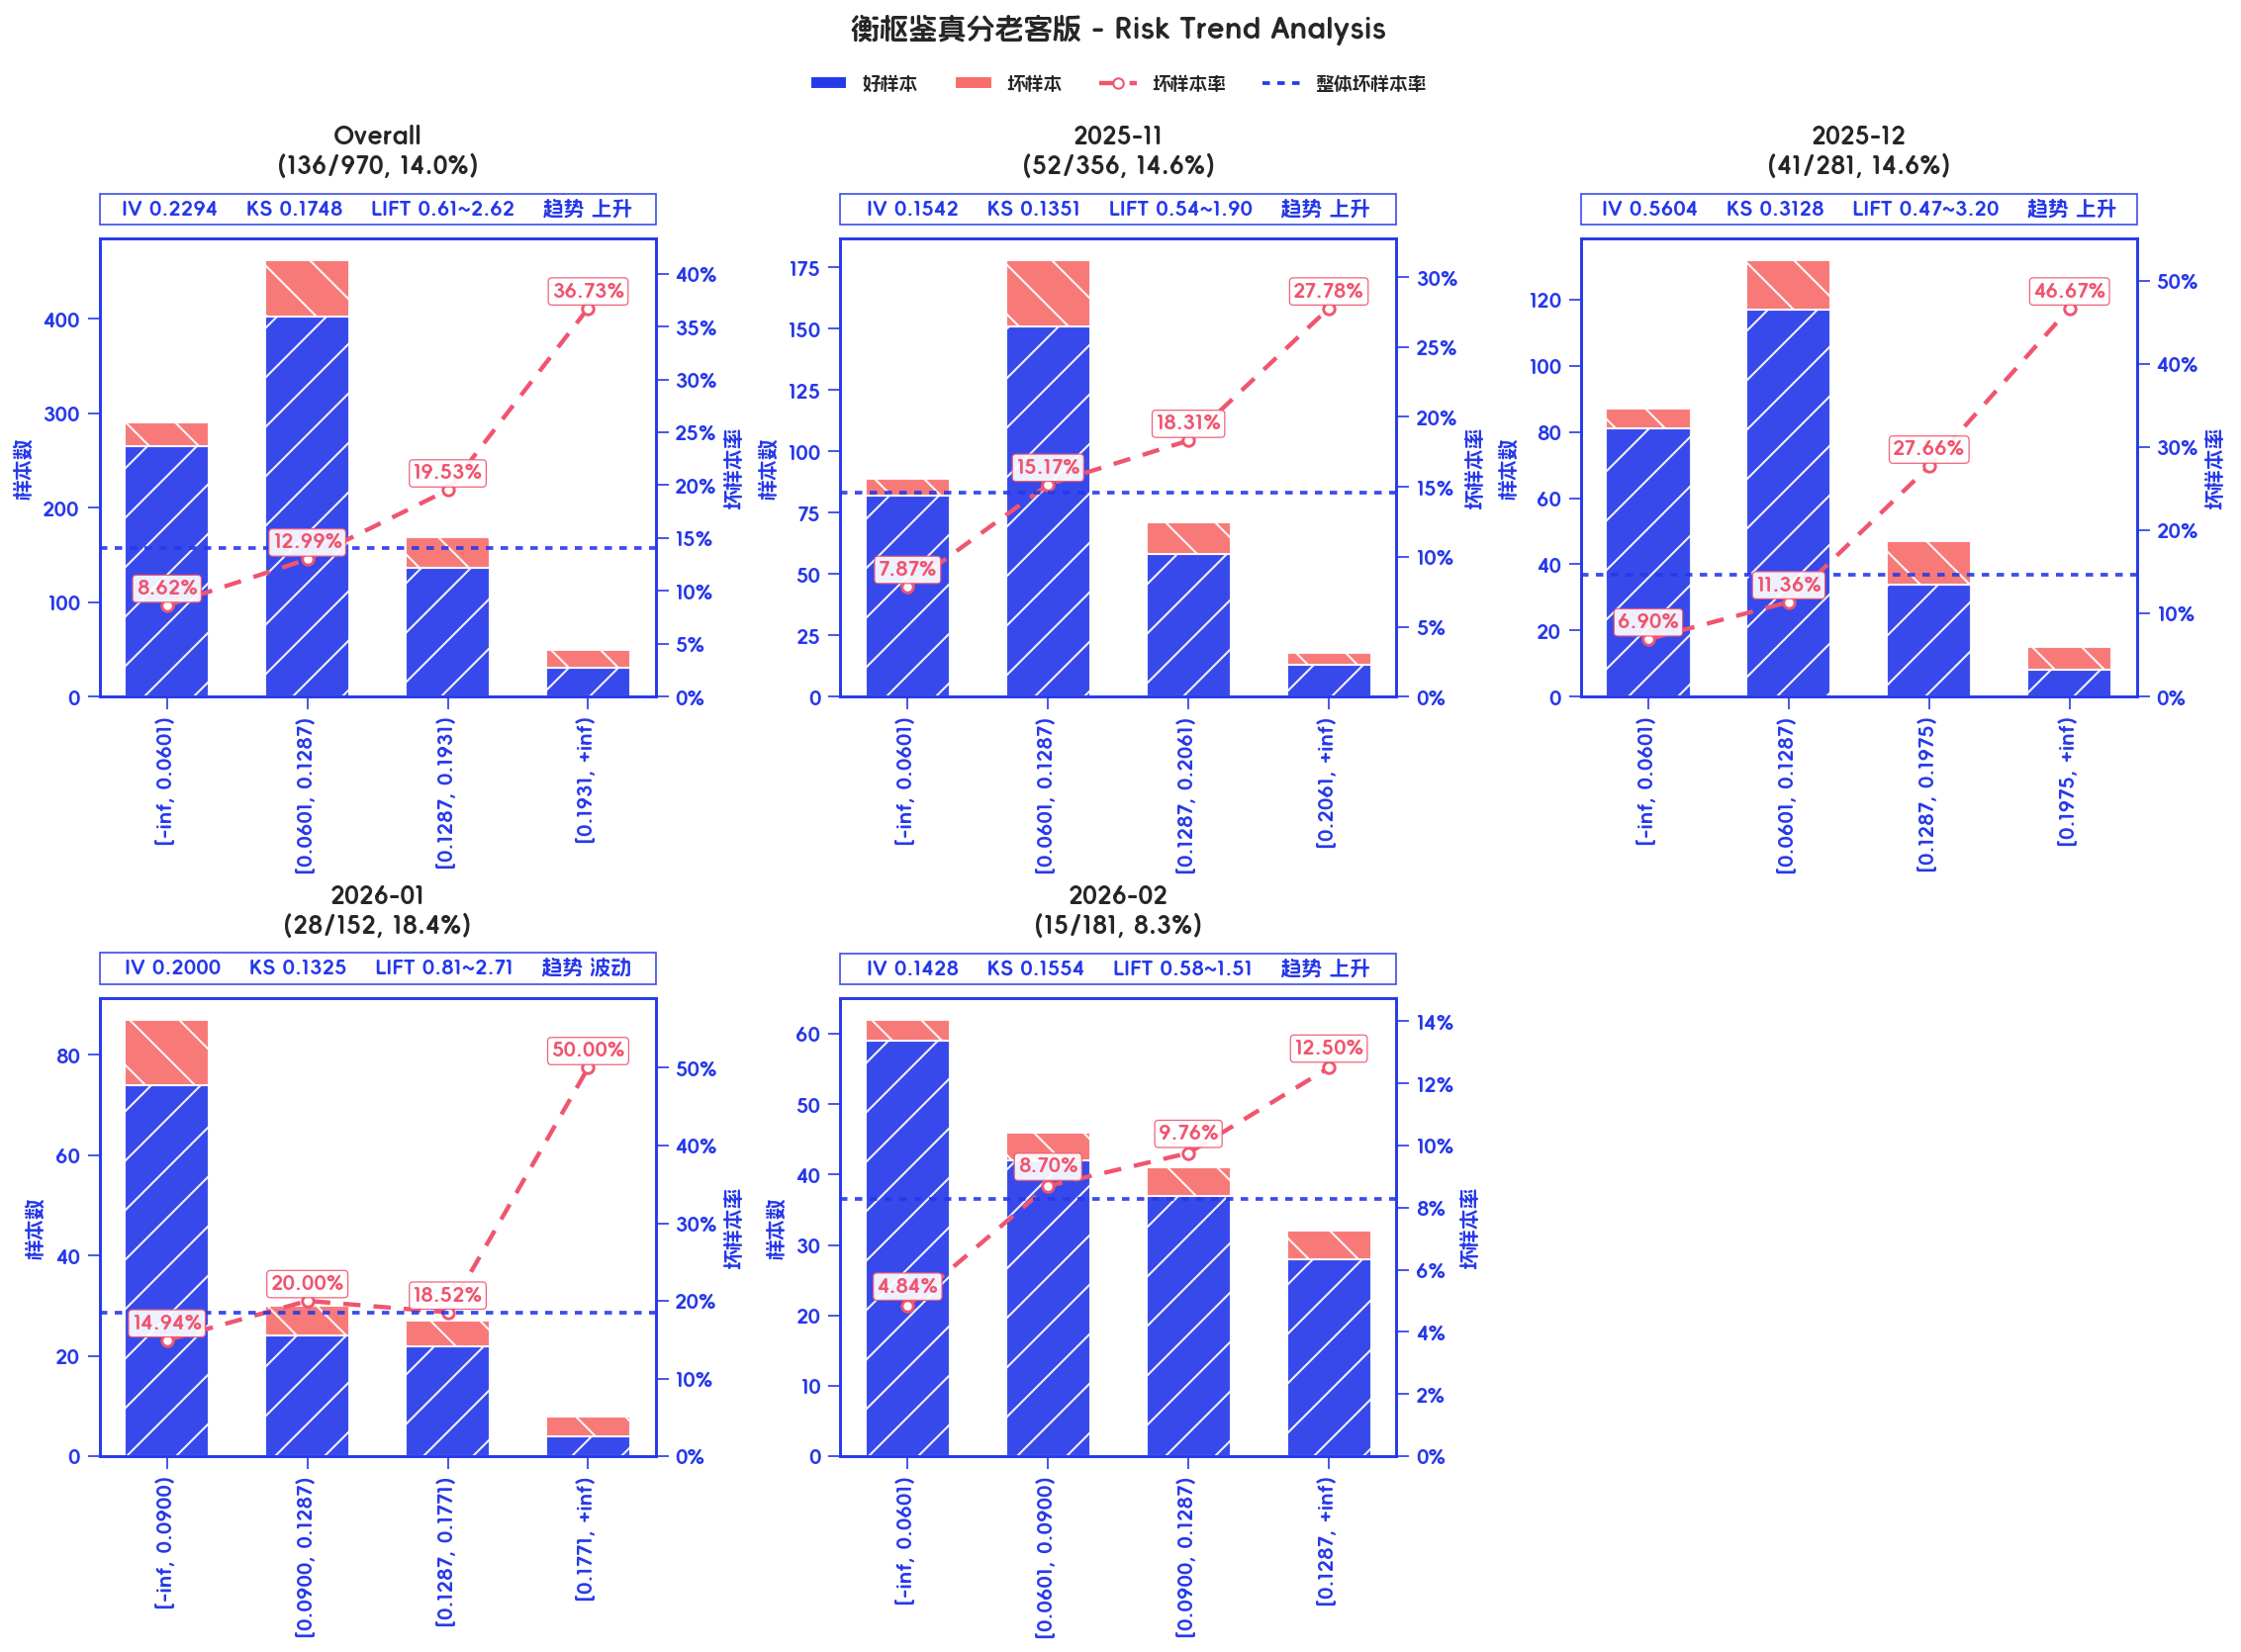
bin_trend_plot:按放款月份检查分箱风险趋势
保留方法默认分箱行为和完整月份,不缩减分组或二次调整图片;各月份的实际切点以原图标签为准。
figure = bin_trend_plot(
    df, feature="衡枢鉴真分老客版", target="FPD", date_col="放款时间",
    method="quantile", max_n_bins=4, n_jobs=1,
    save=str(ASSET_DIR / "bin-trend.png"),
)
display(figure)
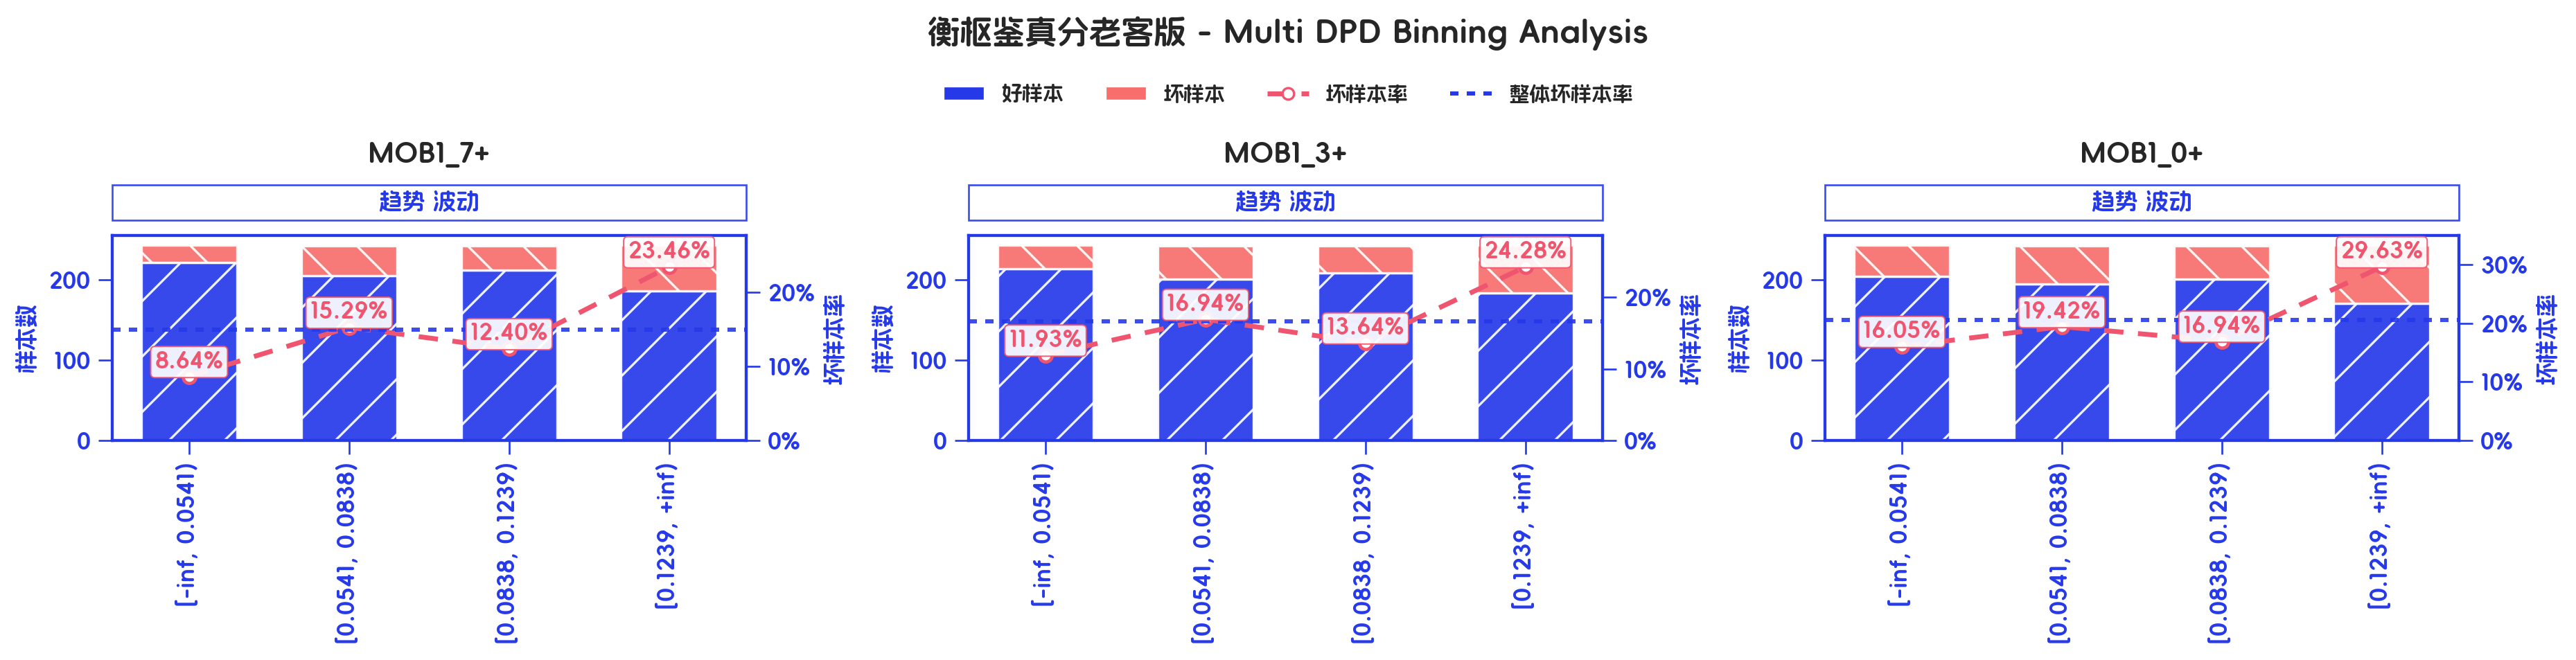
bin_overdues_plot:对比 MOB1 的三种逾期口径
feature_bin_stats 默认按 MOB1 > DPD 生成三种标签。完整多级表头统计表直接传给 bin_table;没有在方法外拆标签、筛字段或重算指标。当前表模式能绘制三种坏率,但其适配器未识别当前统计表的 IV/KS/Lift 列名,因此图顶摘要仅显示趋势;完整指标仍保留在下方原始表和 Excel。
overdue_table = feature_bin_stats(
    df, feature="衡枢鉴真分老客版", overdue=["MOB1"], dpds=[7, 3, 0],
    method="quantile", max_n_bins=4, margins=True, n_jobs=1,
)
figure = bin_overdues_plot(
    overdue_table, bin_table=overdue_table, n_jobs=1,
    save=str(ASSET_DIR / "bin-overdues.png"),
)
display(overdue_table)
display(figure)
查看所有完整返回表与 Excel
overdue_table:5 行 × 56 列;完整 HTML · Excel:原始表1
3. EDA 与自动特征分析
DataFrame.summary:数据质量、区分度与跨月稳定性
一次返回三个数值特征和商品类别的完整综合统计;字段类型交由原生 API 判断。本数据中唯一值较多的评分被原生识别为 id,趋势返回 unknown,结果原样保留。
summary = df.summary(
    features=features + ["商品类别"], y="FPD",
    max_n_bins=4, psi_method="date_col", psi_date_col="放款时间", n_jobs=1,
)
display(summary)
查看所有完整返回表与 Excel
summary:4 行 × 30 列;完整 HTML · Excel:原始表1

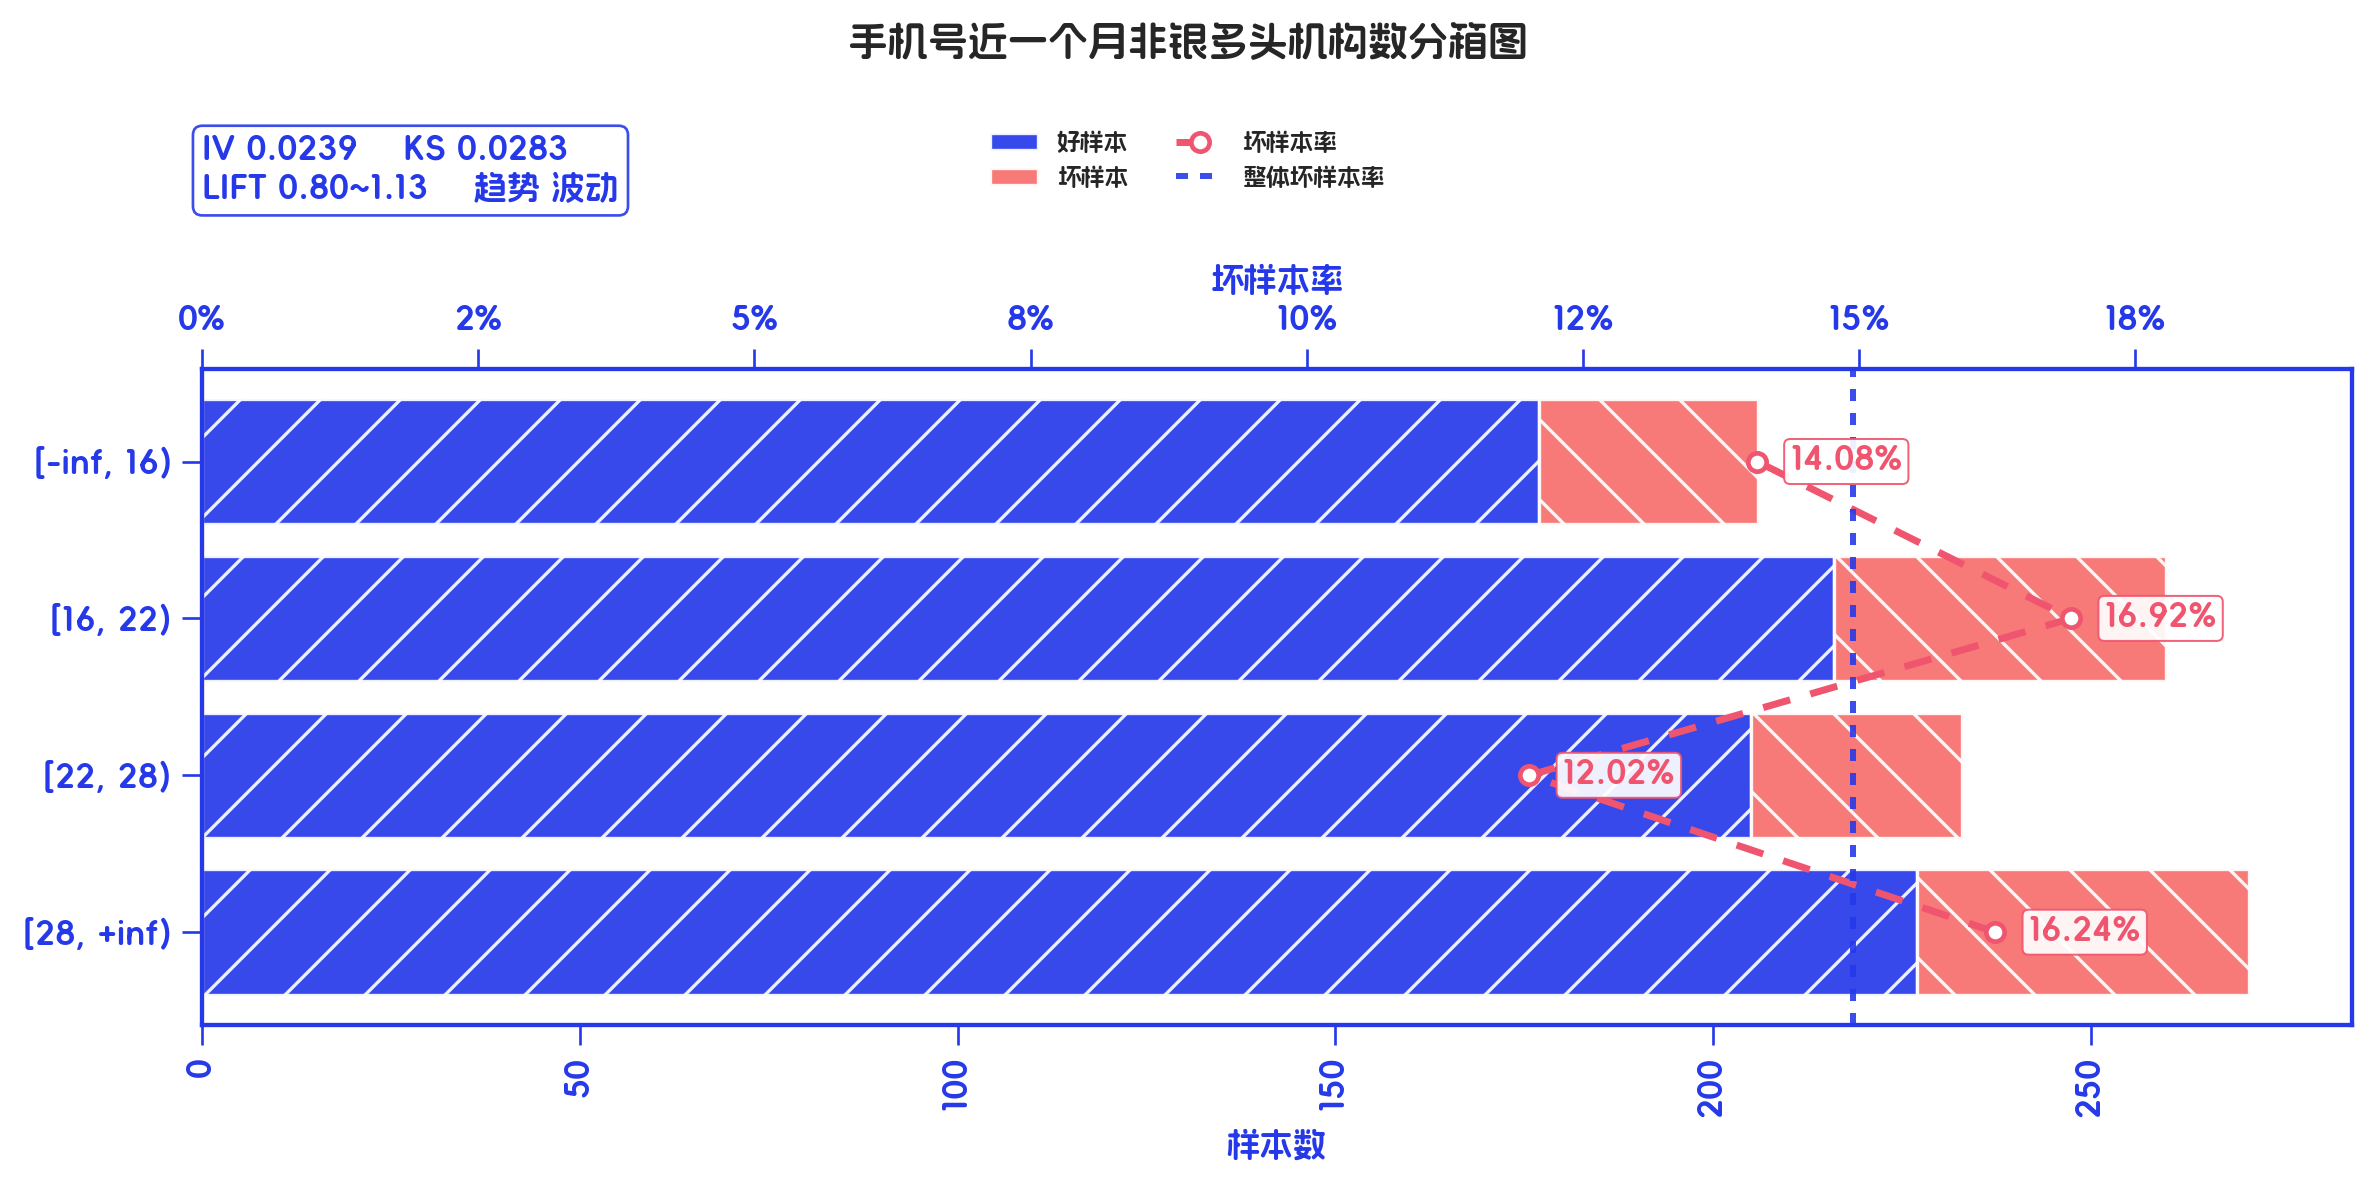
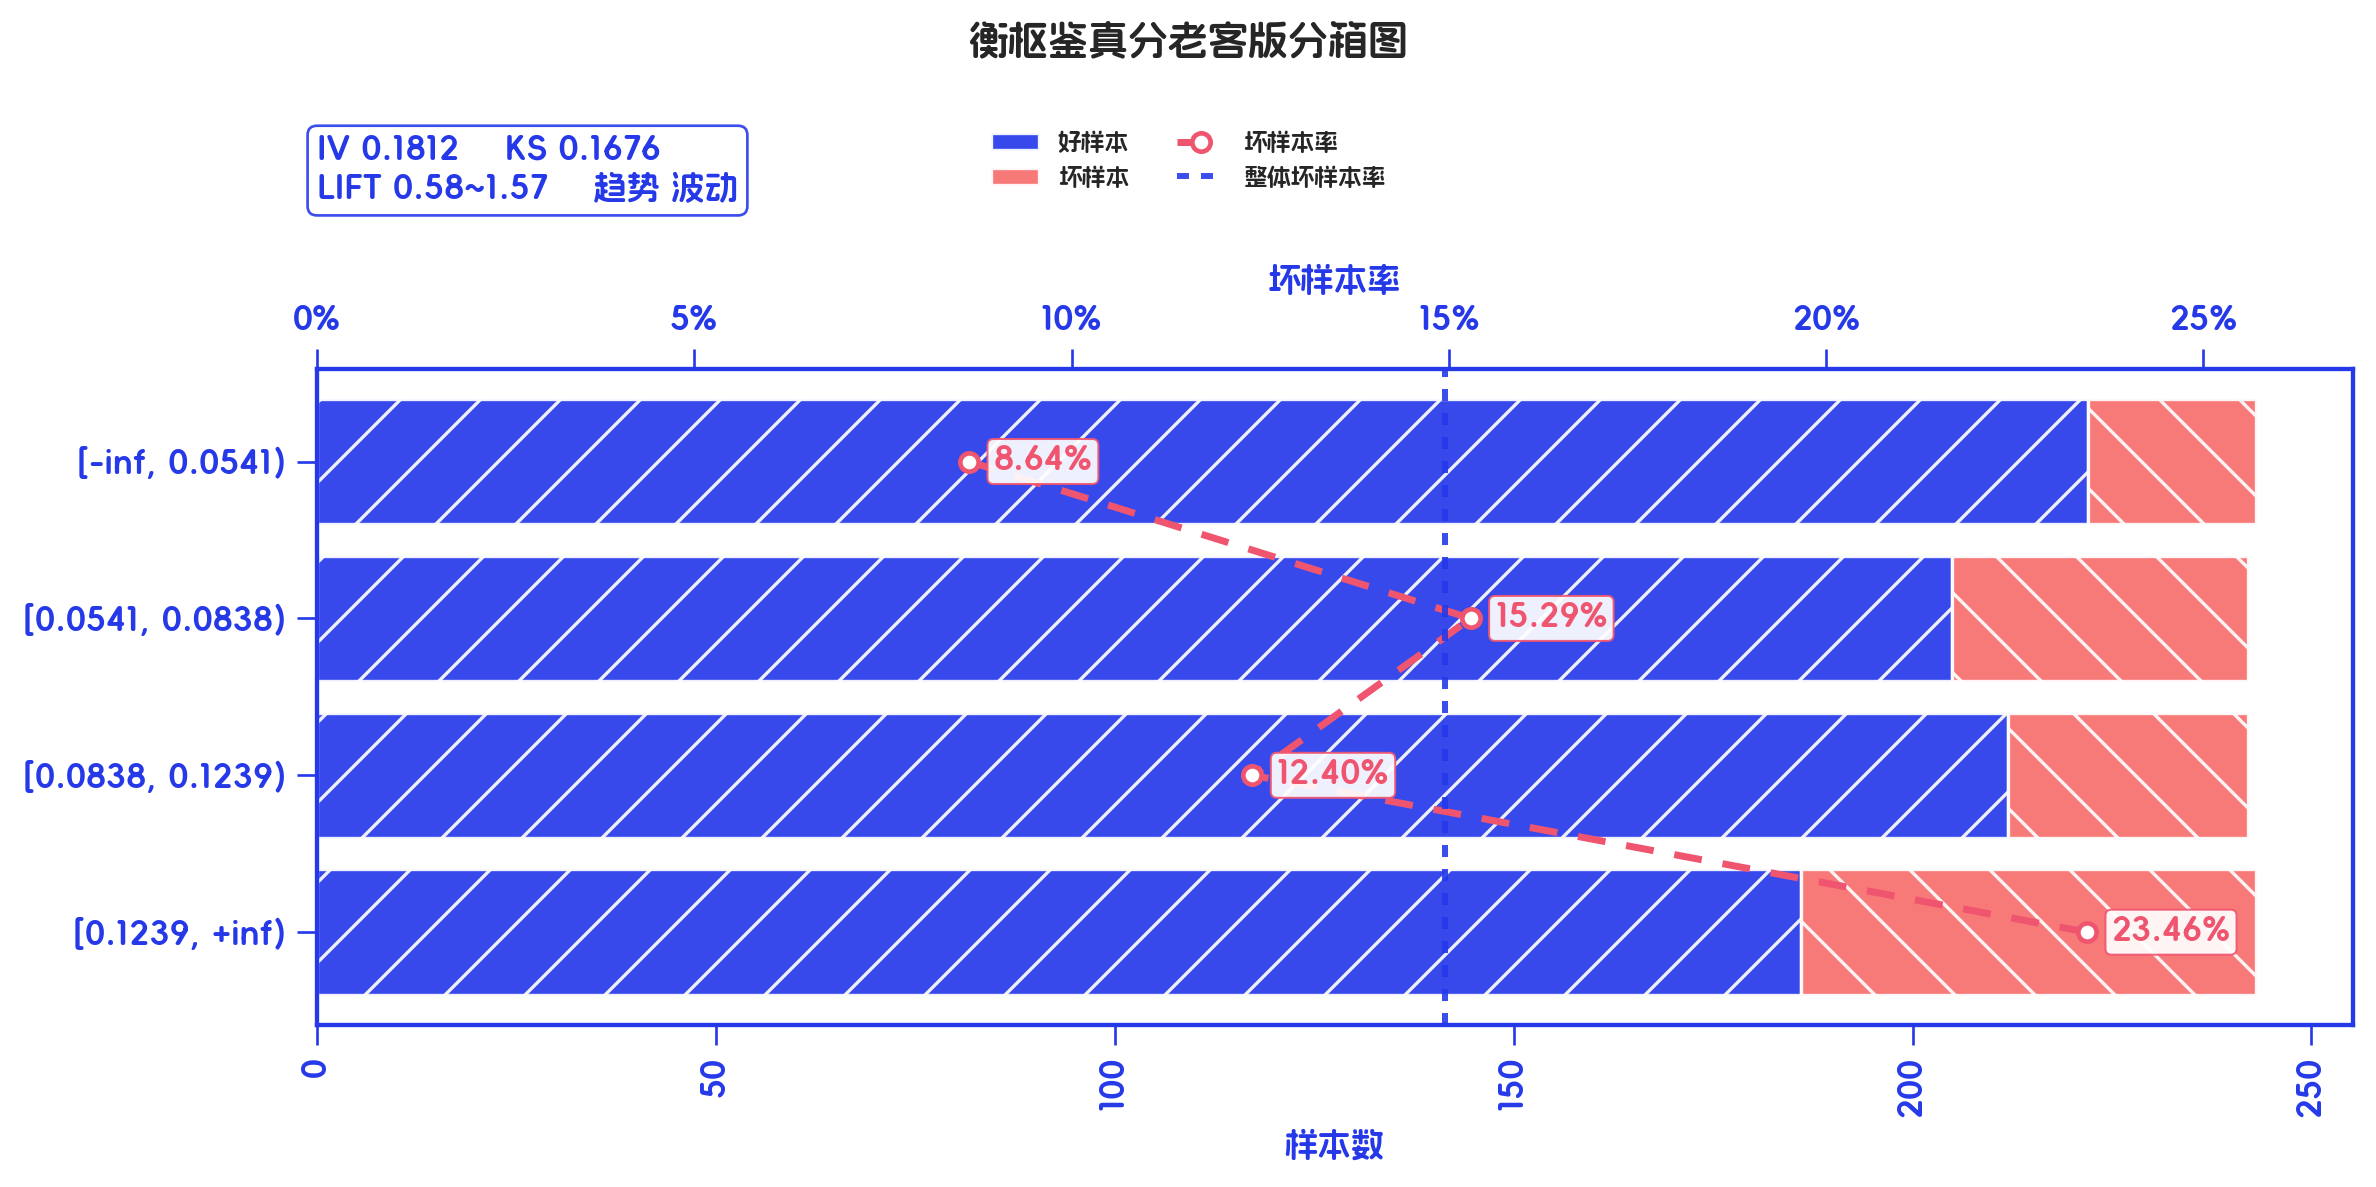
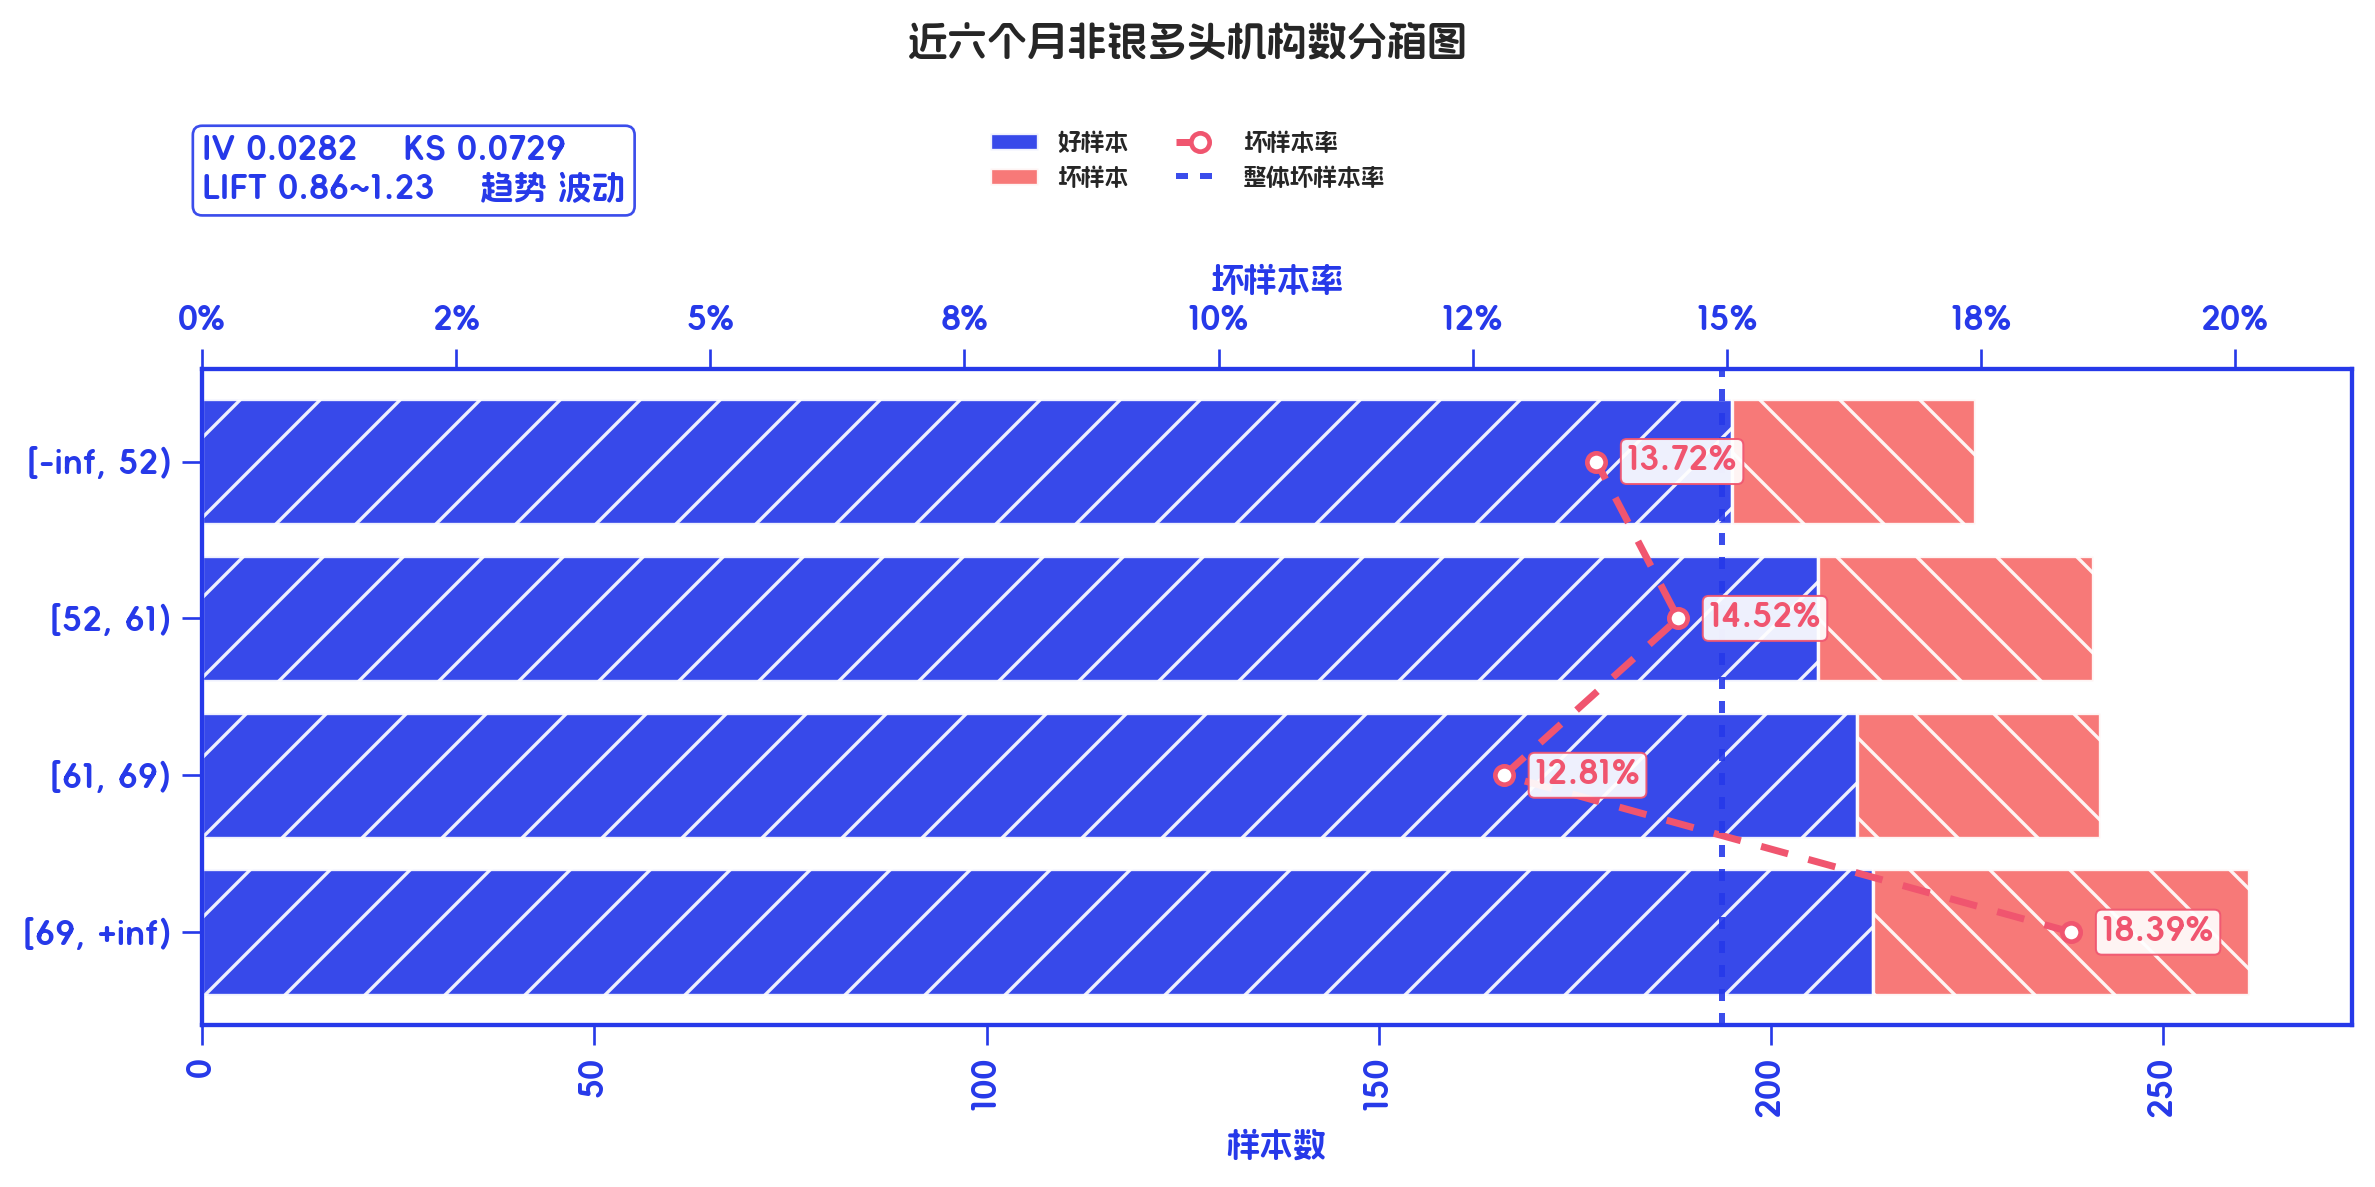
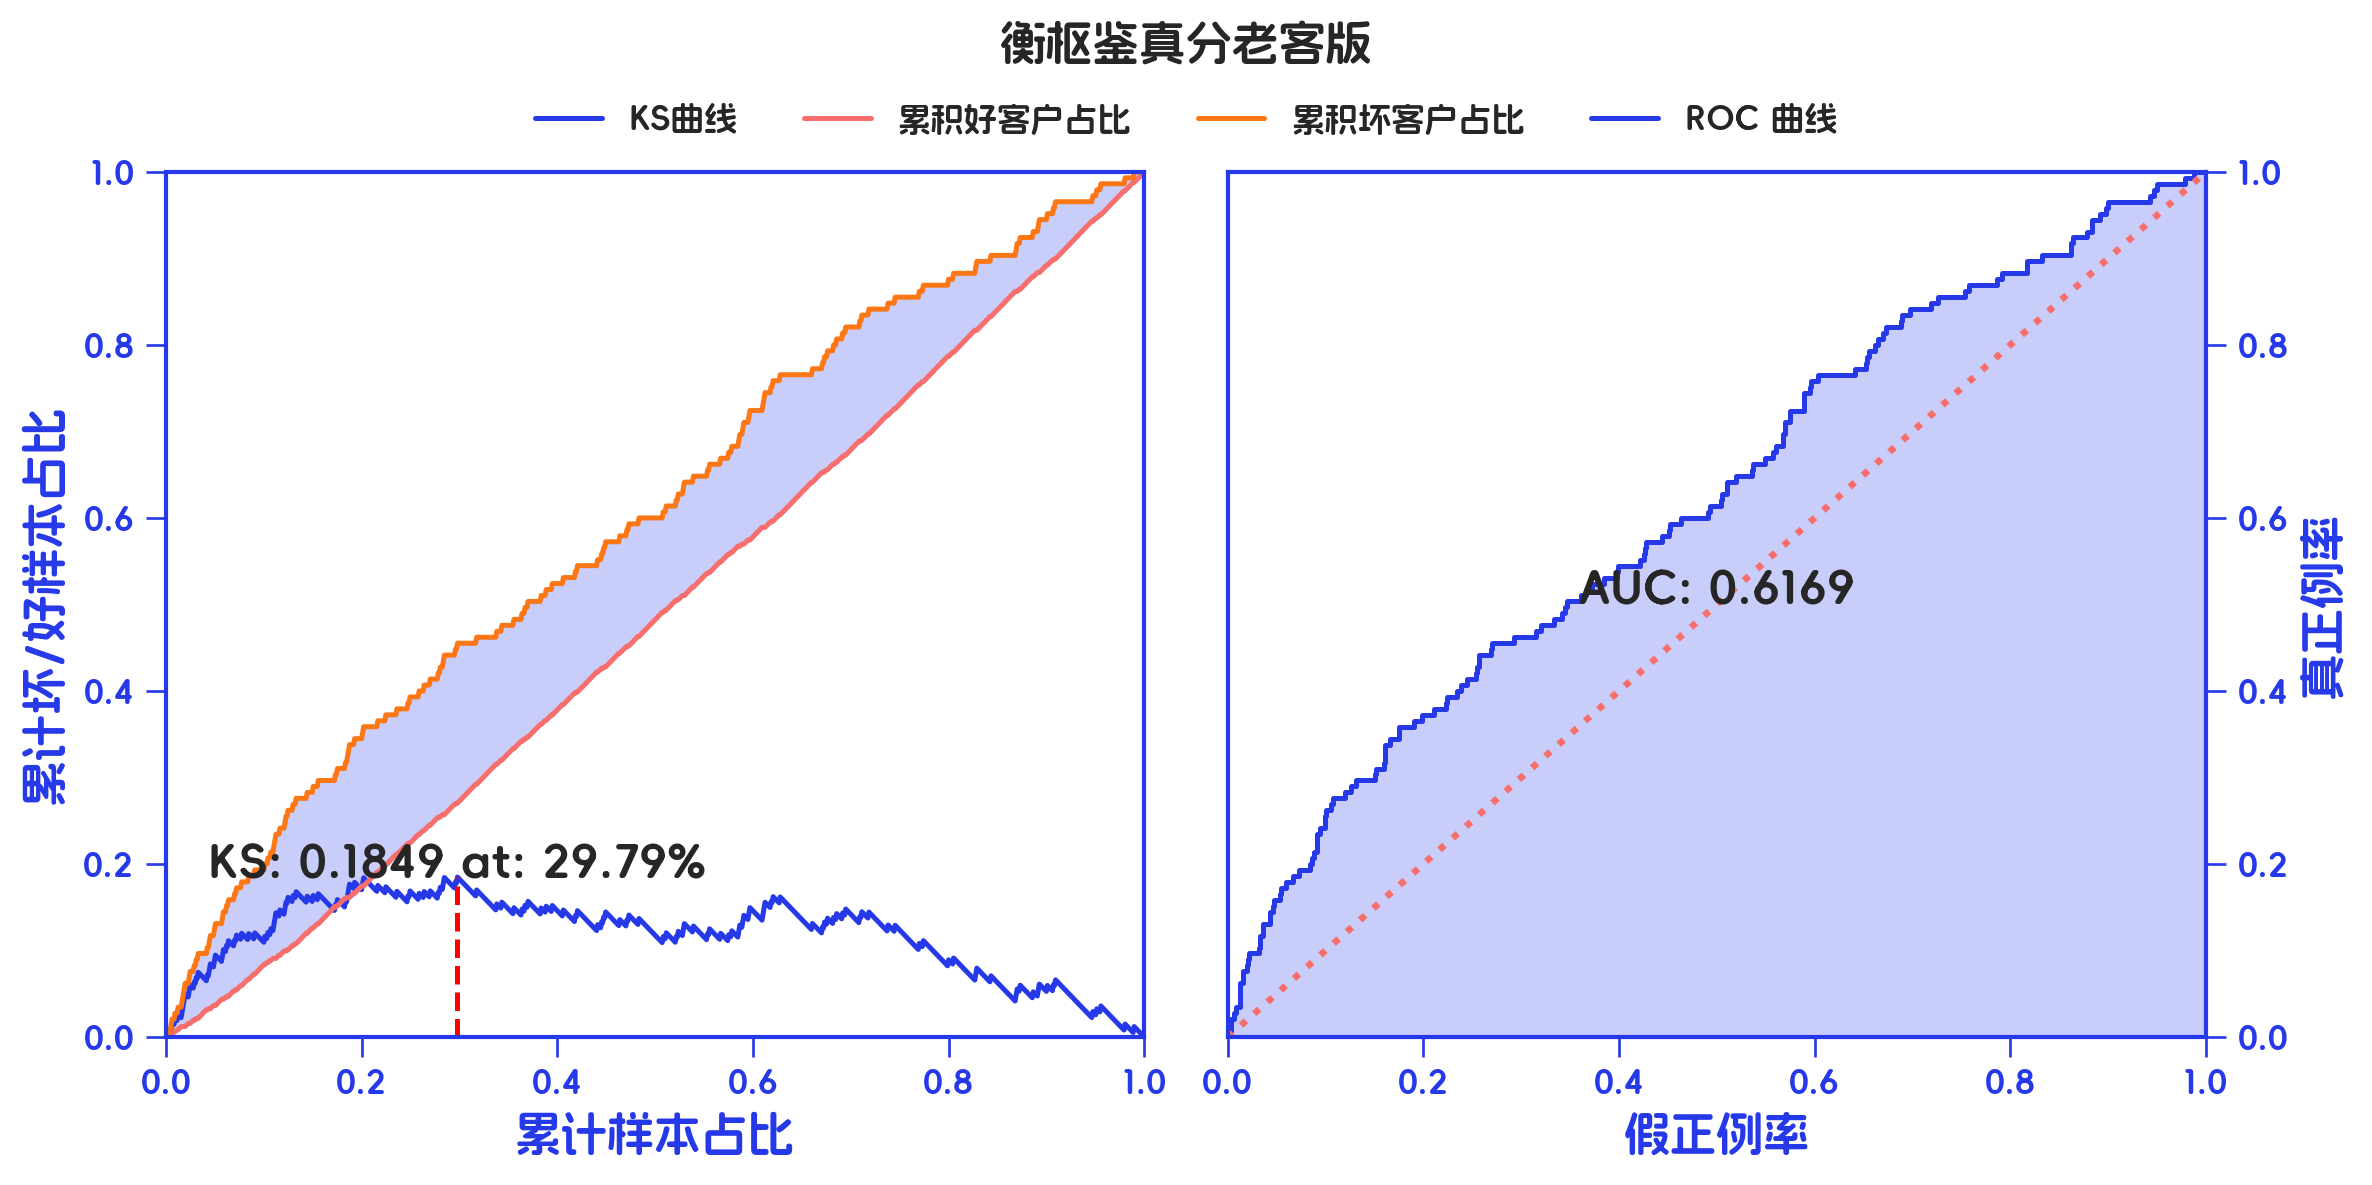
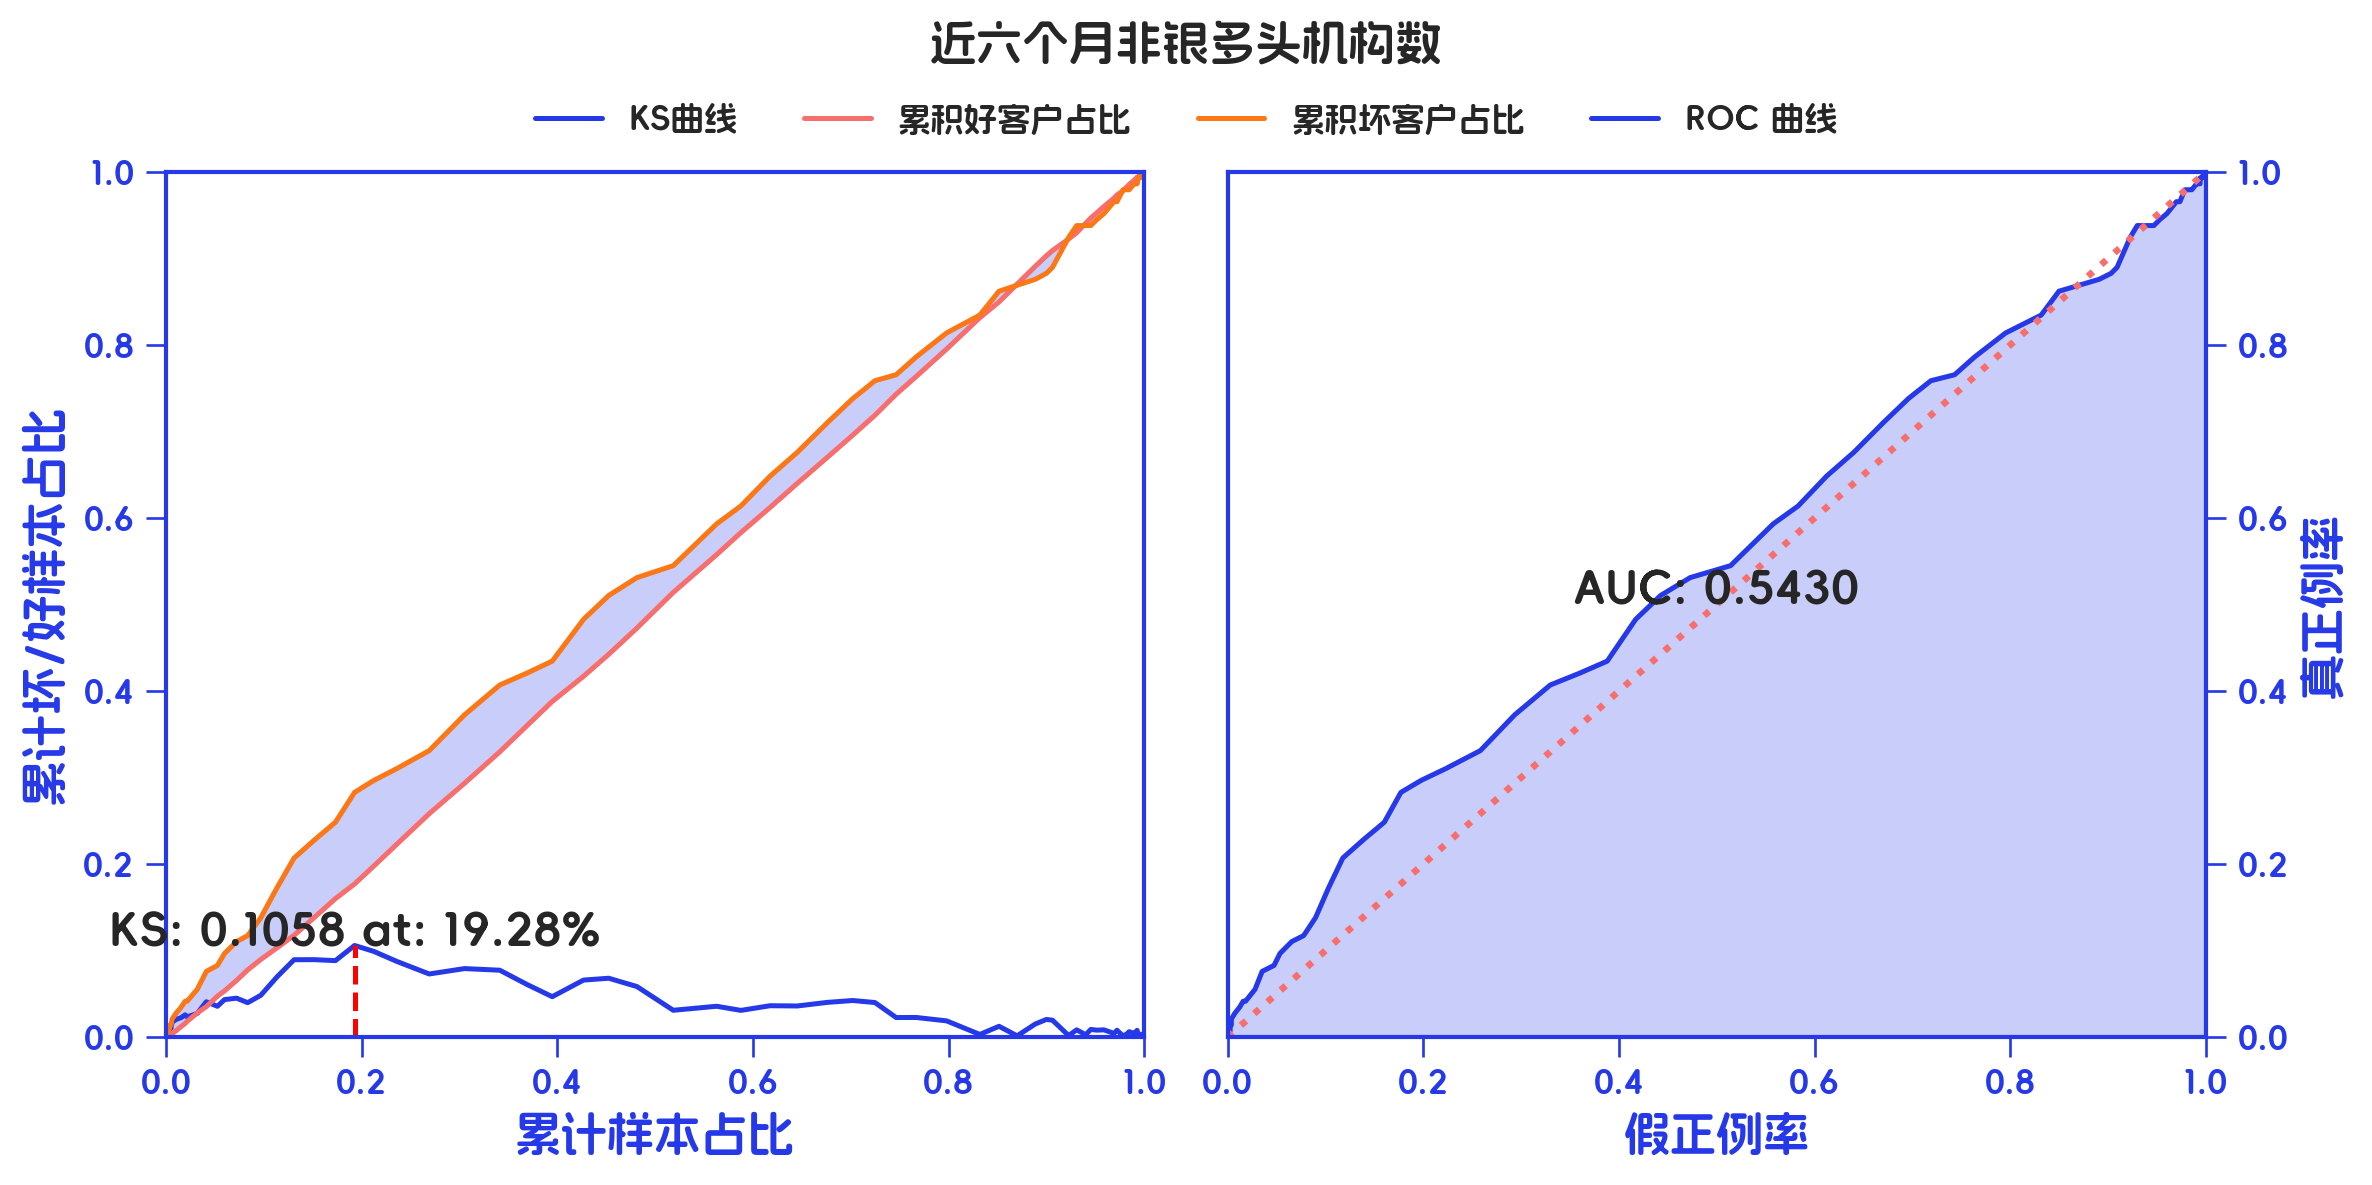
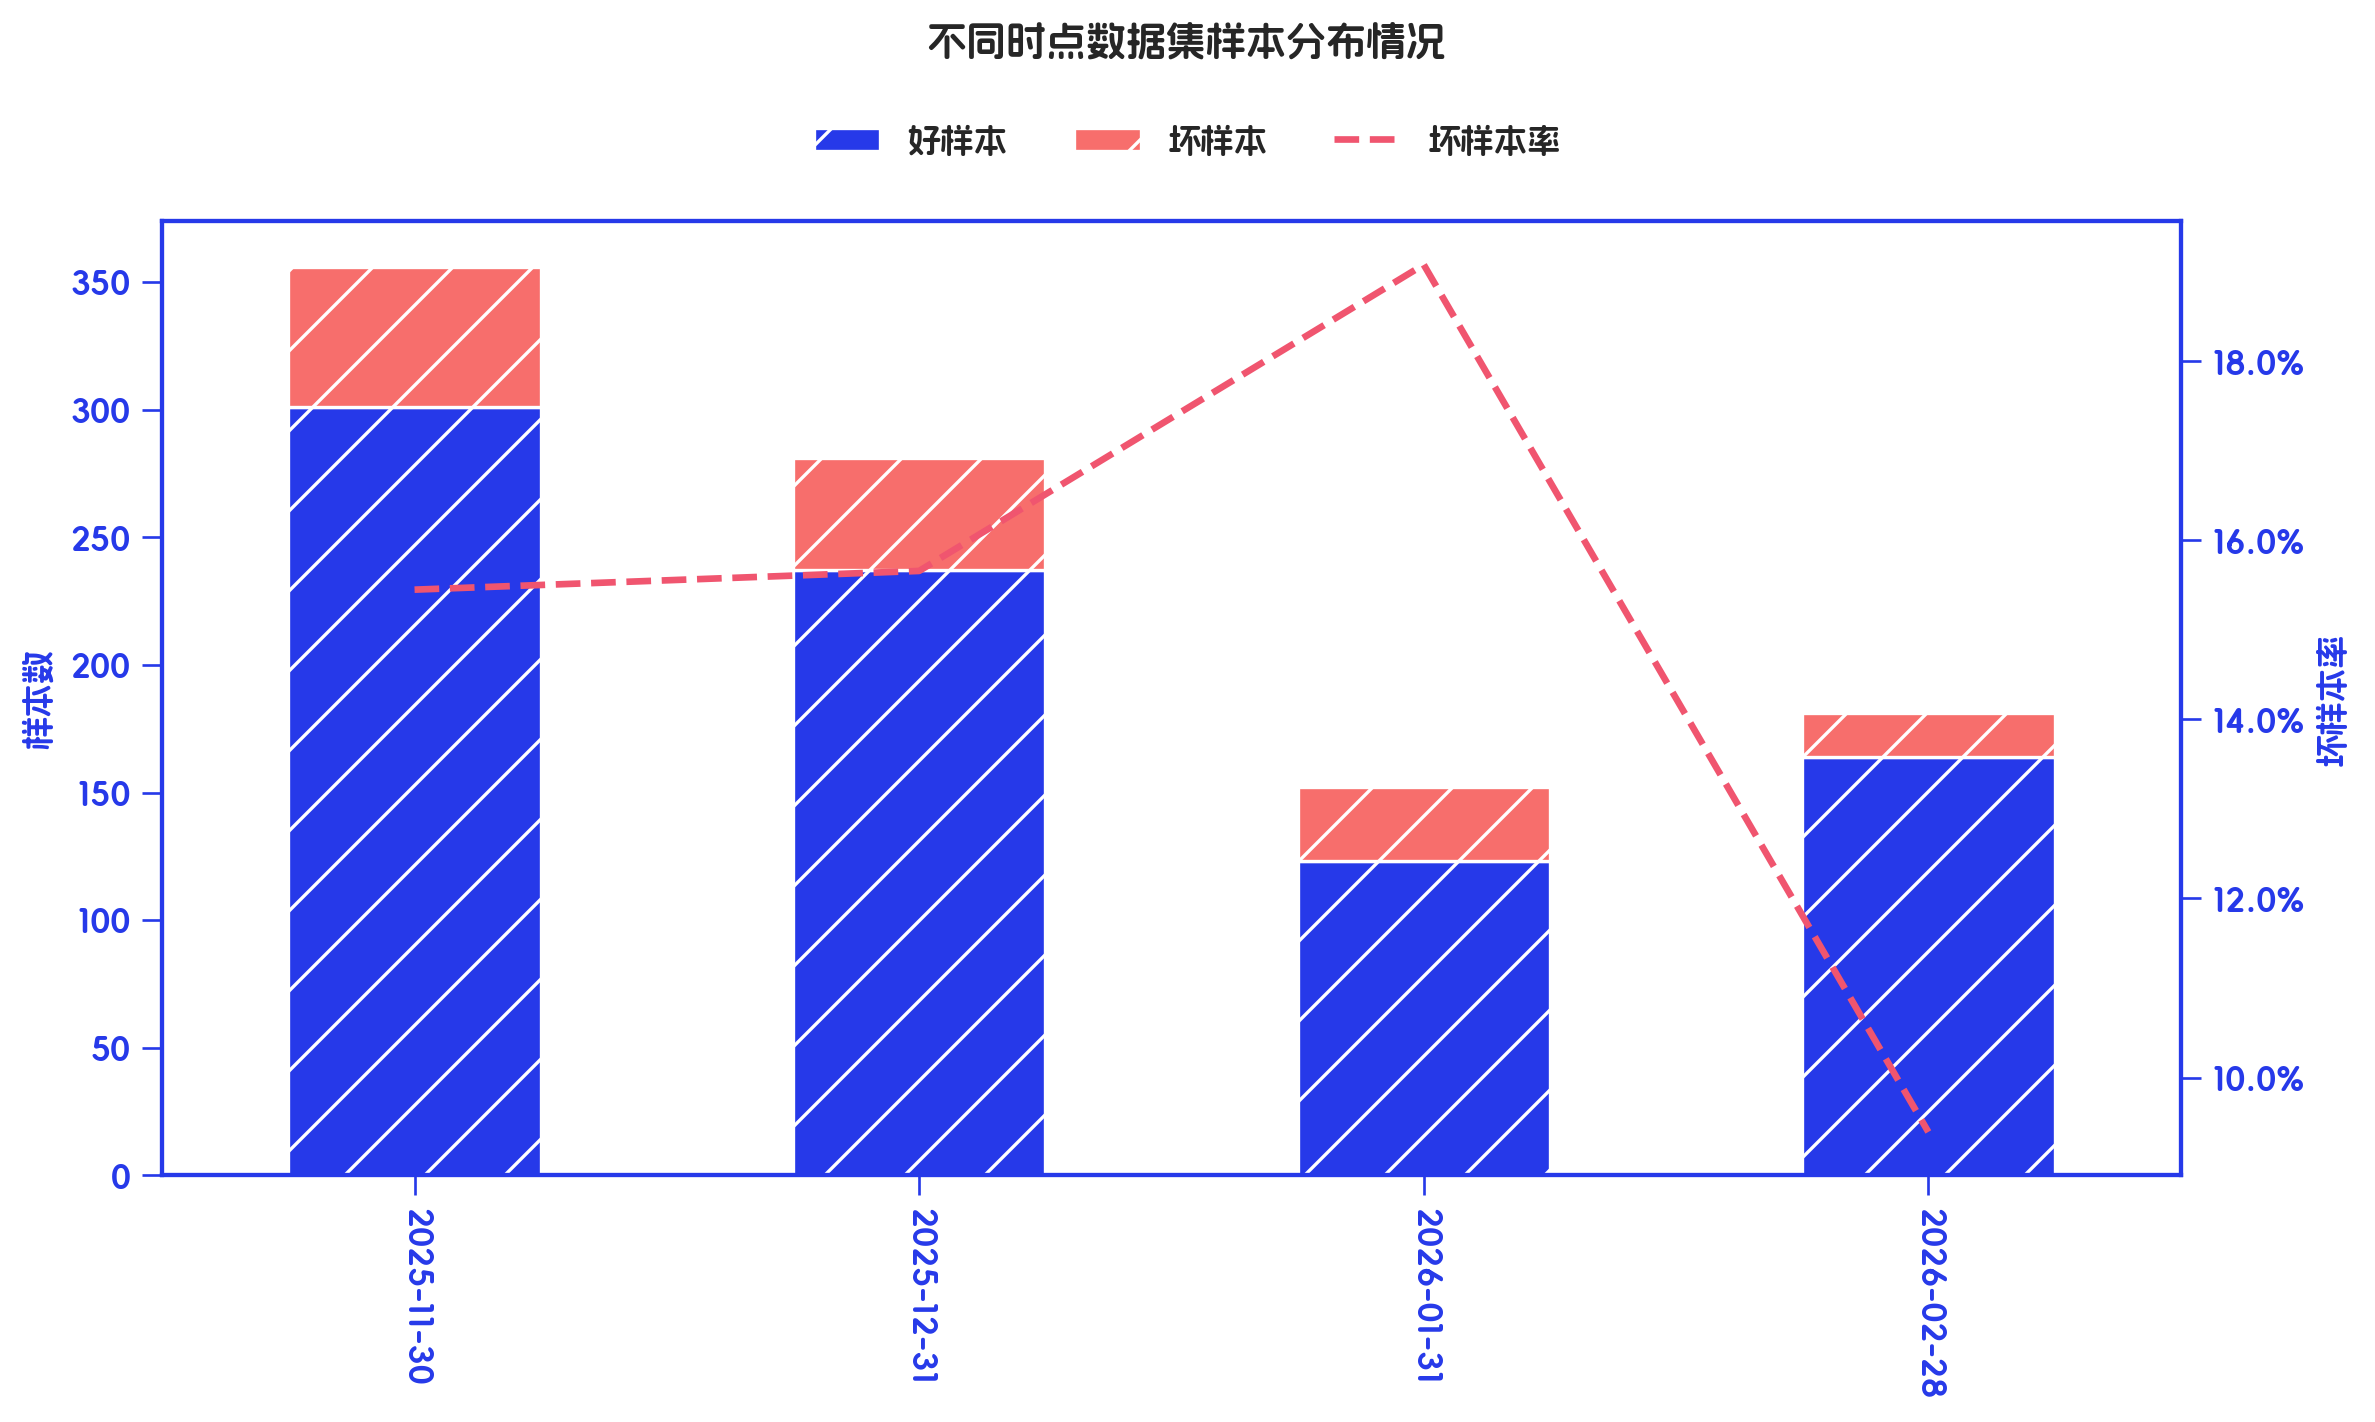
auto_feature_analysis:多 DPD、金额与时间分析报告
三特征和三种 MOB1 阈值放入一个报告,原生生成样本概况、月份分布、综合统计、图表及订单/金额分箱表。strict 模式只有必需章节成功才发布工作簿。工作簿保留报告方法本身的格式,包括其将 Lift 显示为百分比的默认行为;下方完整返回表另存的 Excel 则把 Lift 保持为倍率。
feature_report = auto_feature_analysis(
    df, features=features, overdue=["MOB1"], dpds=[7, 3, 0],
    amount="放款金额", date="放款时间", margins=True,
    bin_params={"method": "quantile", "max_n_bins": 4, "n_jobs": 1},
    excel_writer=str(ASSET_DIR / "auto-feature-report.xlsx"),
    output_dir=str(ASSET_DIR / "auto-feature-plots"),
    n_jobs=1, mode="strict", return_result=True,
)
display(feature_report.status_table())
展开自动报告生成的全部原生图表
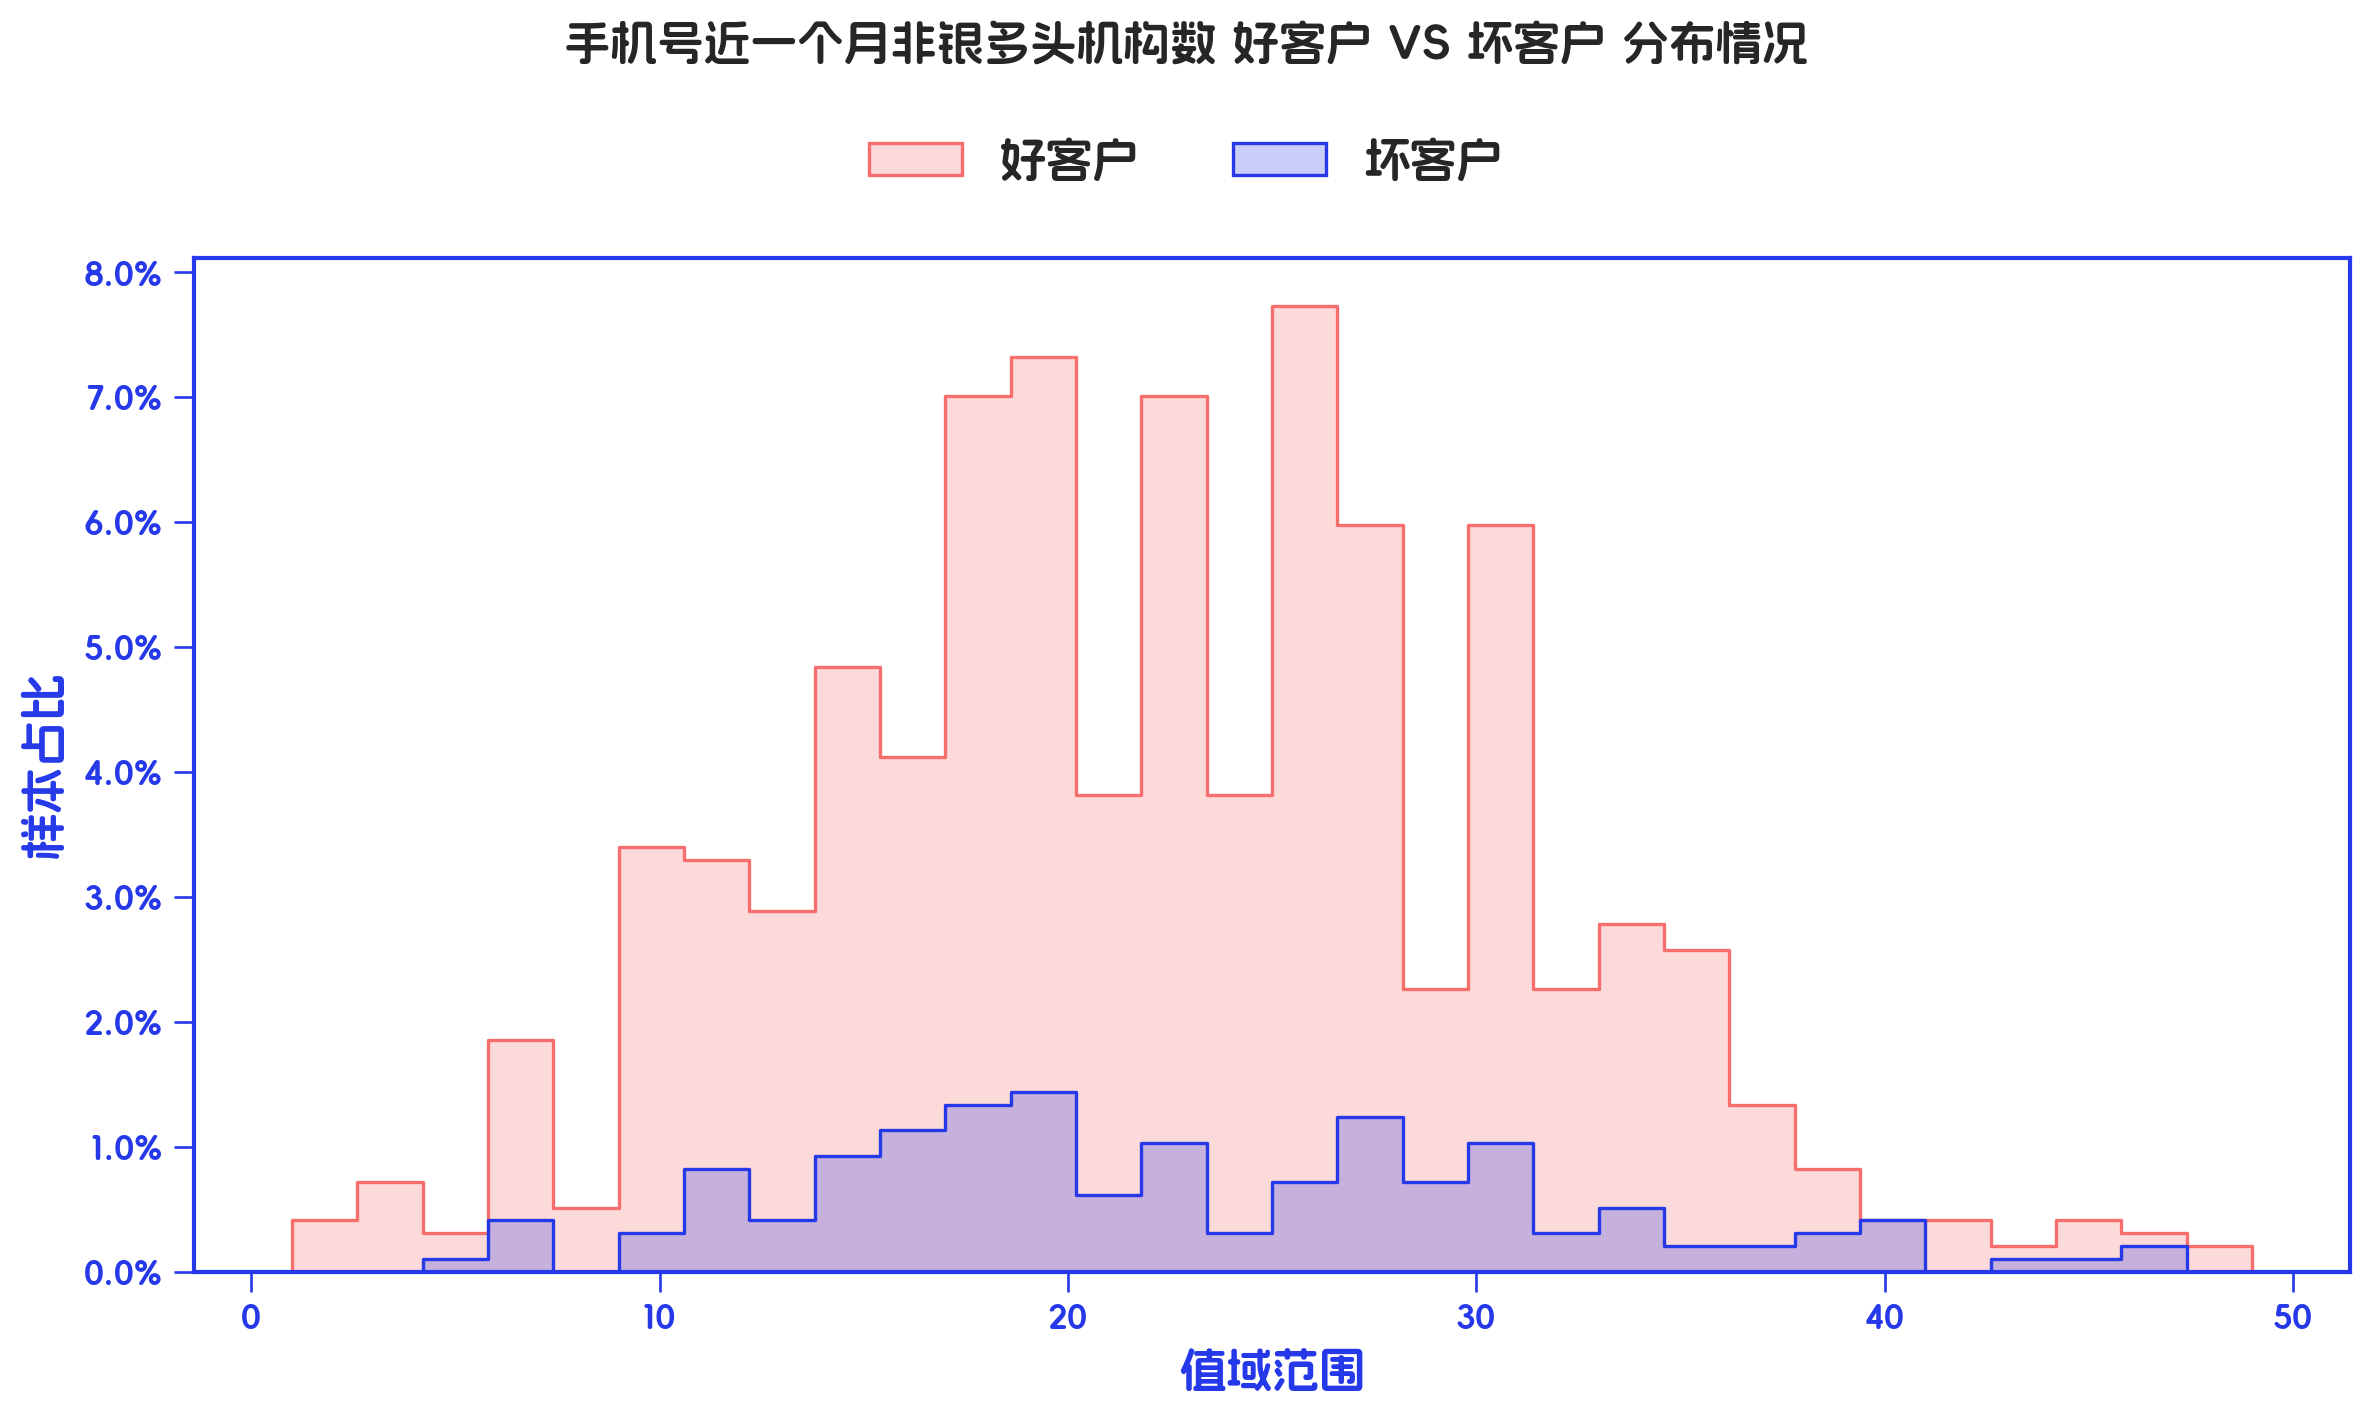
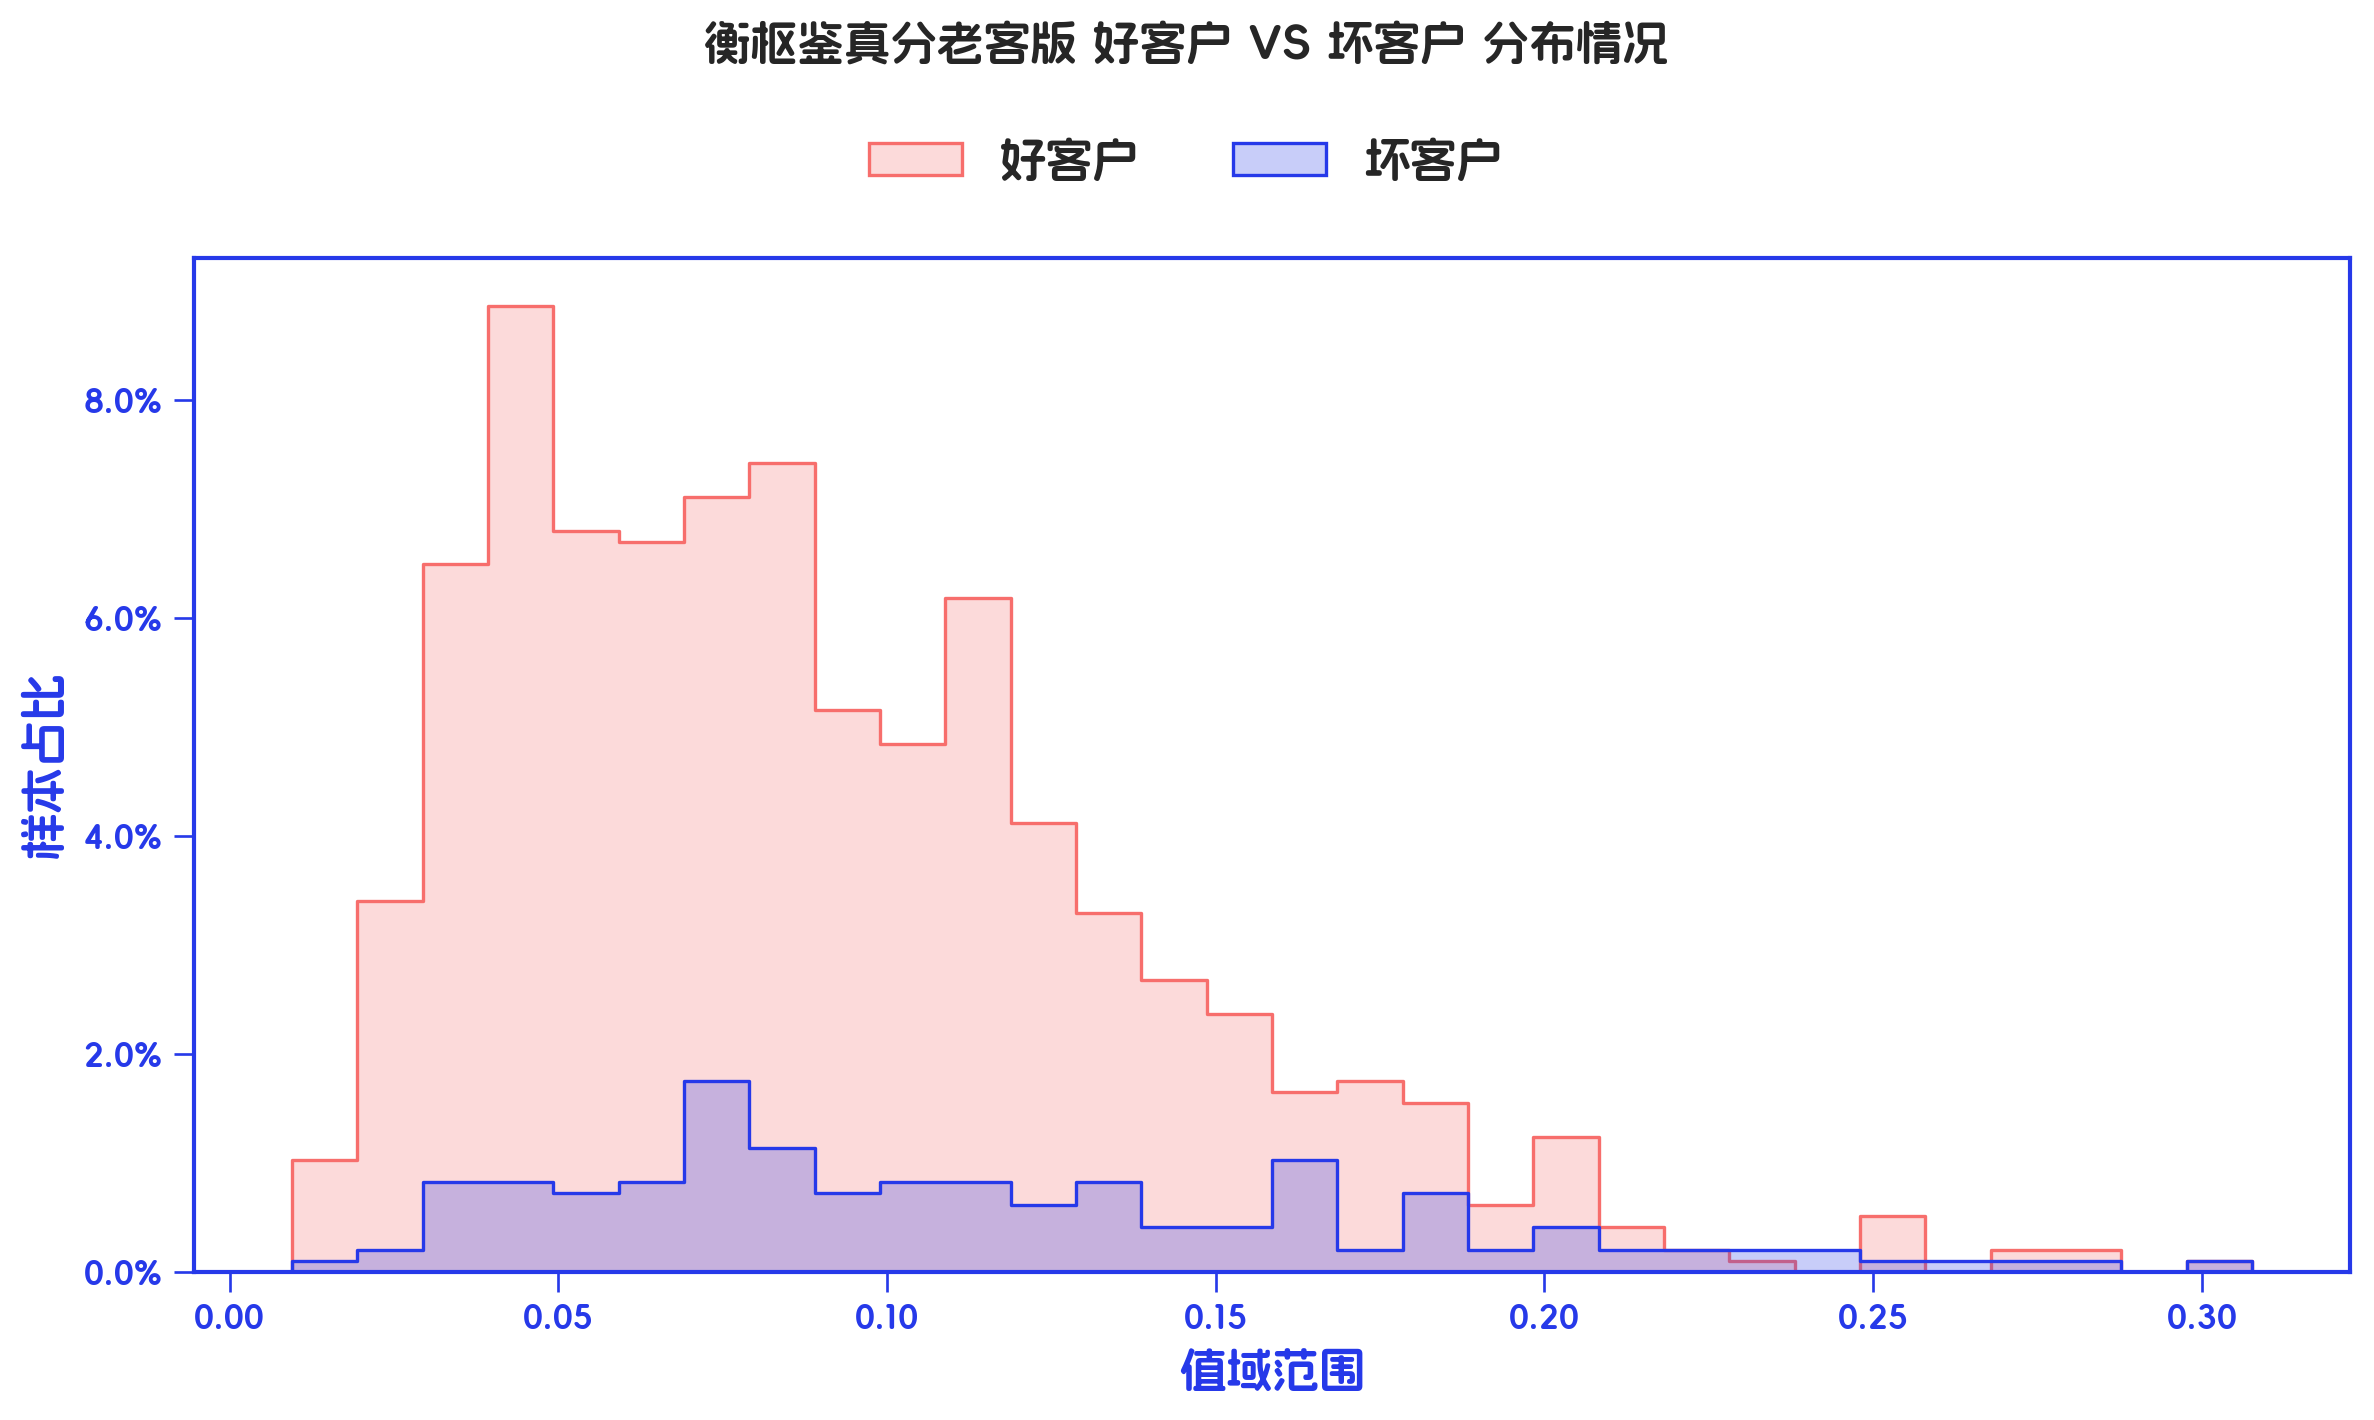
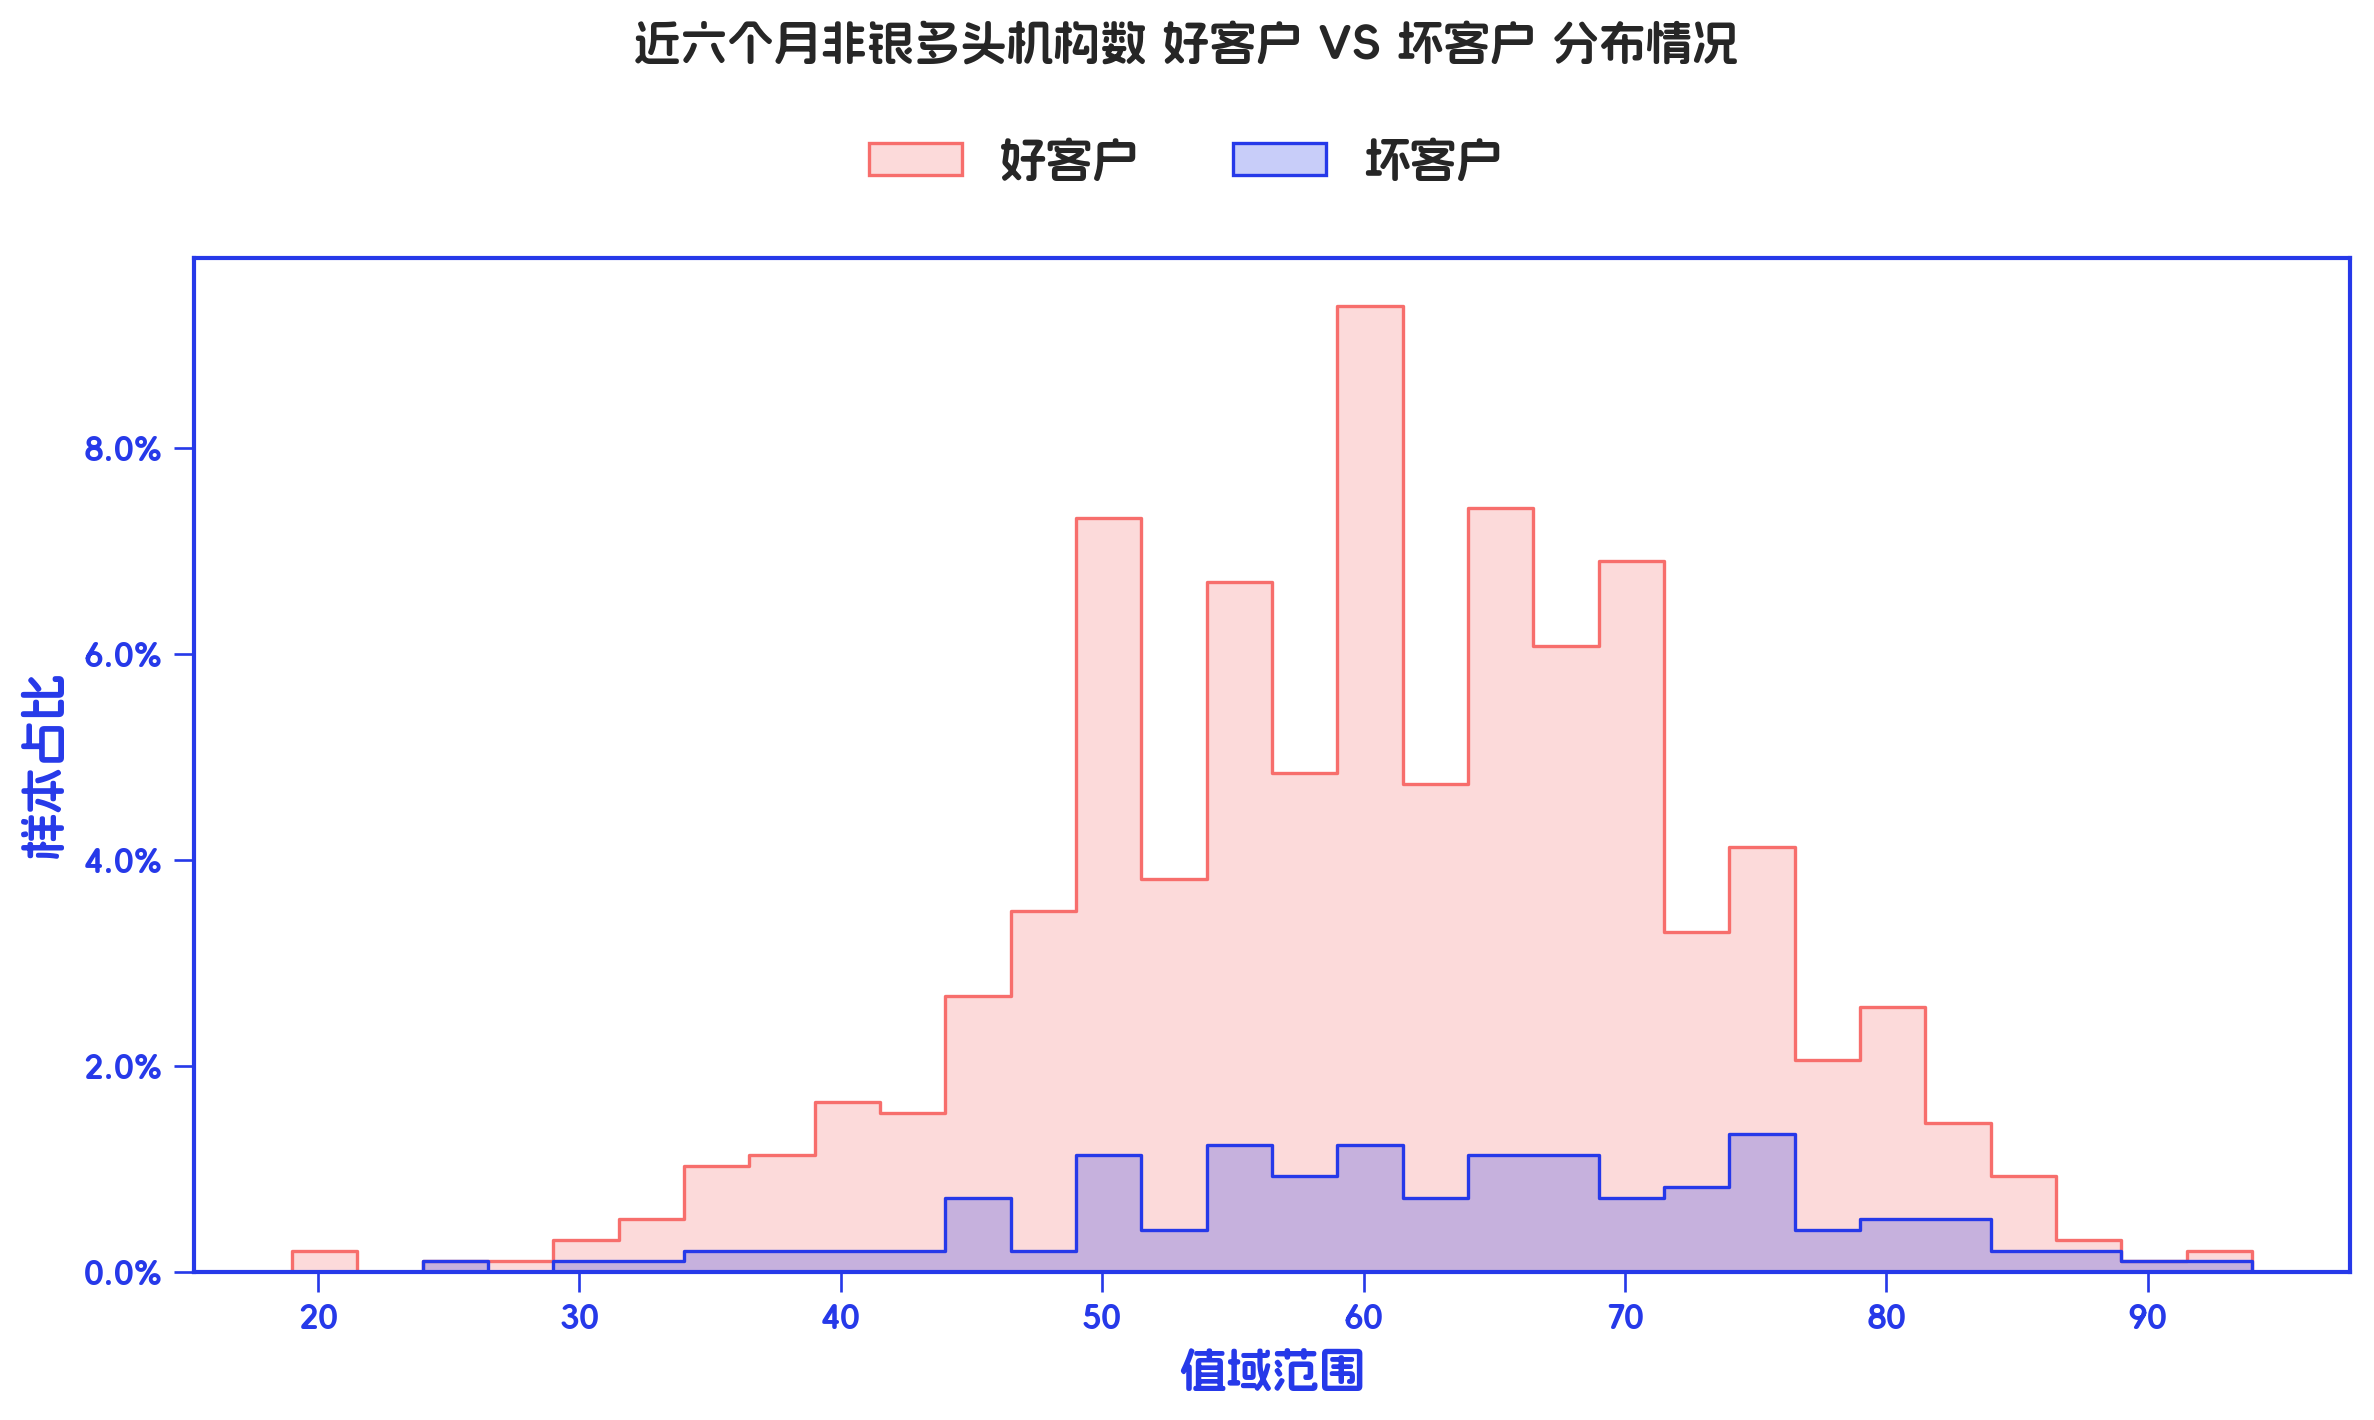
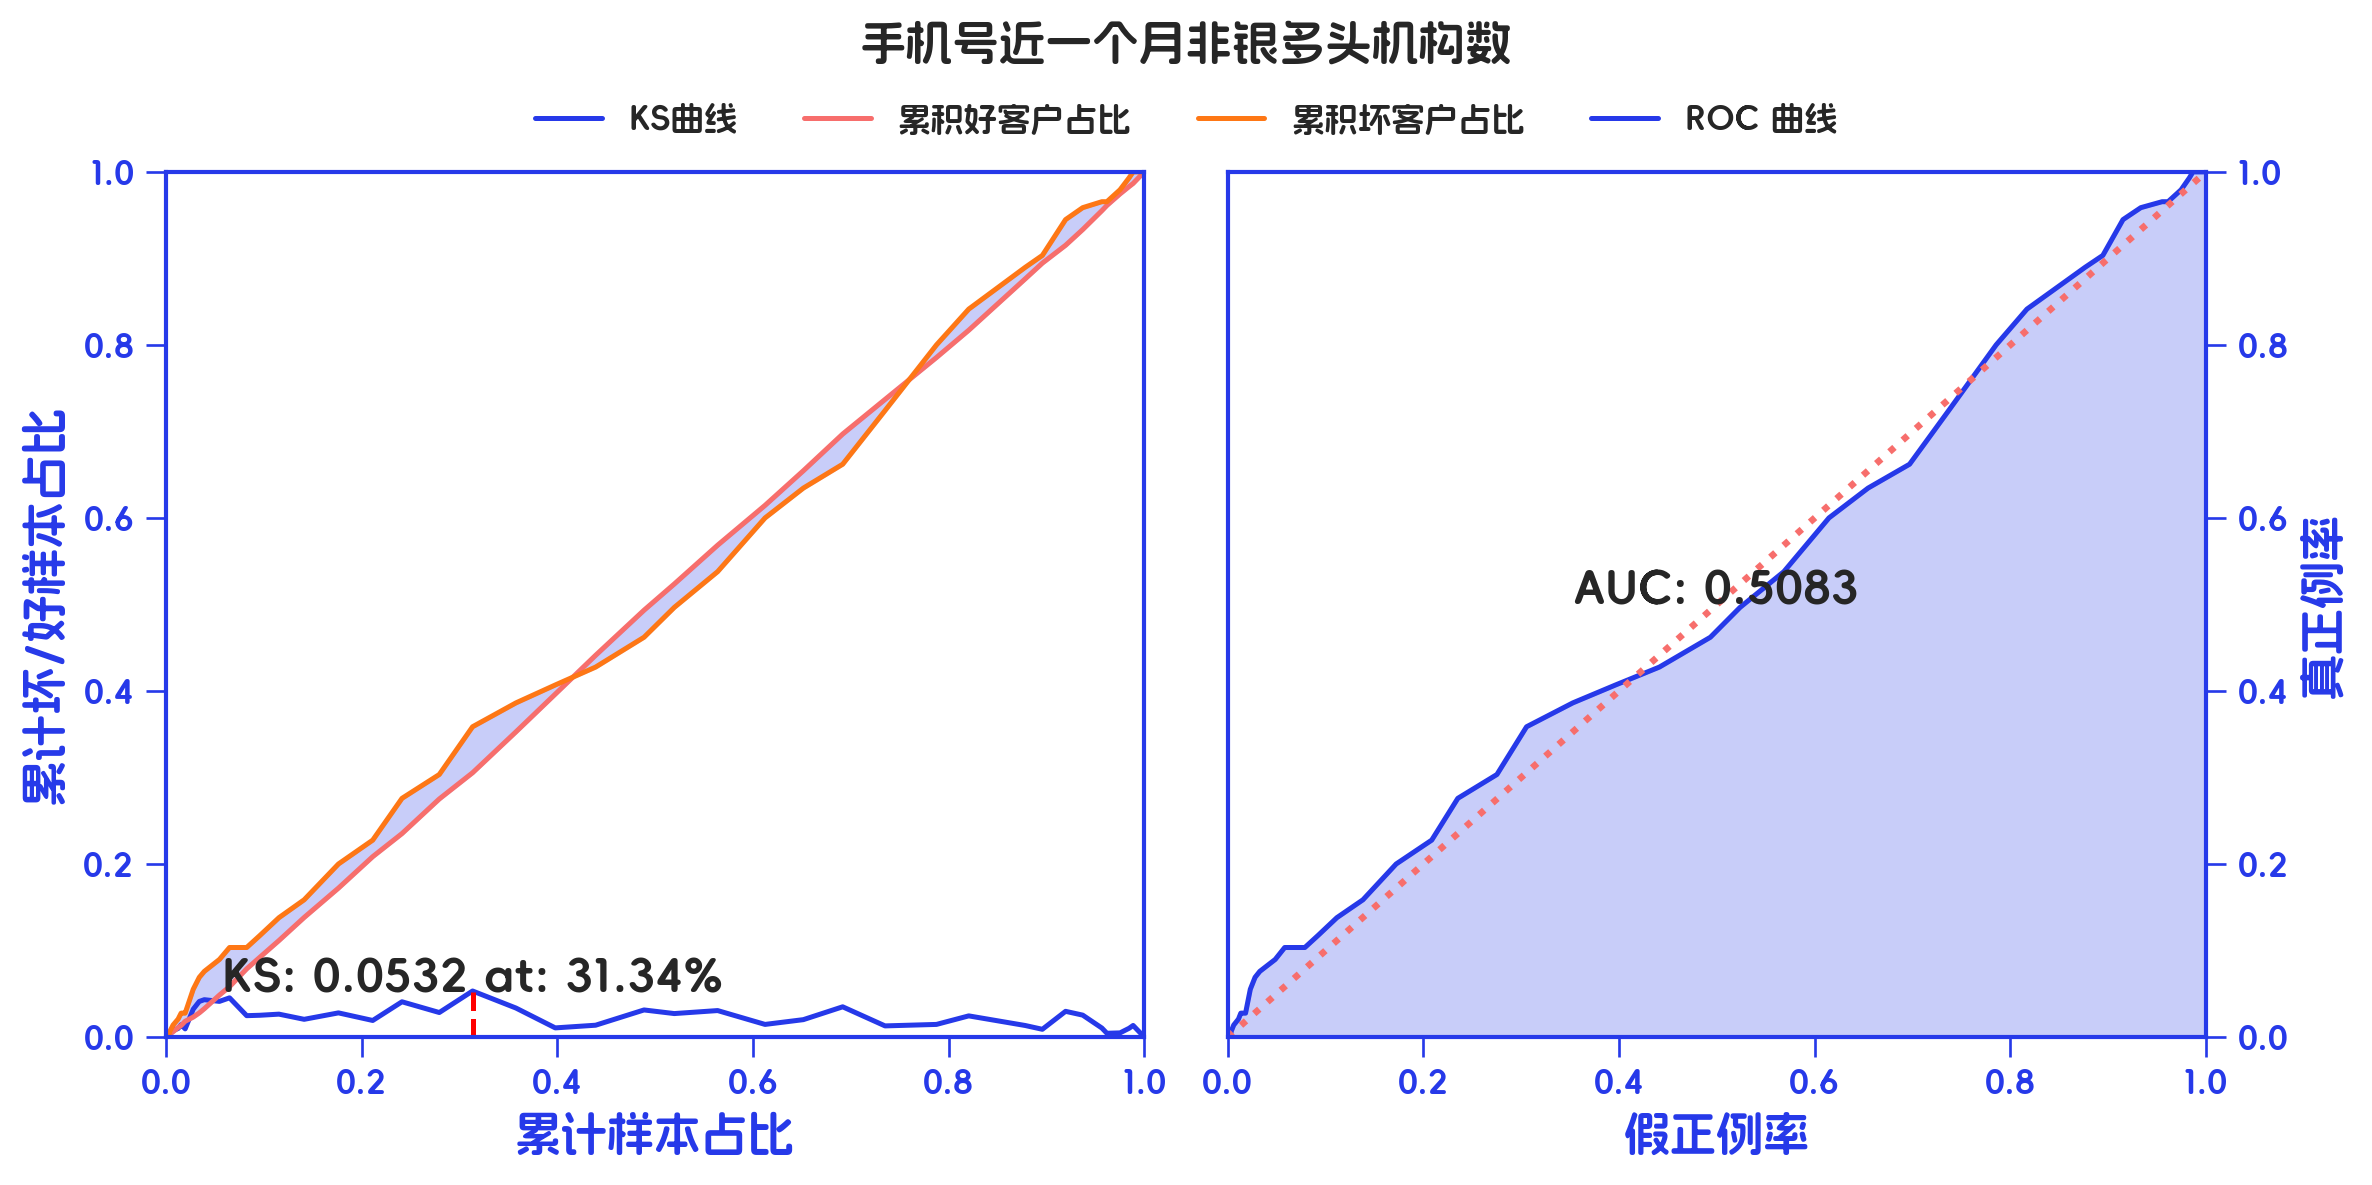
查看所有完整返回表与 Excel
feature_report/样本总体分布:1 行 × 10 列;完整 HTML · Excel:原始表1feature_report/变量综合统计:3 行 × 30 列;完整 HTML · Excel:原始表2feature_report/时间分布:4 行 × 12 列;完整 HTML · Excel:原始表3feature_report/特征分箱:衡枢鉴真分老客版:5 行 × 56 列;完整 HTML · Excel:原始表4feature_report/金额分箱:衡枢鉴真分老客版:5 行 × 56 列;完整 HTML · Excel:原始表5feature_report/特征分箱:近六个月非银多头机构数:5 行 × 56 列;完整 HTML · Excel:原始表6feature_report/金额分箱:近六个月非银多头机构数:5 行 × 56 列;完整 HTML · Excel:原始表7feature_report/特征分箱:手机号近一个月非银多头机构数:5 行 × 56 列;完整 HTML · Excel:原始表8feature_report/金额分箱:手机号近一个月非银多头机构数:5 行 × 56 列;完整 HTML · Excel:原始表9
完整可重跑代码:binning_eda.py。
4. 多个筛选器组合与筛选报告
多个筛选器组合与完整过程报告
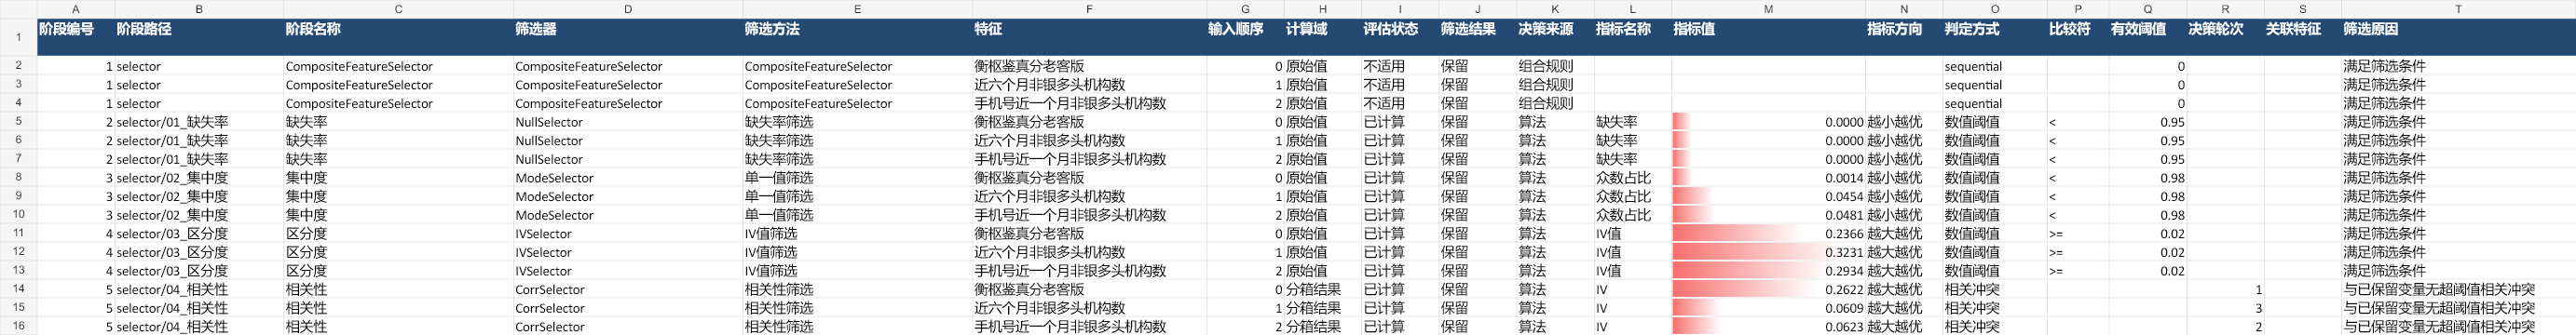
依次应用缺失率、集中度、IV 和相关性筛选。get_selection_report_df() 返回包含各子步骤的完整决策,collect_selection_report() 直接收集已拟合步骤的汇总、逐特征决策、指标明细和迭代事件;下面保留每张表的全部行列,未将多阶段结果改写为手工摘要。
from hscredit.core.selectors import (
    CompositeFeatureSelector, NullSelector, ModeSelector,
    IVSelector, CorrSelector, collect_selection_report,
)
from hscredit.excel import ExcelWriter

selector = CompositeFeatureSelector(
    [
        ("缺失率", NullSelector(threshold=0.95)),
        ("集中度", ModeSelector(threshold=0.98)),
        ("区分度", IVSelector(threshold=0.02)),
        ("相关性", CorrSelector(threshold=0.85)),
    ],
    strategy="sequential",
    n_jobs=1,
).fit(X_train, y_train)

selection_details = selector.get_selection_report_df()
selection_report = collect_selection_report(selector)
display(selection_details)
display(selection_report.summary)
display(selection_report.metrics)
display(selection_report.history)

X_train_selected = selector.transform(X_train)
X_test_selected = selector.transform(X_test)

selection_paths = selection_report.save(strategy_dir / "组合筛选完整报告", overwrite=True)


# 读取完整原生工作簿,将显示样式另存为展示工作簿。
selection_file = selection_paths["路径"]["xlsx"]
selection_display_file = strategy_dir / "组合筛选展示.xlsx"
with ExcelWriter(style_excel=selection_file) as style_writer:
    for sheet_name, column_name, number_format in (
        ("筛选汇总", "保留率", "0.00%"),
        ("特征决策", "指标值", "0.0000"),
    ):
        worksheet = style_writer.get_sheet_by_name(sheet_name)
        column = next(cell.column_letter for cell in worksheet[1]
                      if cell.value == column_name)
        start, end = f"{column}2", f"{column}{worksheet.max_row}"
        style_writer.set_number_format(worksheet, f"{start}:{end}", number_format)
        style_writer.add_conditional_formatting(worksheet, start, end)
        style_writer.adjust_columns_width(worksheet)
    style_writer.save(selection_display_file)

完整指标明细(66 行 × 12 列,完整返回)
完整迭代事件(3 行 × 18 列,完整返回)
5. 逻辑回归:summary 与权重图
逻辑回归:系数、置信区间与 VIF
hscredit.LogisticRegression 在 sklearn 接口基础上提供统计摘要;plot_weights 直接读取同一模型的系数与置信区间。
from pathlib import Path
from hscredit import LogisticRegression
from hscredit.core.viz import plot_weights

model_assets = Path("docs/assets/readme/models")
model_assets.mkdir(parents=True, exist_ok=True)

lr = LogisticRegression(
    solver="liblinear", max_iter=1000, n_jobs=1, random_state=42
).fit(X_train, y_train)
lr.summary()
| Coef. | Std.Err | z | P>|z| | [0.025 | 0.975] | VIF | |
|---|---|---|---|---|---|---|---|
| const | -1.7819 | 0.5435 | -3.2787 | 0.0010 | -2.8471 | -0.7167 | 26.4228 |
| 衡枢鉴真分老客版 | 1.5860 | 2.0179 | 0.7860 | 0.4319 | -2.3690 | 5.5410 | 1.0633 |
| 近六个月非银多头机构数 | -0.0055 | 0.0107 | -0.5185 | 0.6041 | -0.0265 | 0.0154 | 1.4954 |
| 手机号近一个月非银多头机构数 | 0.0077 | 0.0150 | 0.5103 | 0.6098 | -0.0218 | 0.0372 | 1.4667 |
figure = plot_weights(lr, save=str(model_assets / "logistic-weights.png"))
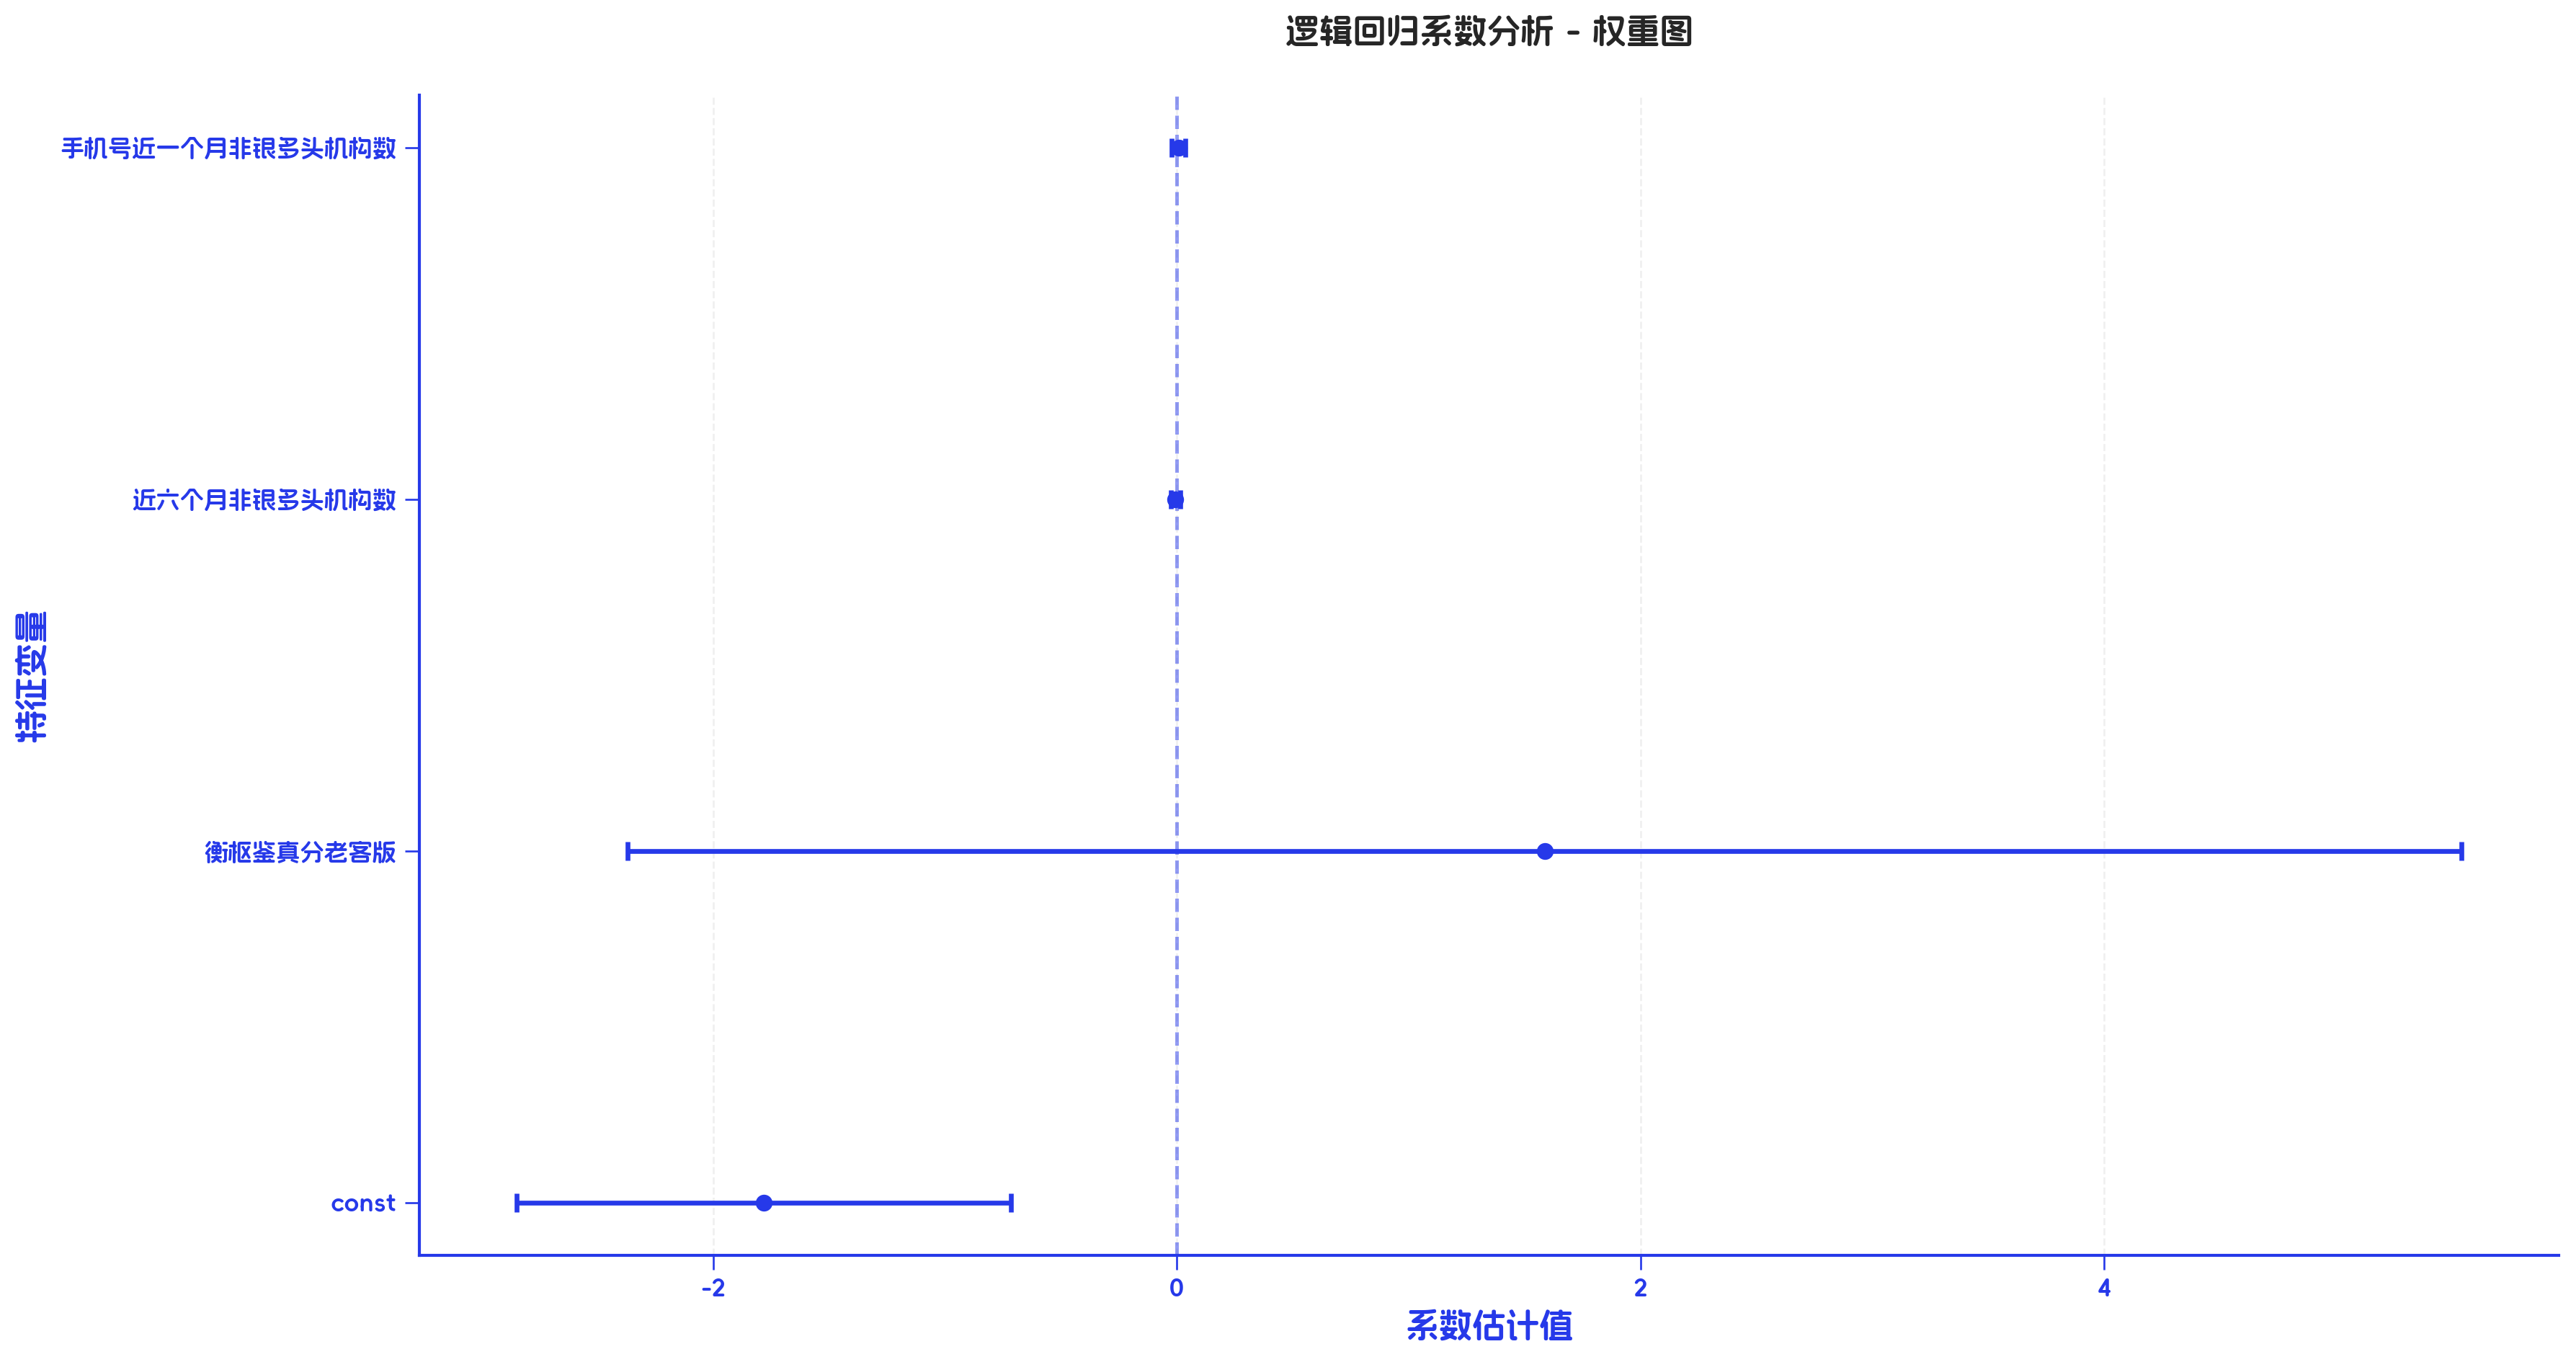
summary() 原生字段名为 Coef.、Std.Err、z、P>|z|、置信区间和 VIF;这里保持原样。正则化模型的显著性推断属于近似诊断,具体状态见返回表的 attrs["统计状态"]。
6. 评分卡:基础参数与 points
ScoreCard:WOE 分箱到完整分值表
评分参数决定评分刻度:base_score=650 是基准分,base_odds=35 在 ScoreCard 中表示好坏比 35:1,pdo=50 与 rate=2 表示坏好比每翻倍,信用分下降 50 分。fit(..., input_type="raw") 使用已配置的分箱器完成 WOE 转换;预测时仍传原始特征。
from hscredit import ScoreCard
from hscredit.core.binning import OptimalBinning
from hscredit.core.viz import score_distribution_comparison_plot

card_binner = OptimalBinning(method="quantile", max_n_bins=4, n_jobs=1)
card_binner.fit(X_train, y_train)
card = ScoreCard(
    binner=card_binner,
    base_score=650,
    pdo=50,
    rate=2,
    base_odds=35,
    lr_kwargs={
        "solver": "liblinear", "max_iter": 1000,
        "n_jobs": 1, "random_state": 42,
    },
)
card.fit(X_train, y_train, input_type="raw")
card.export(to_frame=True)
| name | value | score | |
|---|---|---|---|
| 0 | 衡枢鉴真分老客版 | [-inf, 0.0532) | 18.3759 |
| 1 | 衡枢鉴真分老客版 | [0.0532, 0.0840) | 7.5274 |
| 2 | 衡枢鉴真分老客版 | [0.0840, 0.1244) | 22.1584 |
| 3 | 衡枢鉴真分老客版 | [0.1244, +inf) | -35.9394 |
| 4 | 近六个月非银多头机构数 | [-inf, 52) | -0.6933 |
| 5 | 近六个月非银多头机构数 | [52, 61) | 0.5677 |
| 6 | 近六个月非银多头机构数 | [61, 69) | 17.6398 |
| 7 | 近六个月非银多头机构数 | [69, +inf) | -12.7307 |
| 8 | 手机号近一个月非银多头机构数 | [-inf, 16) | 4.0360 |
| 9 | 手机号近一个月非银多头机构数 | [16, 22) | -2.0554 |
| 10 | 手机号近一个月非银多头机构数 | [22, 28) | 8.9923 |
| 11 | 手机号近一个月非银多头机构数 | [28, +inf) | -7.3485 |
figure = score_distribution_comparison_plot(
    {"训练集": card.predict(X_train), "测试集": card.predict(X_test)},
    save=str(model_assets / "scorecard-distribution.png"),
)
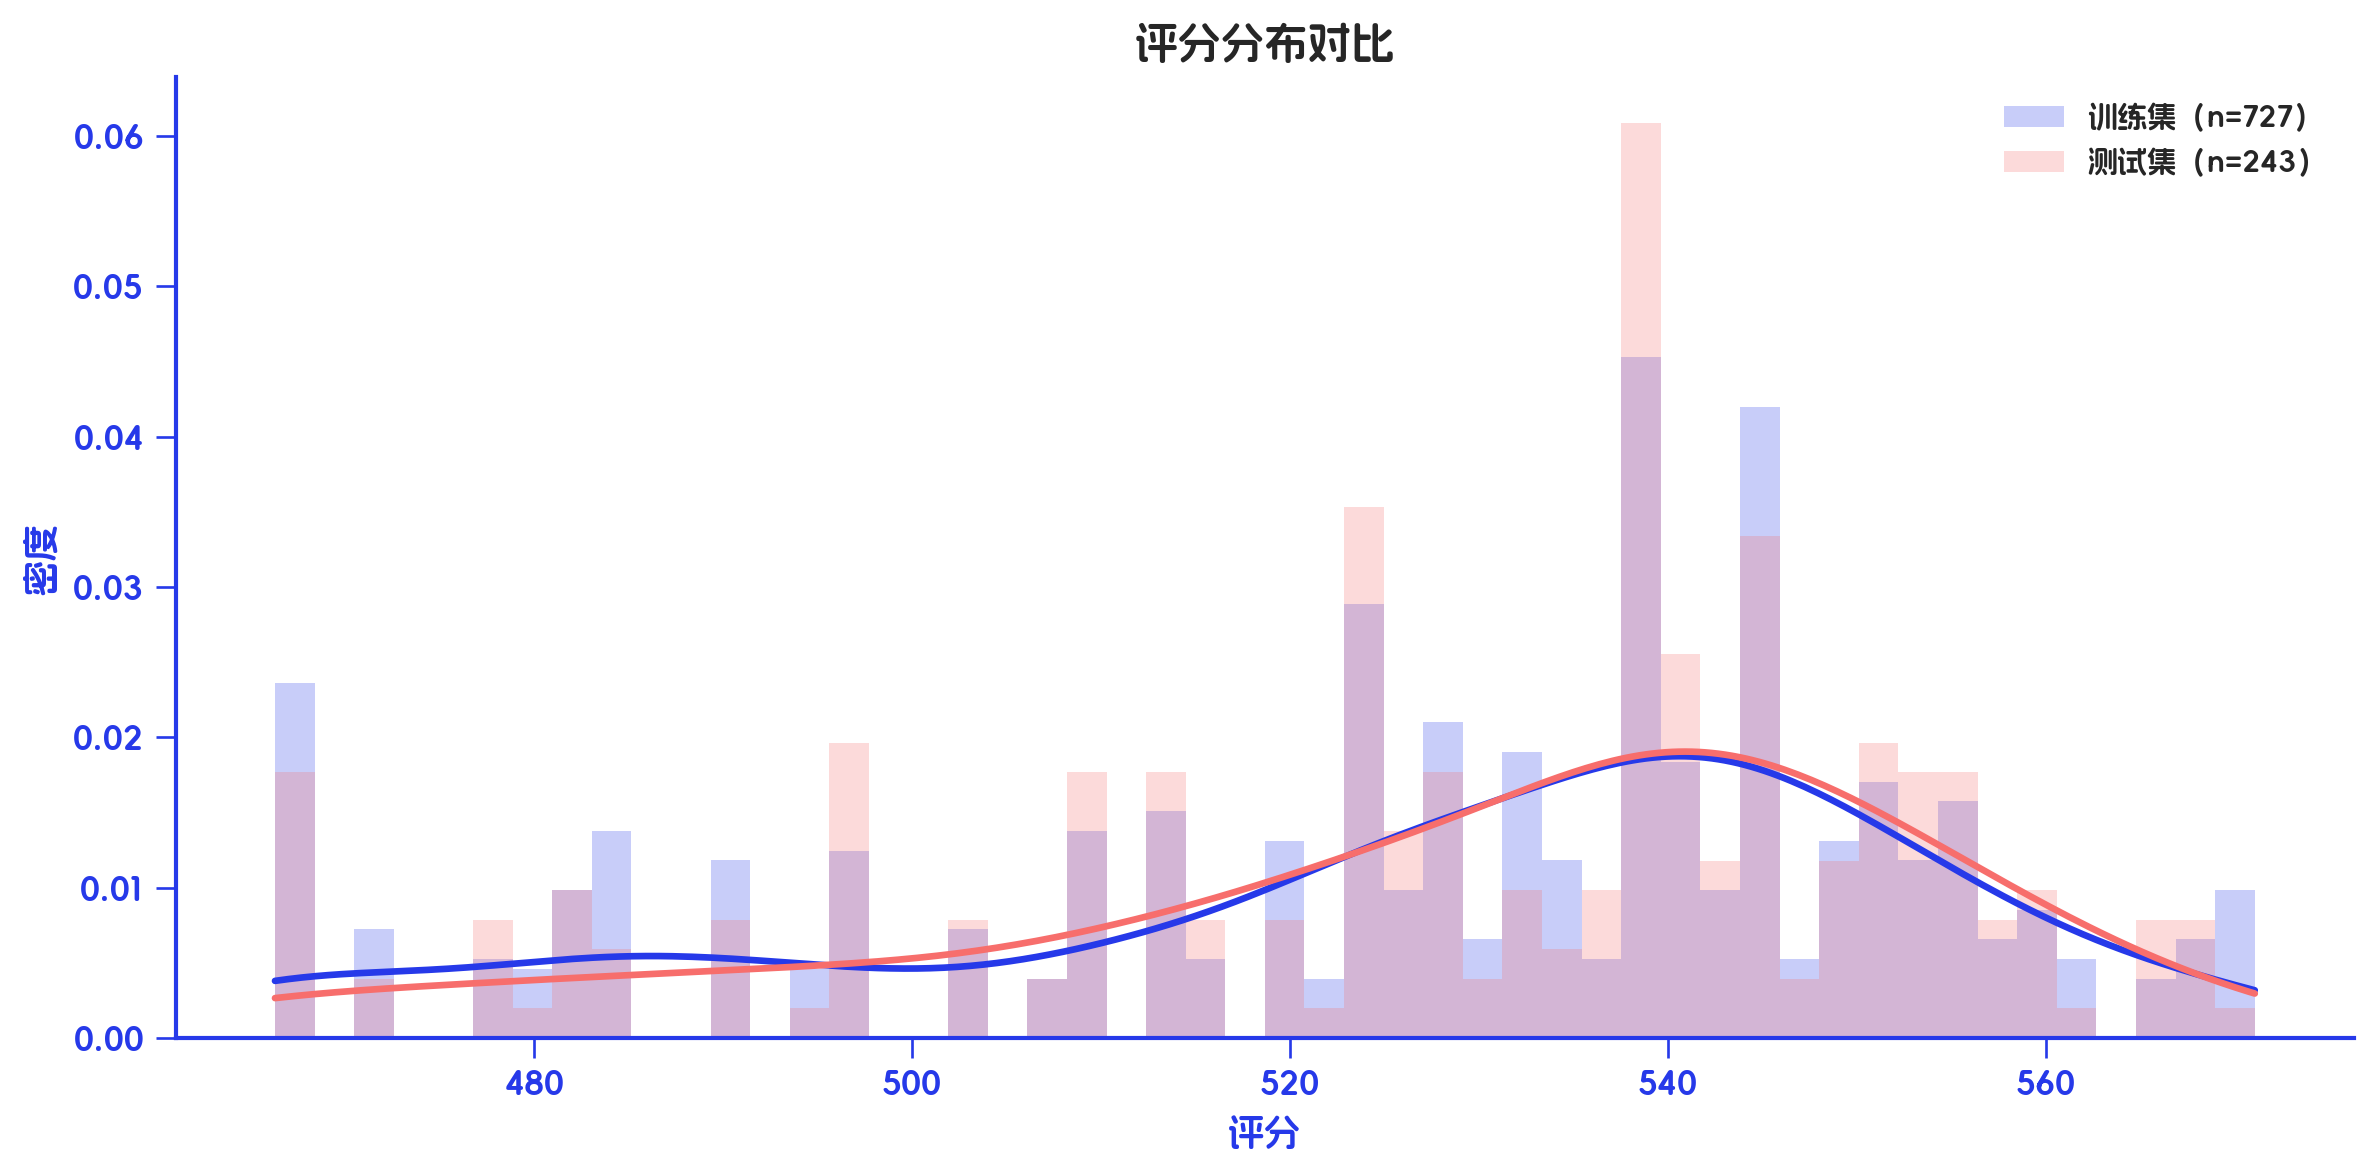
下载完整分值表 Excel。表中的 name / value / score 来自 ScoreCard.export(to_frame=True) 的原始返回。
7. 规则集评估与策略置换
Rule 组合、先验规则与规则集分析
通过 &、|、~ 将衡枢风险分、近六个月多头、手机号近期多头和白名单组合为可执行规则,并用 商品类别 规则评估存量策略。amount="放款金额" 使用金额口径;保留方法原始列名与多级表头,不将金额数值改写为人数。ruleset_analysis 展示逐规则与整体规则效果。
from hscredit.core.rules import Rule
from hscredit.report import ruleset_analysis

risk_score = Rule("衡枢鉴真分老客版 >= 0.15", name="风险分偏高")
high_multi = Rule("近六个月非银多头机构数 >= 70", name="多头偏高")
phone_multi = Rule("手机号近一个月非银多头机构数 >= 28", name="近期多头偏高")
whitelist = Rule("衡枢鉴真分老客版 < 0.03", name="低风险白名单")
prior_rule = Rule("商品类别 == '礼包'", name="存量商品规则")
combined_rule = ((risk_score & high_multi) | phone_multi) & ~whitelist

rule_report = combined_rule.report(
    df, target="FPD", overdue=["MOB1"], dpds=[7, 3, 0],
    prior_rules=prior_rule, amount="放款金额", margins=True, n_jobs=1,
)
display(rule_report)
rule_report.save(
    strategy_dir / "组合规则完整评估.xlsx", auto_width=True,
    percent_cols=["样本占比", "好样本占比", "坏样本占比", "坏样本率",
                  "坏账改善", "准确率", "精确率", "召回率", "F1分数"],
    condition_cols=["LIFT值"],
)

ruleset_report = ruleset_analysis(
    df, rules=[risk_score, high_multi, phone_multi], target="FPD",
    overdue=["MOB1"], dpds=[7, 3, 0], amount="放款金额", n_jobs=1,
)
display(ruleset_report)
ruleset_report.save(
    strategy_dir / "规则集完整评估.xlsx", auto_width=True,
    percent_cols=["样本占比", "好样本占比", "坏样本占比", "坏样本率",
                  "坏账改善", "准确率", "精确率", "召回率", "F1分数"],
    condition_cols=["LIFT值"],
)


规则置入与置出
衡枢鉴真分老客版在本例按高值偏高风险使用,高值规则用于拒绝,低值规则用于白名单。置入风险按历史训练样本各分箱的真实坏样本率估计,不将高风险分当作高信用分。验证样本用于策略置换。生产基础拒绝、置出与置入按方法原生流程依次分析;sample_survival_rate=0.70 和 out_in_uplift=2.0 是本例的情景输入,后者上浮置入客群的预测风险。返回字典中的两张表均完整展示。
from hscredit.report import rule_swap_analysis

swap = rule_swap_analysis(
    data=test_df,
    score="衡枢鉴真分老客版",
    rules_base=[Rule("衡枢鉴真分老客版 >= 0.25", name="生产基础拒绝")],
    rules_out=[high_multi, phone_multi],
    rules_in=[Rule("近六个月非银多头机构数 < 50", name="低多头置入")],
    reference_data=train_df,
    overdue=["MOB1"], dpds=[7, 3, 0],
    amount="放款金额", sample_survival_rate=0.70,
    out_in_uplift=2.0, max_n_bins=4, n_jobs=1,
)
display(swap["swap_pipeline"])
display(swap["swap_result"])

with ExcelWriter() as writer:
    swap["swap_pipeline"].save(
        writer, sheet_name="完整置换流水线", auto_width=True,
        percent_cols=["样本占比", "金额占比", "通过率(相对值)",
                      "好样本占比", "坏样本占比", "坏样本率",
                      "原始坏样本率", "调整后坏样本率", "坏账改善",
                      "原始坏样本率(金额)", "调整后坏样本率(金额)"],
        condition_cols=["LIFT值"],
    )
    swap["swap_result"].save(
        writer, sheet_name="完整置换对比", auto_width=True,
        percent_cols=["相对变化"], condition_cols=["相对变化"],
    )
    writer.save(strategy_dir / "规则置换完整分析.xlsx")

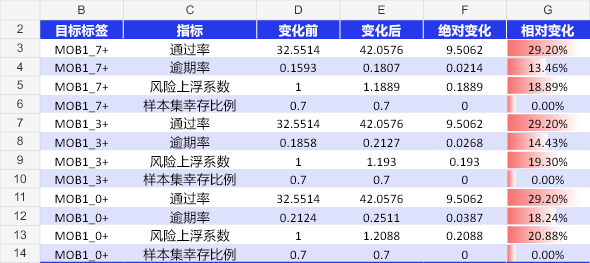
策略迭代报告:swap_out_report
直接生成包含样本描述、相关性、变量分箱、业务影响、规则效果、金额口径和分月稳定性的 Excel。该方法原生返回 ExcelWriter,完整工作簿即报告产物。
from hscredit.report import swap_out_report

strategy_writer = swap_out_report(
    df,
    rules=[risk_score, high_multi, phone_multi],
    background="比较衡枢风险分、近六个月多头和手机号近期多头规则的覆盖与风险表现。",
    target="FPD", overdue=["MOB1"], dpds=[7, 3, 0],
    amount="放款金额", date_col="放款时间", freq="M",
    features=features, methods="quantile",
    bin_params={"max_n_bins": 4},
    current_pass_rate=0.70, n_jobs=1,
    save=str(strategy_dir / "策略迭代完整报告.xlsx"),
)
display(strategy_writer)
查看策略迭代工作表完整截图
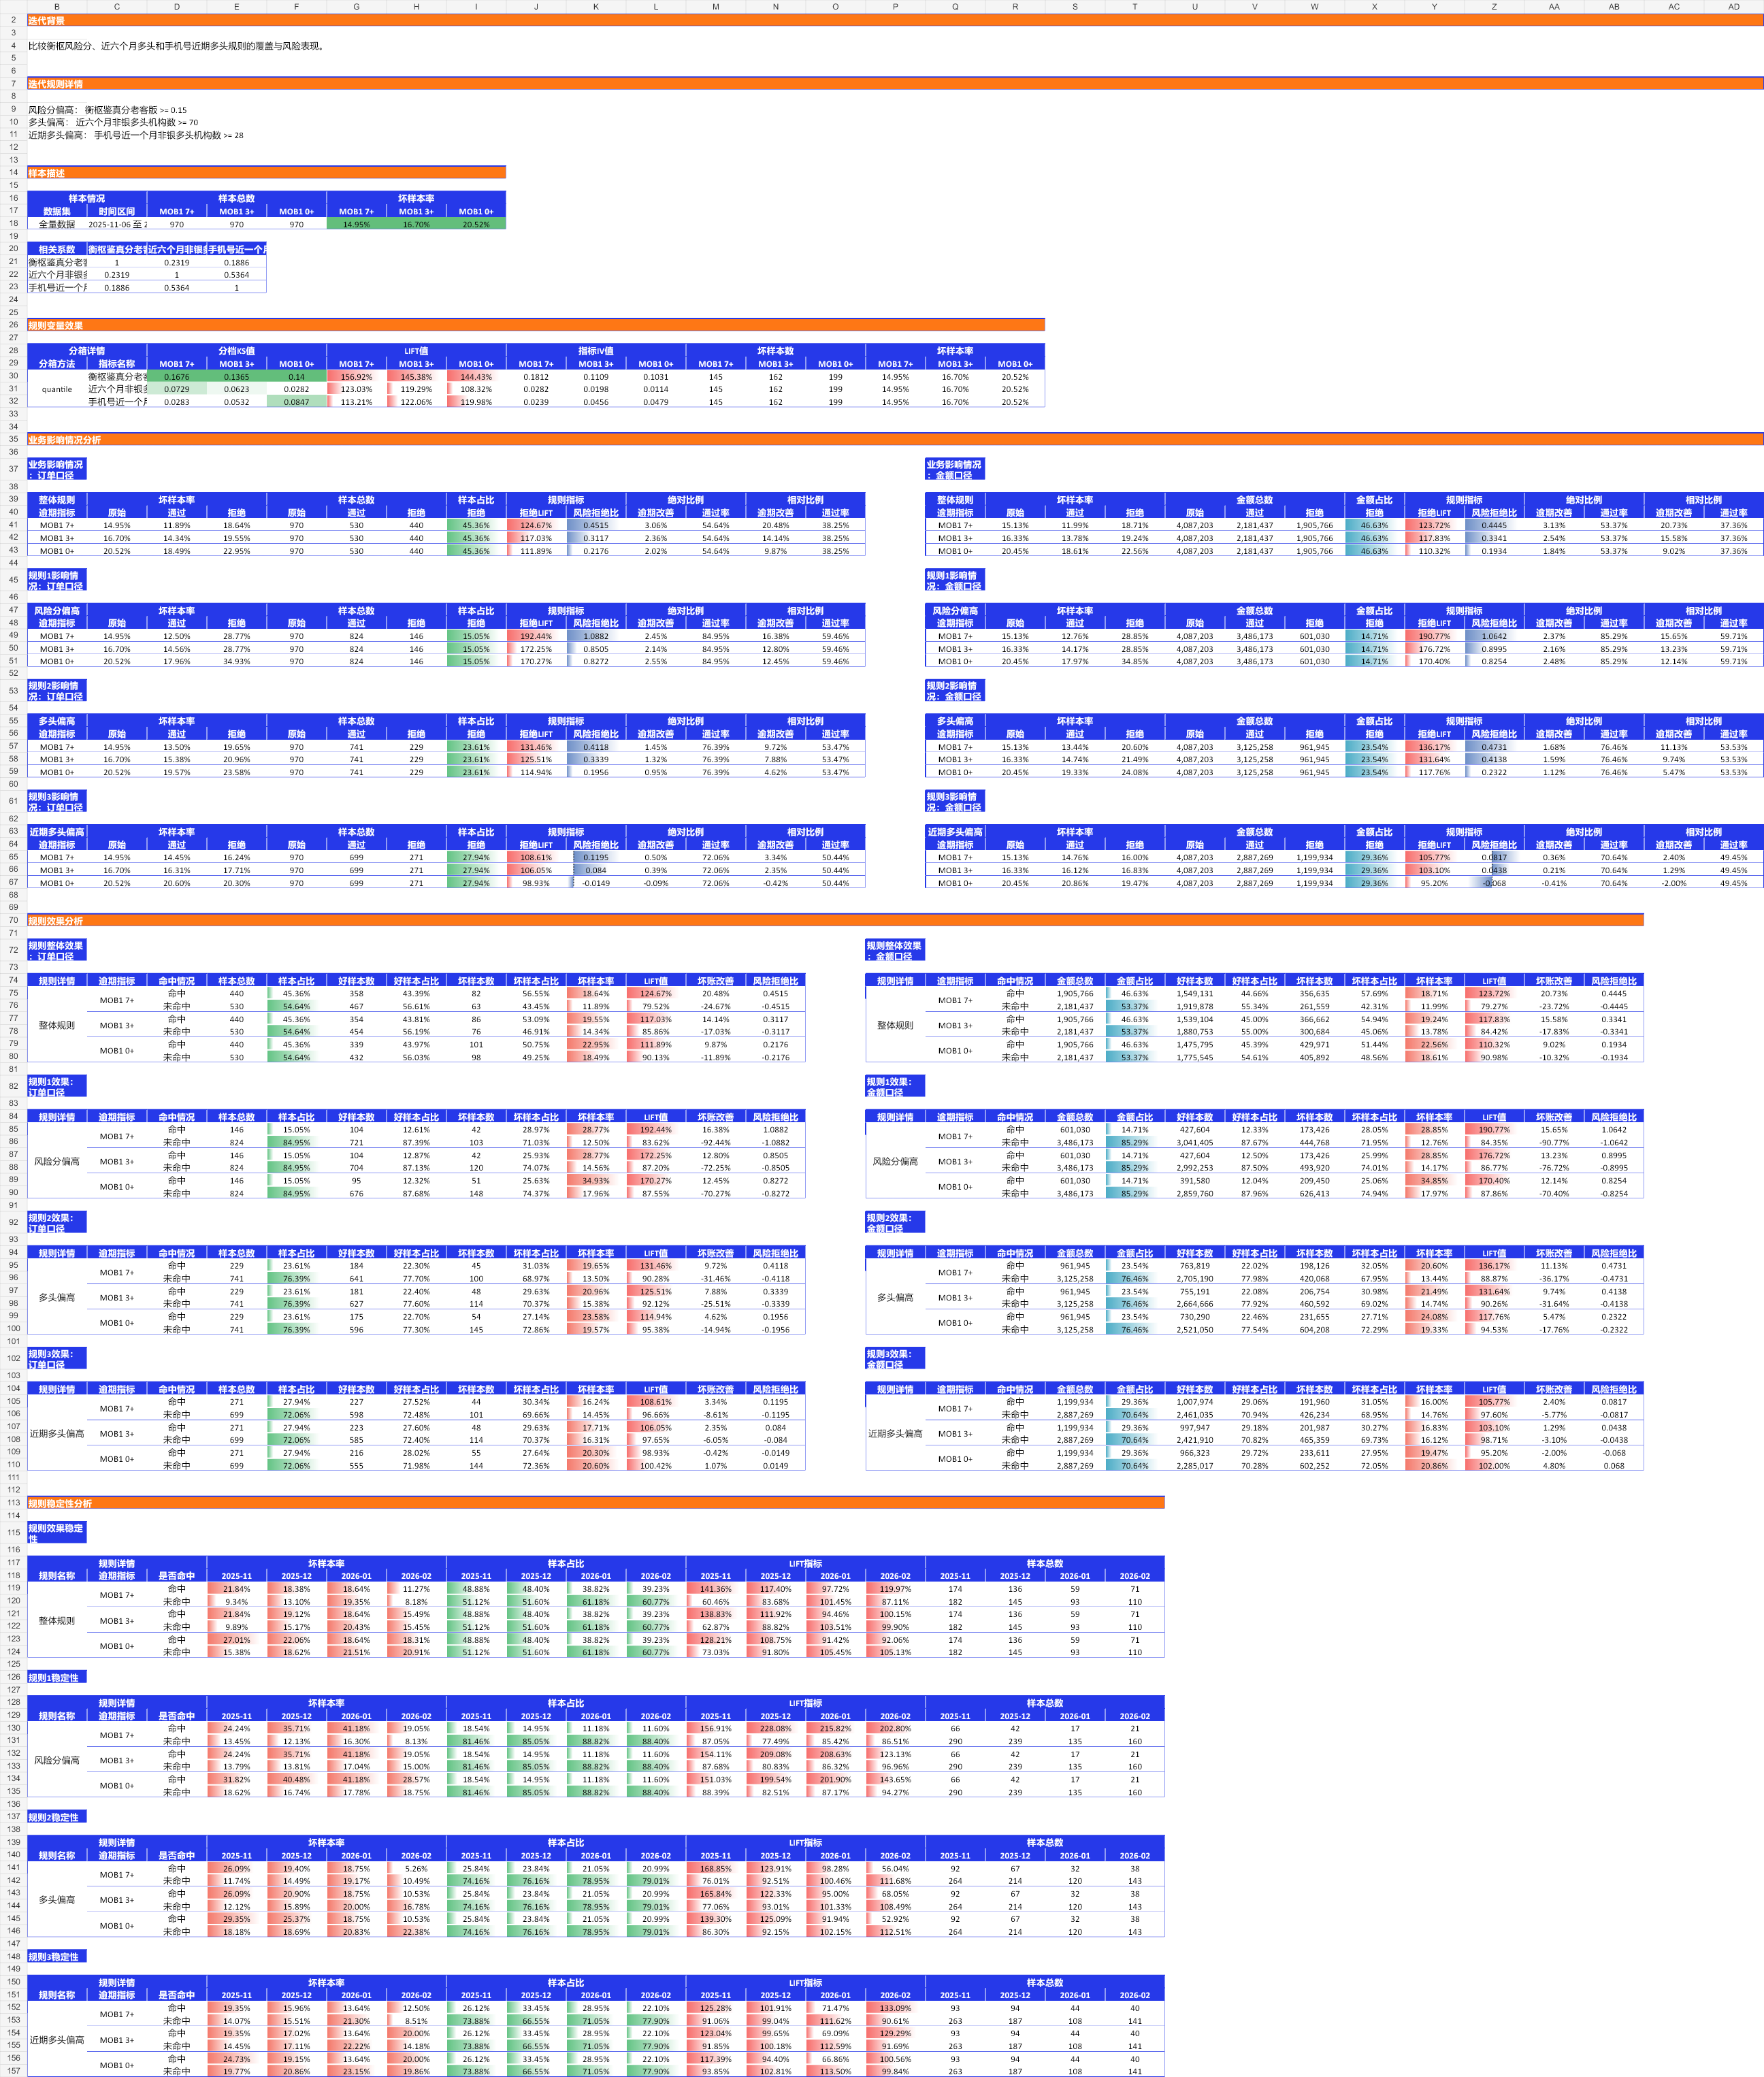
8. 手工树规则挖掘
自动训练决策树,再手工指定分裂
先在训练集自动拟合深度为 2 的树,并在验证集按 MOB1 的 7 / 3 / 0 天逾期阈值评估所有节点。下图由 plot_tree_matplotlib 直接保存,使用原生尺寸、配色和指标布局。
from hscredit.report.mining import ManualTreeExtractor
from hscredit.core.viz import plot_tree_matplotlib

manual_tree = ManualTreeExtractor(
    target="FPD", features=features,
    max_depth=2, min_samples_leaf=40, random_state=42, n_jobs=1,
)
manual_tree.fit(train_df)
automatic_figure = plot_tree_matplotlib(
    manual_tree, save=str(strategy_dir / "manual-tree-auto.png"),
)
display(automatic_figure)
automatic_rules = manual_tree.get_rule_table(
    test_df, overdue=["MOB1"], dpds=[7, 3, 0], amount="放款金额",
)
display(automatic_rules)
automatic_rules.save(
    strategy_dir / "自动决策树完整规则.xlsx", auto_width=True,
    percent_cols=["样本占比", "好样本占比", "坏样本占比", "坏样本率",
                  "坏账改善", "准确率", "精确率", "召回率", "F1分数"],
    condition_cols=["LIFT值"],
)
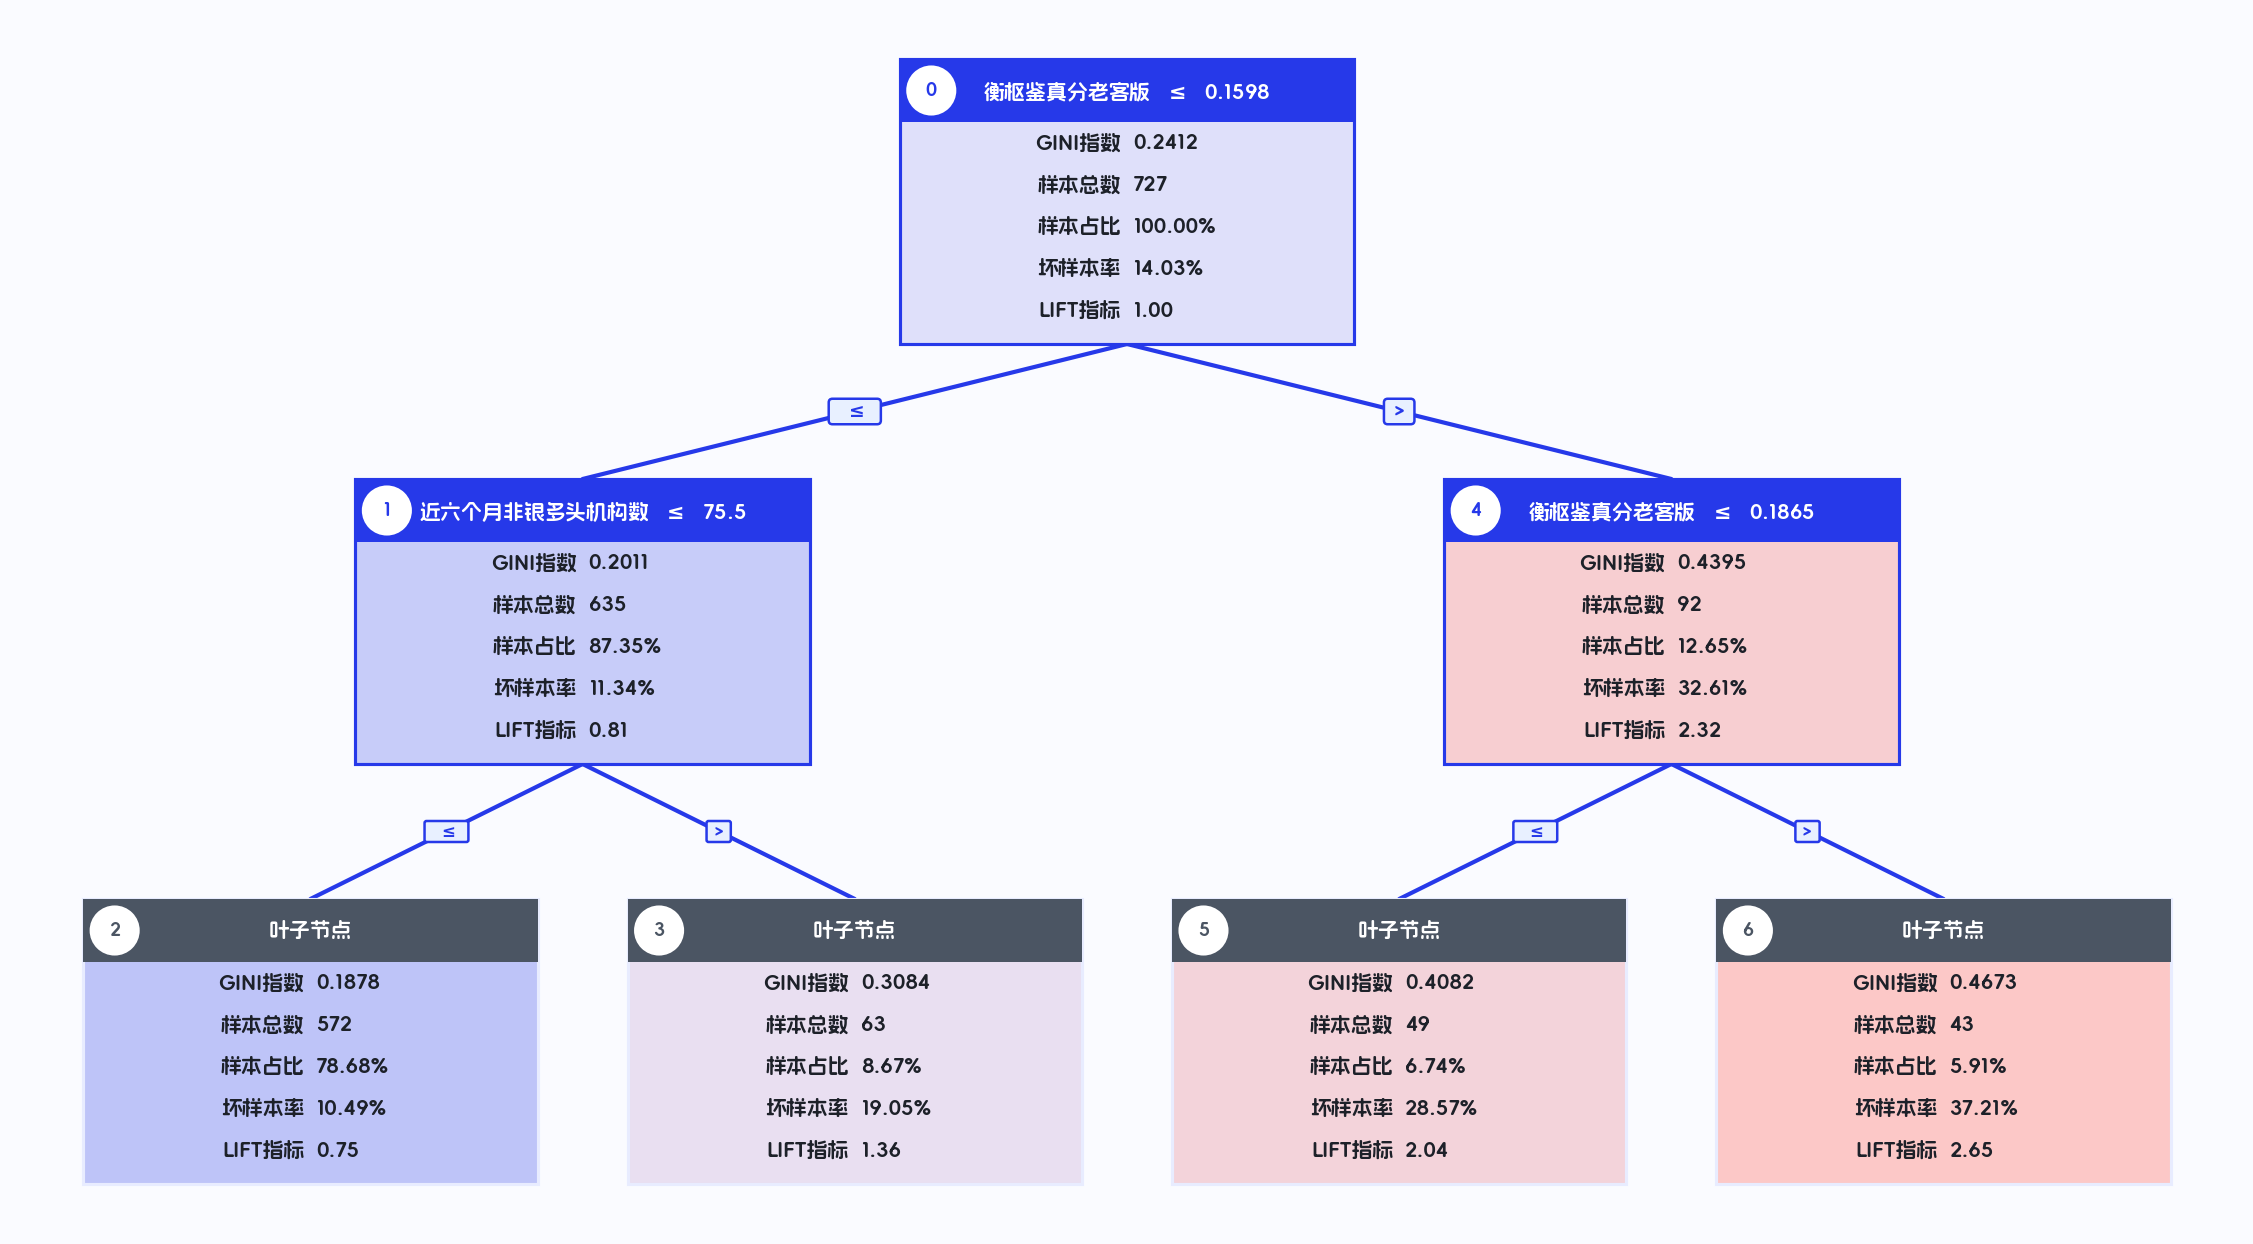
自动训练后的完整节点规则(6 行 × 44 列,完整返回)
再把根节点改为 衡枢鉴真分老客版 <= 0.10,把左节点改为 近六个月非银多头机构数 <= 55。manual_split() 修改可执行树结构,并重新生成规则效果表与原生树图;表格继续使用相同验证集和金额口径,保留方法返回的全部节点行。当前版本对人工创建节点的 GINI 使用 1.0000 占位,下面保留原图;判断节点风险时应读取原生坏样本率和规则评估表,不能把该占位值理解为重算的 GINI。
manual_tree.manual_split(train_df, feature="衡枢鉴真分老客版", threshold=0.10, node=0)
manual_tree.manual_split(
    train_df, feature="近六个月非银多头机构数", threshold=55, node=1,
)
manual_figure = plot_tree_matplotlib(
    manual_tree, save=str(strategy_dir / "manual-tree-intervention.png"),
)
display(manual_figure)
manual_rules = manual_tree.get_rule_table(
    test_df, overdue=["MOB1"], dpds=[7, 3, 0], amount="放款金额",
)
display(manual_rules)
manual_rules.save(
    strategy_dir / "手工决策树完整规则.xlsx", auto_width=True,
    percent_cols=["样本占比", "好样本占比", "坏样本占比", "坏样本率",
                  "坏账改善", "准确率", "精确率", "召回率", "F1分数"],
    condition_cols=["LIFT值"],
)
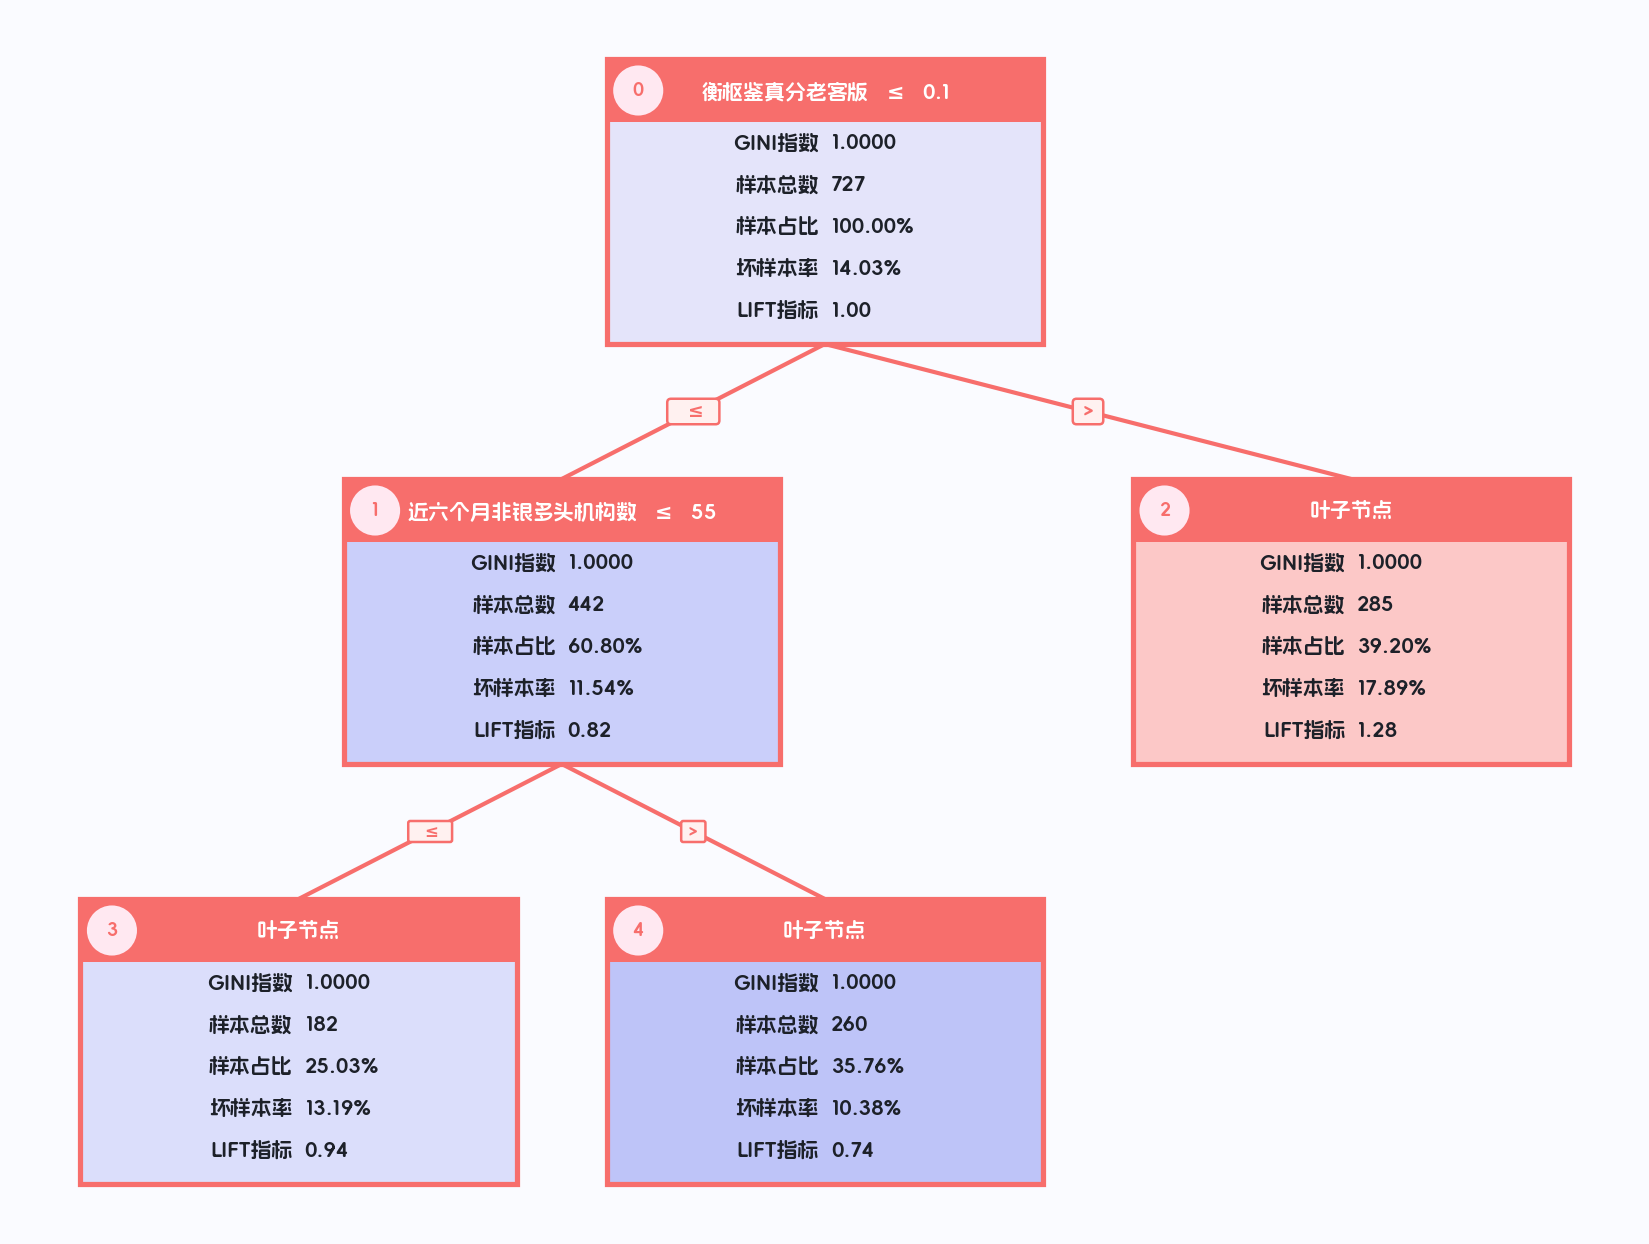
人工分裂后的完整节点规则(4 行 × 44 列,完整返回)
9. 集成模型、损失、评估与自动报告
集成模型:自定义训练损失与完整评估
objective=loss 指定训练损失;loss.metric() 提供同口径评估,loss.business_metric() 提供对应业务指标。FocalLoss 的业务入口仍返回聚焦损失本身;它们不会自动变成 AUC 或利润。
from hscredit import LightGBM
from hscredit.core.models.losses import FocalLoss

loss = FocalLoss(alpha=0.75, gamma=2.0)
model = LightGBM(
    objective=loss,
    n_estimators=60,
    num_leaves=7,
    learning_rate=0.05,
    validation_fraction=0.0,
    n_jobs=1,
    random_state=42,
    verbosity=-1,
).fit(X_train, y_train)
model.evaluate(X_test, y_test)
{'AUC': 0.5656487475372924, 'KS': 0.16014635519279483, 'Gini': 0.13129749507458488, 'LIFT@1%': 0.0, 'LIFT@3%': 0.8933823529411765, 'LIFT@5%': 1.0995475113122173, 'LIFT@10%': 1.7152941176470586}
loss.metric().evaluate(y_test, model.predict_proba(X_test))
0.051850166590956315
XGBoost 与 CatBoost:同一个损失对象的框架适配
HSCredit 包装器将损失转换为各框架的目标回调;CatBoost 的自定义评估指标在这里显式指定。以下两个配置均实际训练并完成默认全指标评估。
from hscredit import XGBoost, CatBoost
from hscredit.core.models.losses import WeightedBCELoss

weighted_loss = WeightedBCELoss(pos_weight=3, neg_weight=1)
xgb = XGBoost(
    objective=weighted_loss,
    n_estimators=40, max_depth=3, scale_pos_weight=1,
    validation_fraction=0.0, n_jobs=1, random_state=42,
).fit(X_train, y_train)
xgb.evaluate(X_test, y_test)
{'AUC': 0.5879538418238108, 'KS': 0.20025330706445255, 'Gini': 0.17590768364762166, 'LIFT@1%': 2.3823529411764706, 'LIFT@3%': 0.8933823529411765, 'LIFT@5%': 1.0995475113122173, 'LIFT@10%': 1.7152941176470586}
cat = CatBoost(
    objective=weighted_loss,
    eval_metric=weighted_loss.metric(),
    iterations=40, depth=3, validation_fraction=0.0,
    n_jobs=1, random_state=42, allow_writing_files=False,
).fit(X_train, y_train)
cat.evaluate(X_test, y_test)
{'AUC': 0.6179285111173656, 'KS': 0.27723050942865185, 'Gini': 0.23585702223473115, 'LIFT@1%': 0.0, 'LIFT@3%': 2.6801470588235294, 'LIFT@5%': 2.748868778280543, 'LIFT@10%': 2.0011764705882356}
auto_model_report:从模型直接交付 Excel
from hscredit.report import auto_model_report

model_report = auto_model_report(
    model,
    X_train=X_train, y_train=y_train,
    X_test=X_test, y_test=y_test,
    excel_path=str(model_assets / "ensemble-model-report.xlsx"),
    n_jobs=1,
    verbose=False,
)
model_report.get_metrics()
| 统计项 | 训练集 | 测试集 | |
|---|---|---|---|
| 0 | KS | 0.5461 | 0.1601 |
| 1 | AUC | 0.8290 | 0.5656 |
| 2 | 样本数 | 727 | 243.0000 |
| 3 | 坏样本率 | 0.1403 | 0.1399 |
| 4 | PSI | \ | 0.0568 |
下载原生模型报告 Excel。本示例生成目录、基本信息、模型性能、入模变量分析、稳定性分析、模型参数与模型部署需求 7 张工作表,图表由报告 API 自动生成。
10. 超参数搜索与训练过程
直接从模型发起调参
.tune() 返回已重训的最佳模型,best.tuner 保留搜索器和试验过程。loss 控制训练目标,metric 控制搜索评价;也可以直接使用下面的 ModelTuner 管理搜索。
quick_model = LightGBM(
    n_estimators=30, num_leaves=7, n_jobs=1, random_state=42,
    validation_fraction=0.0, verbosity=-1,
)
best = quick_model.tune(
    X_train, y_train,
    search_space={"max_depth": [2, 3], "learning_rate": [0.03, 0.05]},
    loss=FocalLoss(alpha=0.75), metric="auc",
    cv=3, n_trials=4, n_jobs=1, show_progress_bar=False,
)
display(best.tuner.best_params_)
ModelTuner 统一使用 Optuna。sklearn 列表、skopt、Hyperopt 和 Bayesian Optimization 风格是搜索空间声明的兼容形式;sampler 才决定 Optuna 的采样算法。列表不会自动穷举全部参数组合。
六种空间声明写法,都运行相同的 Optuna 搜索流程
from hscredit import ModelTuner
from hscredit.core.models.tuning import (
    Integer, Real, Categorical, IntDistribution, FloatDistribution,
    choice, uniform, suggest_int, suggest_categorical,
)

spaces = {
    "sklearn 列表": {
        "max_depth": [2, 3, 4], "learning_rate": [0.03, 0.05, 0.08],
    },
    "skopt 风格": {
        "max_depth": Integer(2, 4), "learning_rate": Real(0.03, 0.08),
    },
    "Hyperopt 风格": {
        "max_depth": choice("max_depth", [2, 3, 4]),
        "learning_rate": uniform("learning_rate", 0.03, 0.08),
    },
    "Bayesian Optimization 边界": {
        "max_depth": (2, 4), "learning_rate": (0.03, 0.08),
    },
    "Optuna suggest 风格": {
        "max_depth": suggest_int("max_depth", 2, 4),
        "learning_rate": suggest_categorical("learning_rate", [0.03, 0.05, 0.08]),
    },
    "Optuna 分布对象": {
        "max_depth": IntDistribution(2, 4),
        "learning_rate": FloatDistribution(0.03, 0.08),
    },
}

for space in spaces.values():
    search = ModelTuner(
        LightGBM, search_space=space,
        fixed_params={
            "n_estimators": 30, "num_leaves": 7,
            "validation_fraction": 0.0, "verbosity": -1,
        },
        metric="auc", cv=3, n_jobs=1, random_state=42,
        early_stopping_rounds=None, retention="summary",
    )
    best_params = search.fit(
        X_train, y_train, n_trials=2, show_progress_bar=False, catch=()
    )
上述声明对象直接从 hscredit 导入;不需要另外安装 skopt、Hyperopt 或 Bayesian Optimization 来构造这些声明。fit() 返回完整最佳参数字典,随后调用 get_best_model() 得到重训模型。
六种声明的完整 fit() 返回值
sklearn 列表
{'max_depth': 3, 'learning_rate': 0.03, 'n_estimators': 30, 'num_leaves': 7, 'validation_fraction': 0.0, 'verbosity': -1}
scikit-optimize 风格
{'max_depth': 3, 'learning_rate': 0.0775357153204958, 'n_estimators': 30, 'num_leaves': 7, 'validation_fraction': 0.0, 'verbosity': -1}
Hyperopt 风格
{'max_depth': 3, 'learning_rate': 0.05993292420985183, 'n_estimators': 30, 'num_leaves': 7, 'validation_fraction': 0.0, 'verbosity': -1}
Bayesian Optimization 边界
{'max_depth': 3, 'learning_rate': 0.0775357153204958, 'n_estimators': 30, 'num_leaves': 7, 'validation_fraction': 0.0, 'verbosity': -1}
Optuna suggest 风格
{'max_depth': 3, 'learning_rate': 0.03, 'n_estimators': 30, 'num_leaves': 7, 'validation_fraction': 0.0, 'verbosity': -1}
Optuna 分布对象
{'max_depth': 3, 'learning_rate': 0.0775357153204958, 'n_estimators': 30, 'num_leaves': 7, 'validation_fraction': 0.0, 'verbosity': -1}
多目标搜索与 Pareto 点的模型表现
这里同时最大化 AUC、最小化均方概率误差。只在训练集内部进行 3 折 CV;独立测试集不参与参数搜索。
from sklearn.metrics import brier_score_loss
from hscredit.core.models.losses import AUCMetric, make_metric

brier = make_metric(
    brier_score_loss, name="均方概率误差", greater_is_better=False
)
tuner = ModelTuner(
    LightGBM,
    search_space={
        "max_depth": Integer(2, 4),
        "learning_rate": Real(0.02, 0.15, prior="log-uniform"),
        "reg_lambda": Categorical([0.0, 1.0, 3.0]),
    },
    fixed_params={
        "n_estimators": 30, "num_leaves": 7,
        "validation_fraction": 0.0, "verbosity": -1,
    },
    metric=[AUCMetric(), brier],
    cv=3, n_jobs=1, random_state=42,
    early_stopping_rounds=None, retention="summary",
)
tuner.fit(X_train, y_train, n_trials=12, show_progress_bar=False, catch=())
pareto_figure = tuner.plot_pareto_front()
pareto_figure.write_html(str(model_assets / "pareto-front.html"))
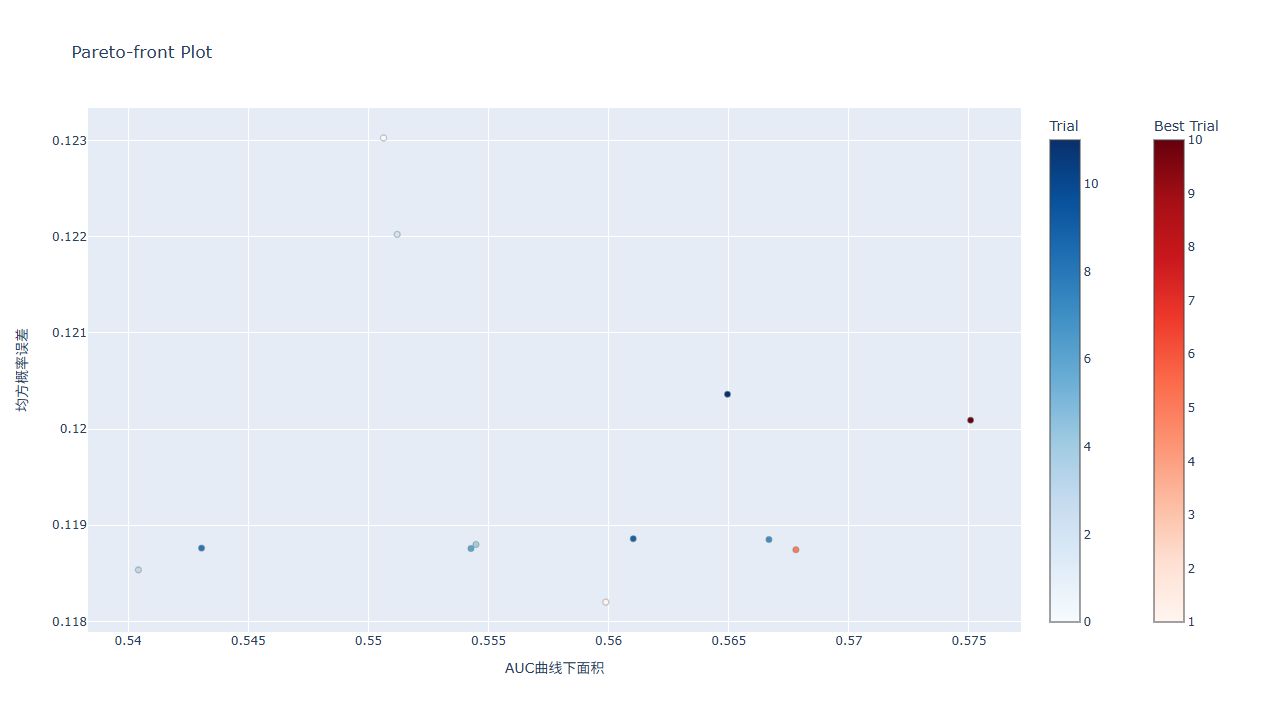
下载原生 Pareto 交互 HTML,用浏览器打开后悬停在点上,可查看试验编号、参数与 CV 指标。该原生图不会在点击时自动重训模型。按点中的编号继续复盘:
tuner.evaluate_study_trials([0, 1])
| trial索引 | trial状态 | max_depth | learning_rate | reg_lambda | AUC曲线下面积 | 均方概率误差 | study记录值 | |
|---|---|---|---|---|---|---|---|---|
| 0 | 0 | COMPLETE | 3 | 0.1358 | 0.0000 | 0.5506 | 0.1230 | [0.5506338991246112, 0.12302751710027503] |
| 1 | 1 | COMPLETE | 2 | 0.0225 | 0.0000 | 0.5599 | 0.1182 | [0.5598866432844761, 0.11820021482946517] |
这张表是方法的完整原始返回;它会重新运行对应参数的 CV,study记录值 保留原试验得分用于核对。tuner.get_trial_result(0) 可直接查看各折指标、训练记录和保留状态;tuner.get_best_model().evaluate(X_test, y_test) 则评估默认选中的最终模型。
Optuna Dashboard:查看真实 Study 与折级进度
执行下列脚本会创建 SQLite Study,其中有 12 次多目标试验,以及 10 次单目标搜索记录。Dashboard 展示真实的试验状态、参数、CV 目标值与折级中间值;剪枝试验保留其停止状态。
python scripts/readme_examples/models.py --section tuning
python scripts/readme_examples/models.py --dashboard --port 8091
在浏览器打开 http://127.0.0.1:8091/,选择 README-训练过程-* 或 README-多目标模型-*。对应数据库位于 .audit_tmp/readme-complete/models/optuna-multiloan-study.sqlite3;每次运行使用新的 Study 名称。SQLite 保存搜索记录,Python 模型制品另外保存。
查看 Optuna Dashboard 完整训练过程页面
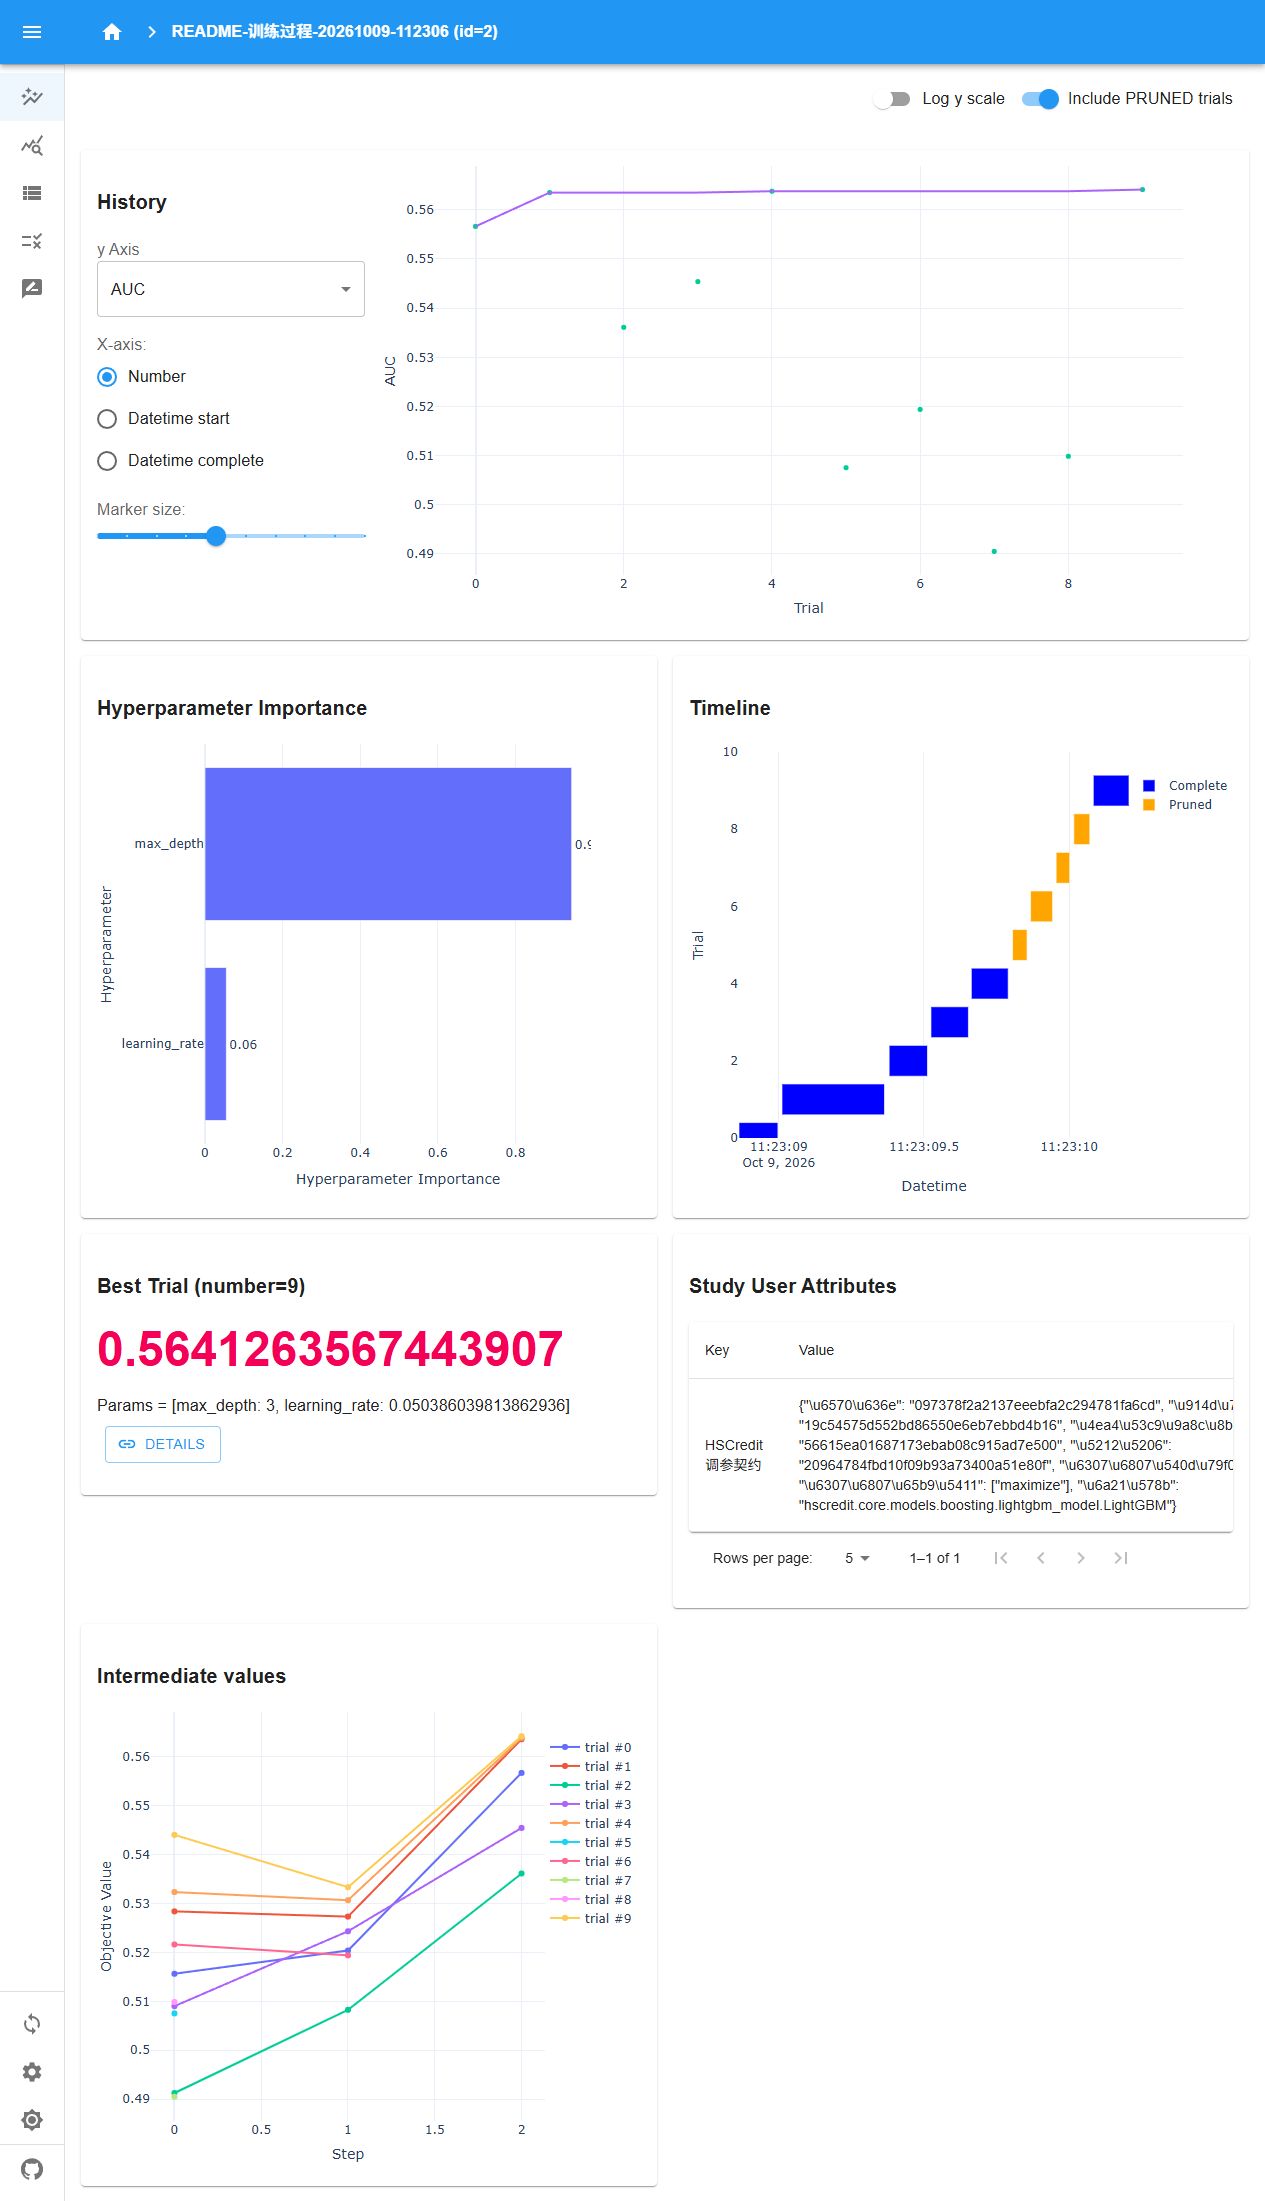
下载原生优化历史交互 HTML。空间、指标、训练损失、保存与续跑的完整用法见调参指南与损失指南。
11. 模型可解释性
plot_model_feature_importance 在一张原生图中展示模型重要性、SHAP 分布和特征依赖;plot_model_sample_shap 将同一个样本的力图与瀑布图组合展示。以下图均解释 predict_proba 的坏样本概率,没有裁剪字段或调整画布、样式与分辨率。
from hscredit.core.viz import plot_model_feature_importance, plot_model_sample_shap

figure = plot_model_feature_importance(
    model, X_test, y_test,
    save=str(model_assets / "model-feature-importance.png"),
    show=False,
)
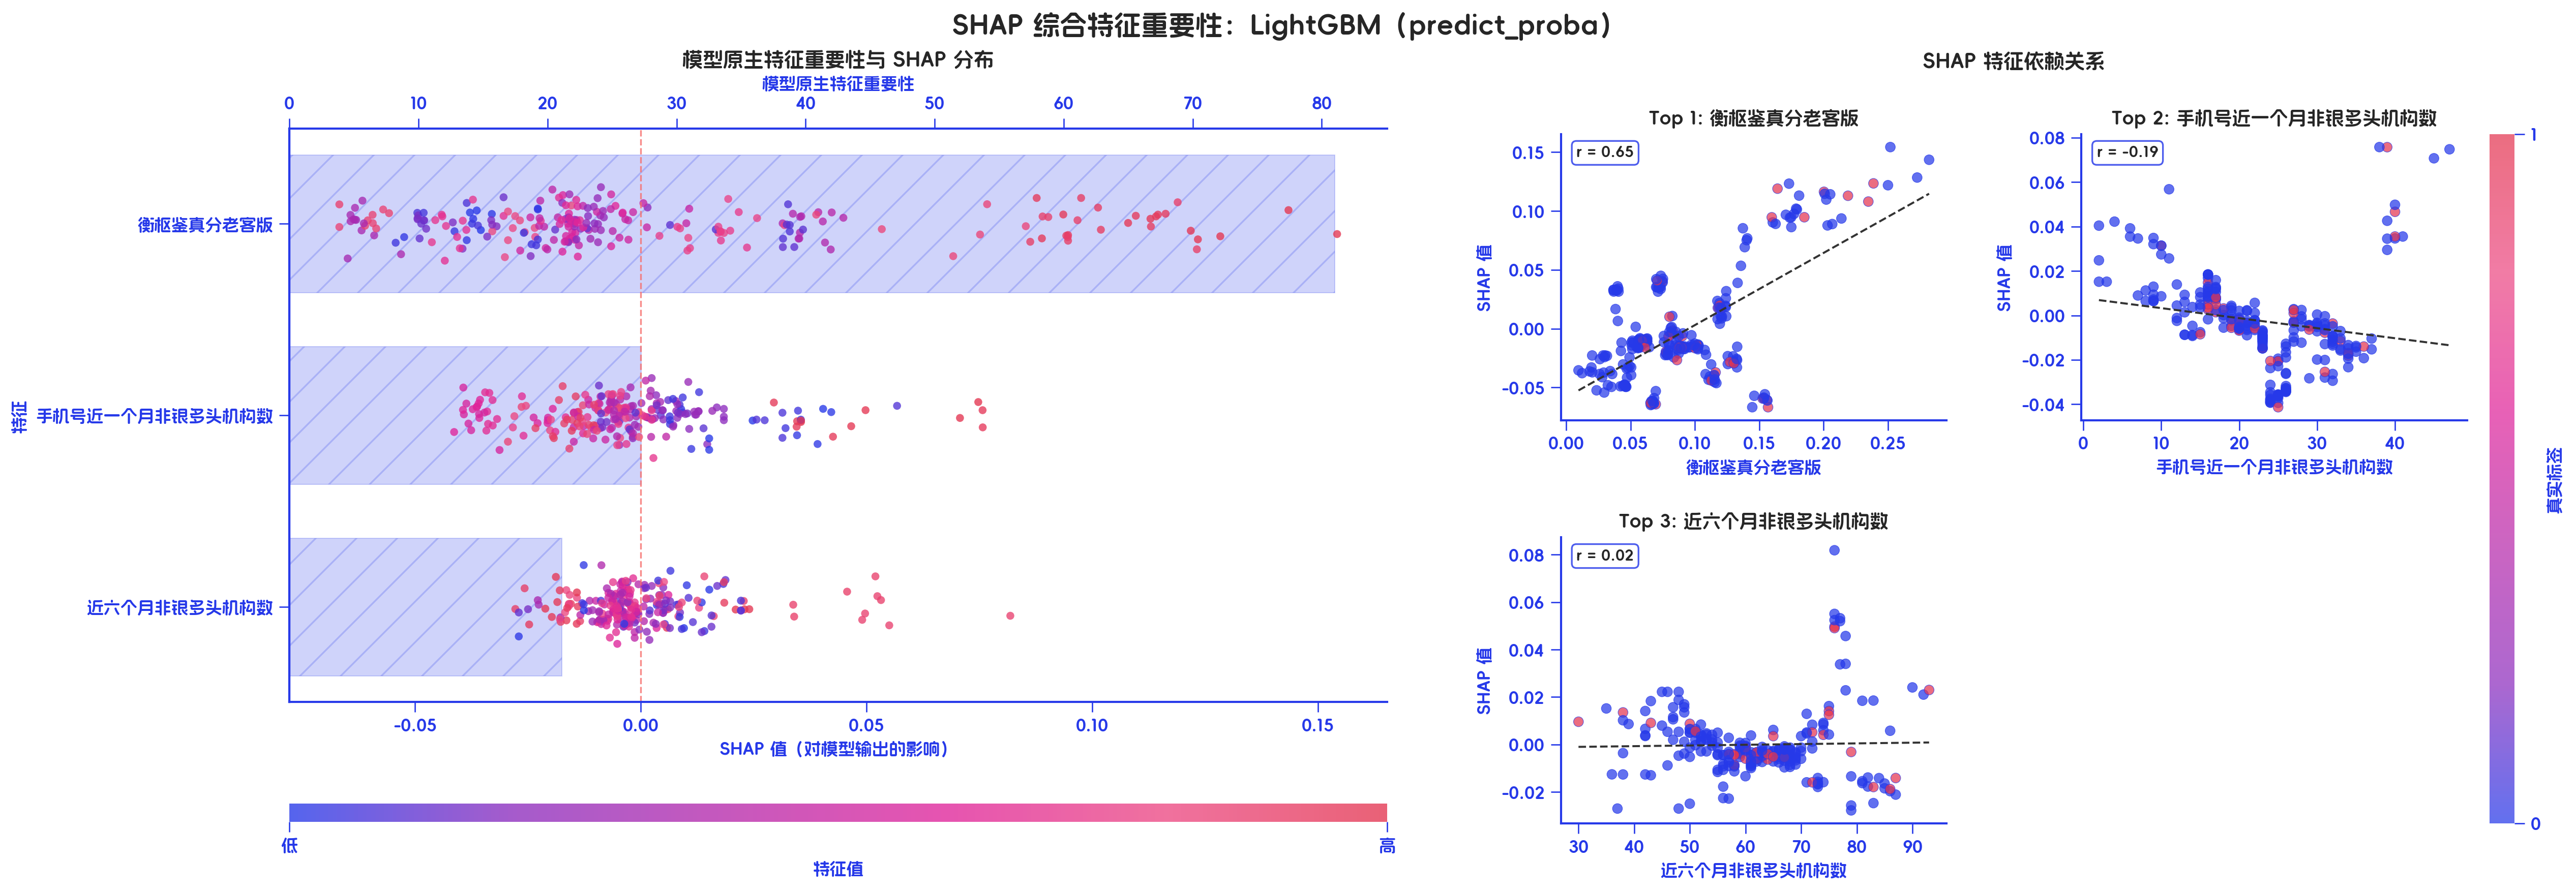
figure = plot_model_sample_shap(
    model,
    sample=X_test.iloc[0],
    background_data=X_train,
    save=str(model_assets / "model-sample-shap.png"),
    show=False,
)
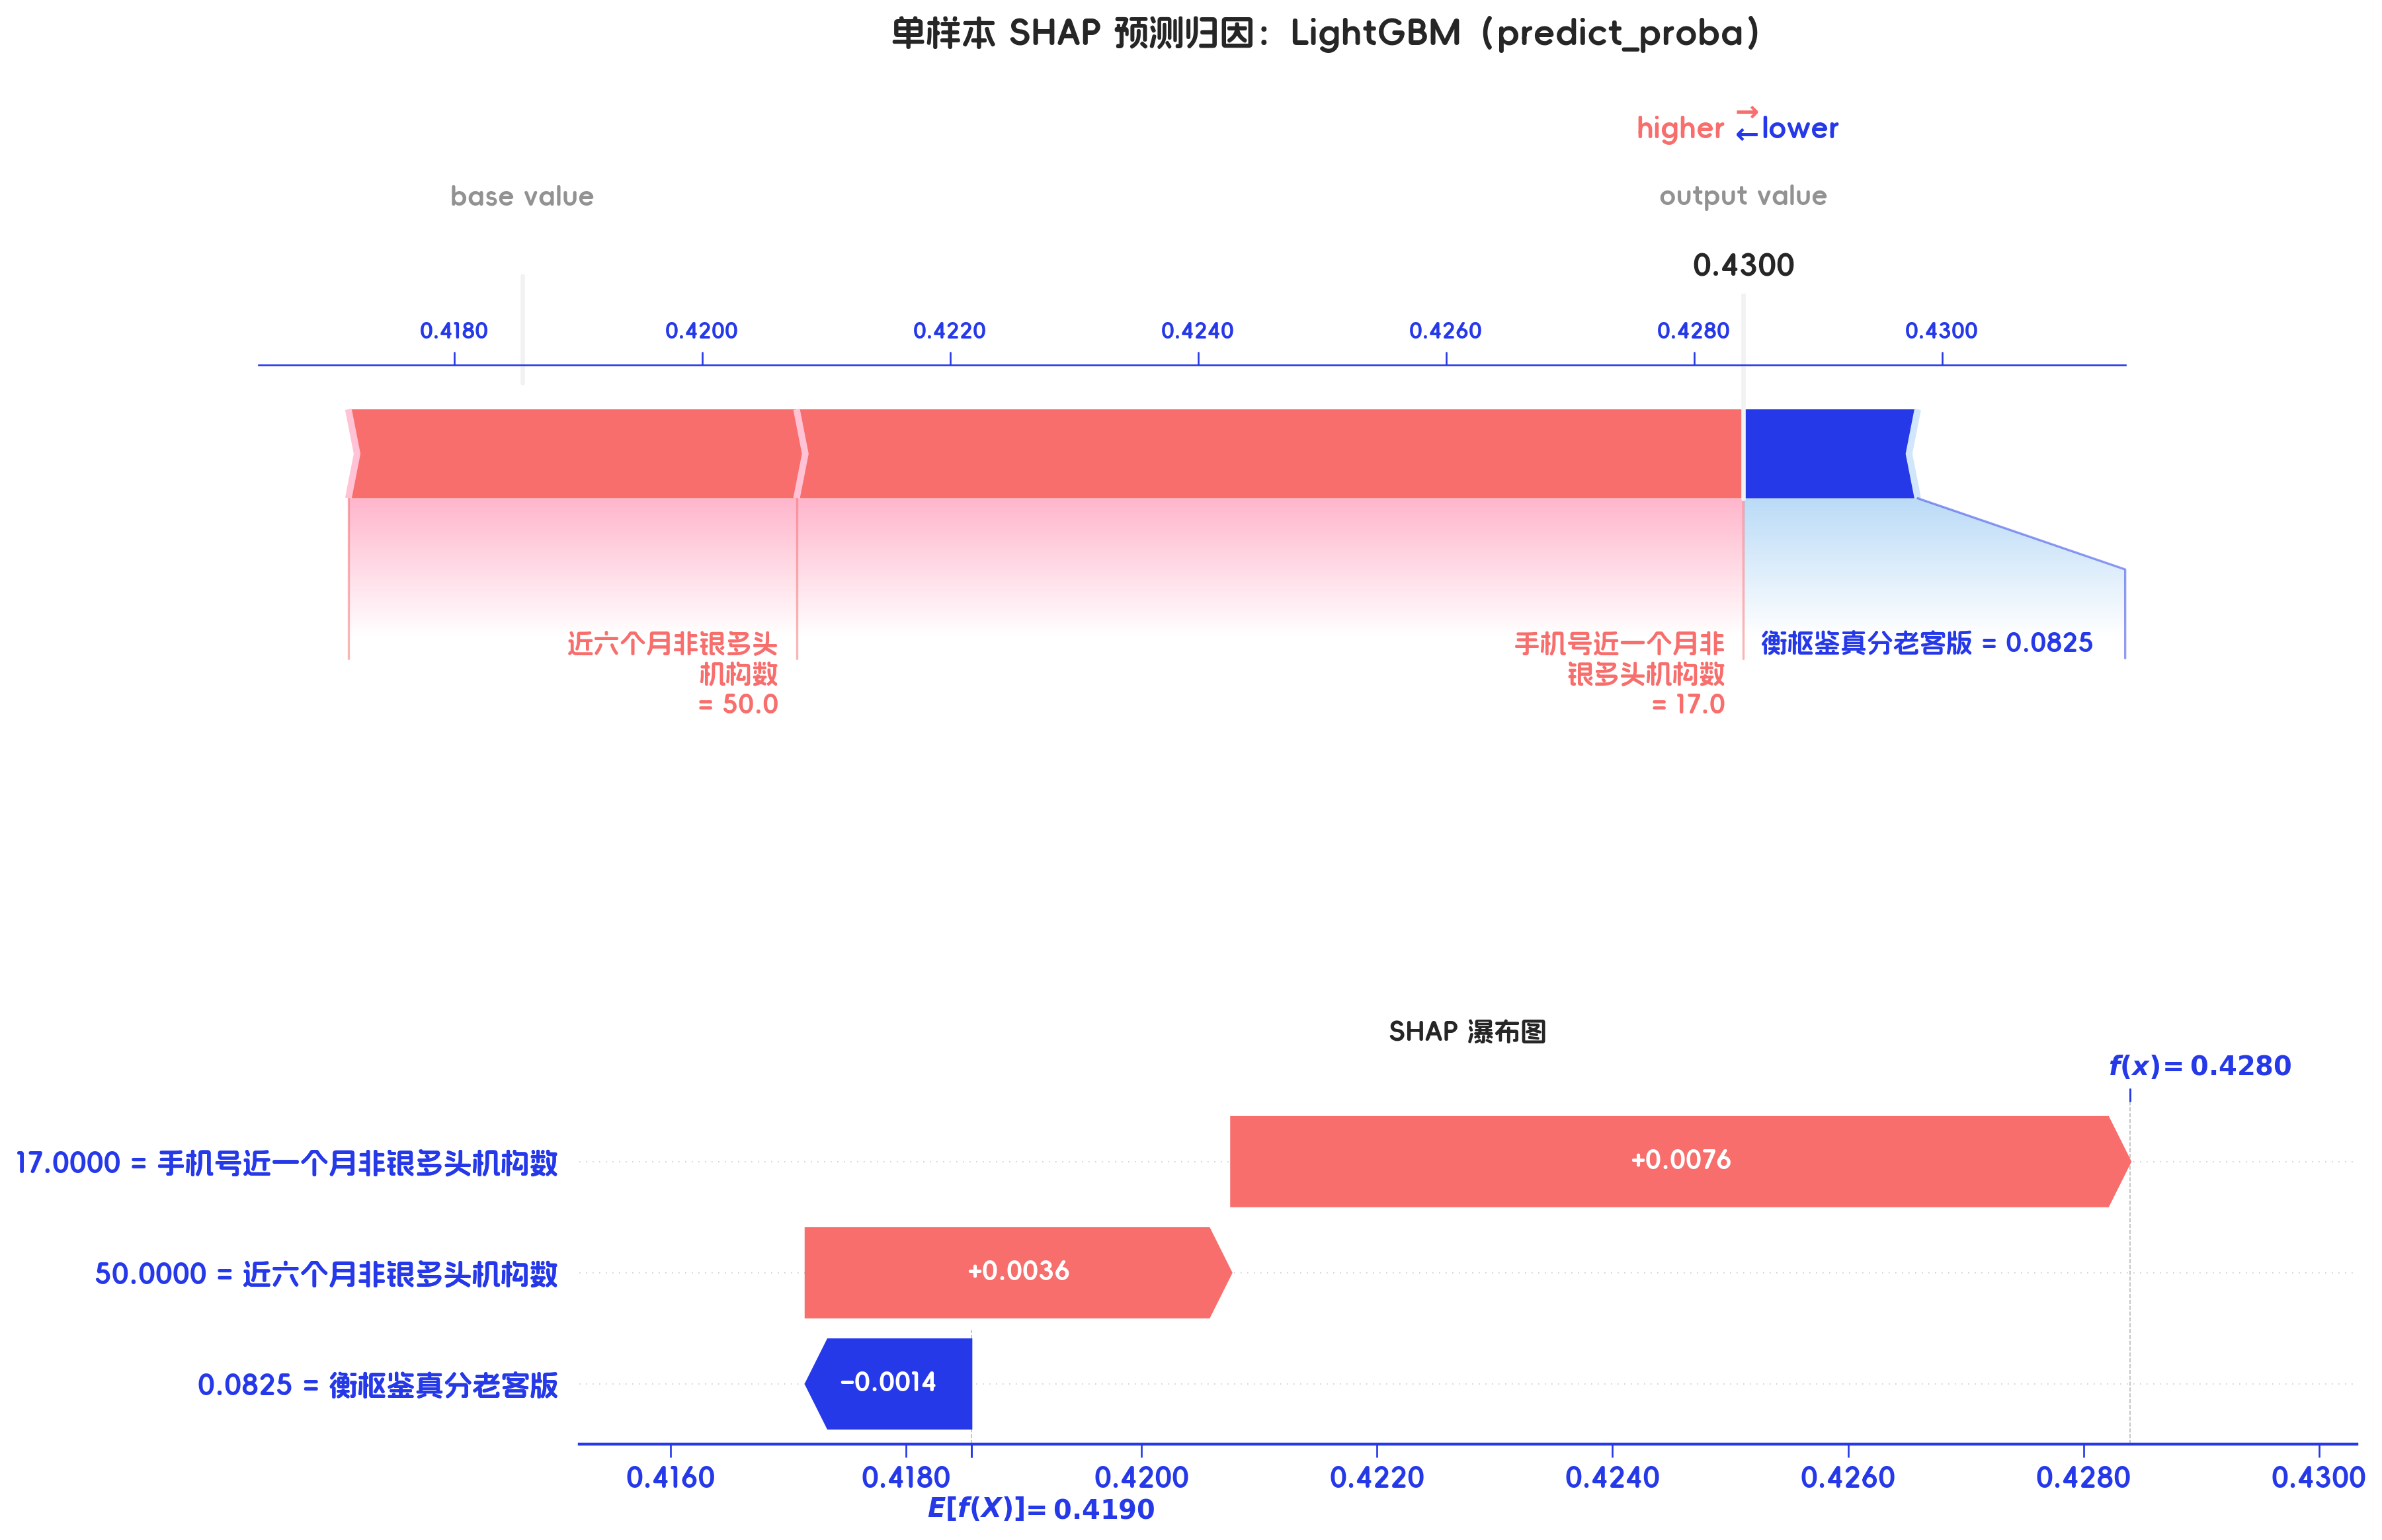
全部模型示例和原生输出可通过 scripts/readme_examples/models.py 复现。
12. Excel 功能
dataframe2excel 和 DataFrame.save 都可保留整张返回表,并在导出时设置自动列宽、百分比和条件格式。percent_cols、condition_cols 只指定格式应用位置,不会筛掉其他列;多级表头使用完整列标签元组。
dataframe2excel、百分比与条件格式
from hscredit.core.binning import OptimalBinning
from hscredit.excel import ExcelWriter, dataframe2excel

excel_dir = Path("docs/assets/readme/excel")
excel_dir.mkdir(parents=True, exist_ok=True)
excel_binner = OptimalBinning(method="quantile", max_n_bins=4, n_jobs=1)
excel_binner.fit(df[features], df["FPD"])
excel_table = excel_binner.get_bin_table("衡枢鉴真分老客版")
percent_cols = [
    "样本占比", "好样本占比", "坏样本占比", "坏样本率",
    "坏账改善", "累积坏账改善", "分档KS值",
]
condition_cols = ["样本总数", "分档IV值", "LIFT值"]

writer = ExcelWriter()
dataframe2excel(
    excel_table, writer,
    sheet_name="分箱统计", title="dataframe2excel 完整分箱表",
    start_row=4, index=True, auto_width=True,
    percent_cols=percent_cols, condition_cols=condition_cols,
)
冻结窗格与超链接
sheet = writer.get_sheet_by_name("分箱统计")
writer.set_freeze_panes(sheet, "D7")
writer.insert_value2sheet(sheet, "B2", value="查看数据透视表")
writer.insert_hyperlink2sheet(
    sheet, "B2", sheet="透视分析", target_space="B2",
)
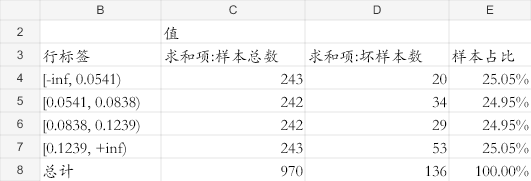
本例从第 4 行写标题,方法在标题下保留空行,第 6 行为字段名。冻结 D7 后,向下或向右滚动时保留表头、索引与分箱编号。B2 可跳到同一工作簿的透视分析页。
原生数据透视表
writer.insert_pivot_table2sheet(
    worksheet="透视分析", data=excel_table, pivot_anchor="B2",
    rows="分箱标签",
    values=[
        ("样本总数", "sum"),
        ("坏样本数", "sum"),
        {
            "field": "样本总数", "agg": "sum", "show_as": "全局占比",
            "name": "样本占比", "number_format": "0.00%",
        },
    ],
    source_sheet=sheet, source_anchor="C6", write_source=False,
    name="分箱样本透视表",
)
writer.save(str(excel_dir / "excel-features.xlsx"))
透视表直接引用已写入的完整分箱表;保存的文件包含原生 PivotTable 与缓存,Excel 打开后刷新,可调整字段、聚合方式和占比口径。下面是工作簿完整表格,以及在 Excel 中刷新后的透视表。

DataFrame.save:一行入口导出同一张完整表
excel_table.save(
    str(excel_dir / "dataframe-save.xlsx"),
    sheet_name="分箱统计", title="DataFrame.save 完整分箱表",
    index=True, auto_width=True,
    percent_cols=percent_cols, condition_cols=condition_cols,
)

下载 DataFrame.save 工作簿 · 完整 Excel 示例 · 生成代码
文档与复现
在线文档 · 全部 Notebook · 模型工作流 · 损失与指标 · 超参数搜索 · 迭代规划
本页演示可用以下脚本重新生成。脚本保留原始返回值,输出完整工作簿、原生图及 HTML;Optuna Dashboard 从真实 SQLite Study 读取训练过程。
pip install -e ".[all]"
python scripts/readme_examples/binning_eda.py
python scripts/readme_examples/strategy.py
python scripts/readme_examples/models.py
python scripts/readme_examples/excel.py
开发验证:
python scripts/validate_examples.py --pattern 00_quickstart.ipynb
pytest tests/ -m "not slow and not integration"
问题与建议请提交到 GitHub Issues。
联系与许可
邮箱:hscredit@hengshucredit.com · 微信:itlubber · 公众号:衡枢风控(回复 入群 加入技术交流群)。
微信与公众号二维码
| 微信 | 微信公众号 |
|---|---|
 |
 |
本项目采用 MIT License。
1 maintainer

Metadata
1 maintainer
Release files for hscredit 0.1.2
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| hscredit-0.1.2.tar.gz | 31.3 MB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| hscredit-0.1.2-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 36.9 MB
Release files / hscredit-0.1.2.tar.gz
| Download URL | hscredit-0.1.2.tar.gz |
|---|---|
| Size | 31.3 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
c29f686943284fd95181105fcec33129ac2724aa74cbe4e567c2babeac866071
|
|
BLAKE2b-256 checksum How to use checksums |
00d0c0dcf59962c8df9a1dede02d541e4157b8515c4d9561e96266f350fd3e12
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.11.5
|
Release files / hscredit-0.1.2-py3-none-any.whl
| Download URL | hscredit-0.1.2-py3-none-any.whl |
|---|---|
| Size | 5.6 MB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
a3cb09fda85c51f872c9cf32e406b7fa007fea183ea6144c7ba26b624bdea64d
|
|
BLAKE2b-256 checksum How to use checksums |
f5c4a46e3881cd0c2efb96deb0b1b258651998fa38a5f115ce49573b5885846c
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.11.5
|














