
hwbench


Outil en ligne de commande pour Linux qui inventorie les composants d'une machine et lance des benchmarks notés (CPU single-core, CPU multi-core, GPU et score combiné, plus mémoire et disque pour information) pour comparer des machines entre elles.
Installation
Python 3.11 ou plus récent, Linux. Avec pipx (environnement isolé,
commande hwbench dans le PATH) :
pipx install hwbench          # dernière version publiée sur PyPI
pipx upgrade hwbench
En alternative, directement depuis GitHub (sans passer par PyPI) :
pipx install git+https://github.com/Mvth1s/hwbench           # dernière version de main
pipx install git+https://github.com/Mvth1s/hwbench@v0.2.0    # une version taguée
Depuis un clone du dépôt : pipx install .. Les outils système optionnels (dmidecode, smartctl,
sysbench, glmark2, vkmark…) sont listés plus bas ; aucun n'est obligatoire.
Les versions publiées (tag, changelog, wheel et sdist) sont sur la page Releases ; l'historique est dans CHANGELOG.md.
Pour développer :
python3 -m venv .venv
.venv/bin/pip install -e '.[dev]'
.venv/bin/pytest
.venv/bin/ruff check .
Pour ajouter une machine aux fixtures de test (sorties réelles, identifiants anonymisés) :
scripts/capture_fixtures.sh [nom]     # sans sudo : il le demande lui-même pour dmidecode/smartctl
scripts/capture_tool_fixtures.sh      # sorties de sysbench, glmark2, vkmark et fio (protocole réel)
scripts/capture_tool_fixtures.sh --suffix _b850 --only memory,disk   # autre machine, sans écraser
Autocomplétion du shell
À lancer depuis le shell visé (il est détecté automatiquement) :
hwbench --install-completion # installe la complétion pour le shell courant
Ou à la main :
# fish
hwbench --show-completion > ~/.config/fish/completions/hwbench.fish

# bash
hwbench --show-completion > ~/.local/share/bash-completion/completions/hwbench
Sont complétés : les commandes, leurs options et les valeurs (hwbench bench <Tab> propose
cpu-single, cpu-multi, gpu, all). Ouvrir un nouveau shell pour en profiter.
Utilisation
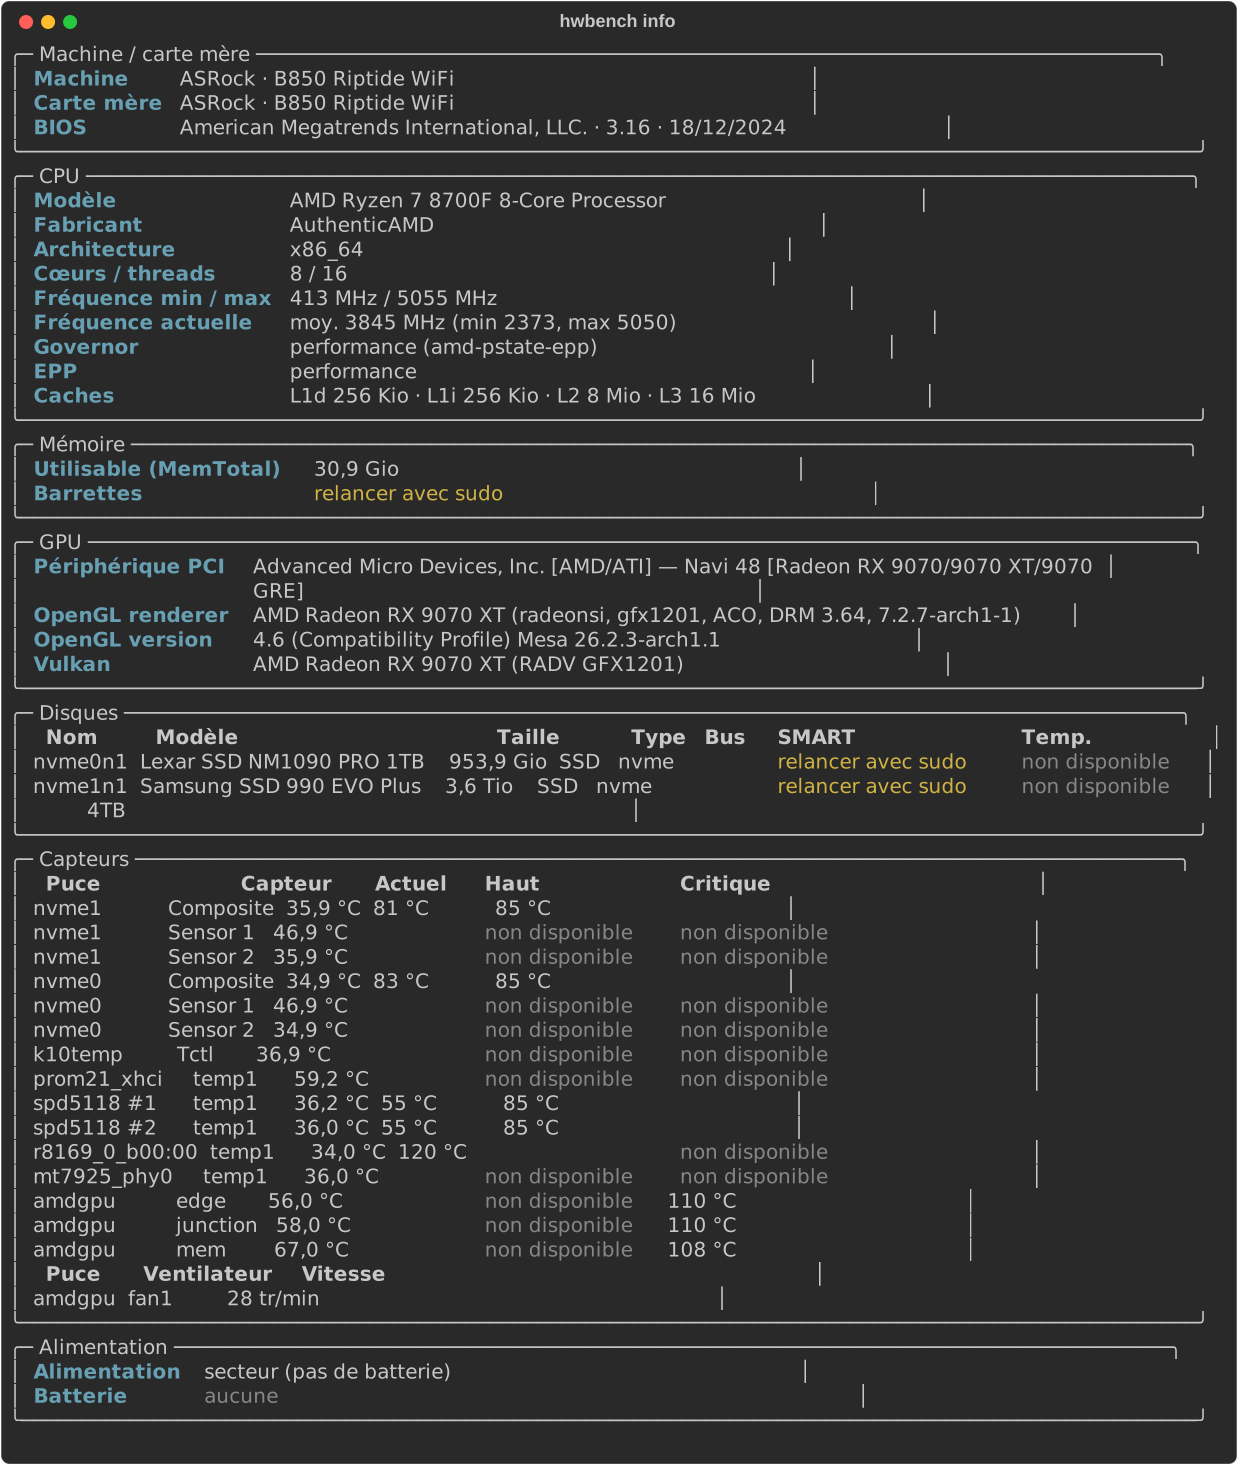
hwbench info                  # tableau récapitulatif
hwbench info --json           # sortie JSON, sans aucun identifiant
hwbench info --show-serials   # affiche serials / UUID / hostname à l'écran, localement
--json et --show-serials sont incompatibles : les identifiants ne sortent jamais de l'écran.
Avec root (barrettes RAM et santé SMART)
dmidecode et smartctl demandent root. Or sudo utilise son propre PATH (secure_path),
qui ne contient ni ~/.local/bin (pipx) ni le venv : sudo hwbench répond « command not found ».
Passe le chemin complet :
sudo "$(command -v hwbench)" info     # bash, zsh, et fish ≥ 3.4
sudo (command -v hwbench) info        # fish < 3.4
sudo .venv/bin/hwbench info           # depuis le repo, en développement
Exemple (sans root) :
╭─ CPU ────────────────────────────────────────────────────────────────────────╮
│ Modèle               11th Gen Intel(R) Core(TM) i5-1145G7 @ 2.60GHz          │
│ Cœurs / threads      4 / 8                                                   │
│ Fréquence min / max  400 MHz / 4400 MHz                                      │
│ Fréquence actuelle   moy. 1827 MHz (min 401, max 3939)                       │
│ Governor             performance                                             │
│ Caches               L1d 192 Kio · L1i 128 Kio · L2 5 Mio · L3 8 Mio         │
╰──────────────────────────────────────────────────────────────────────────────╯
╭─ Mémoire ────────────────────────────────────────────────────────────────────╮
│ Total      15.3 Gio                                                          │
│ Barrettes  relancer avec sudo                                                │
╰──────────────────────────────────────────────────────────────────────────────╯
╭─ Disques ────────────────────────────────────────────────────────────────────╮
│  Nom      Modèle                        Taille     Type  Bus   SMART         │
│  nvme0n1  Samsung SSD 990 EVO Plus 1TB  931.5 Gio  SSD   nvme  relancer avec │
│                                                                sudo          │
╰──────────────────────────────────────────────────────────────────────────────╯
Benchmarks
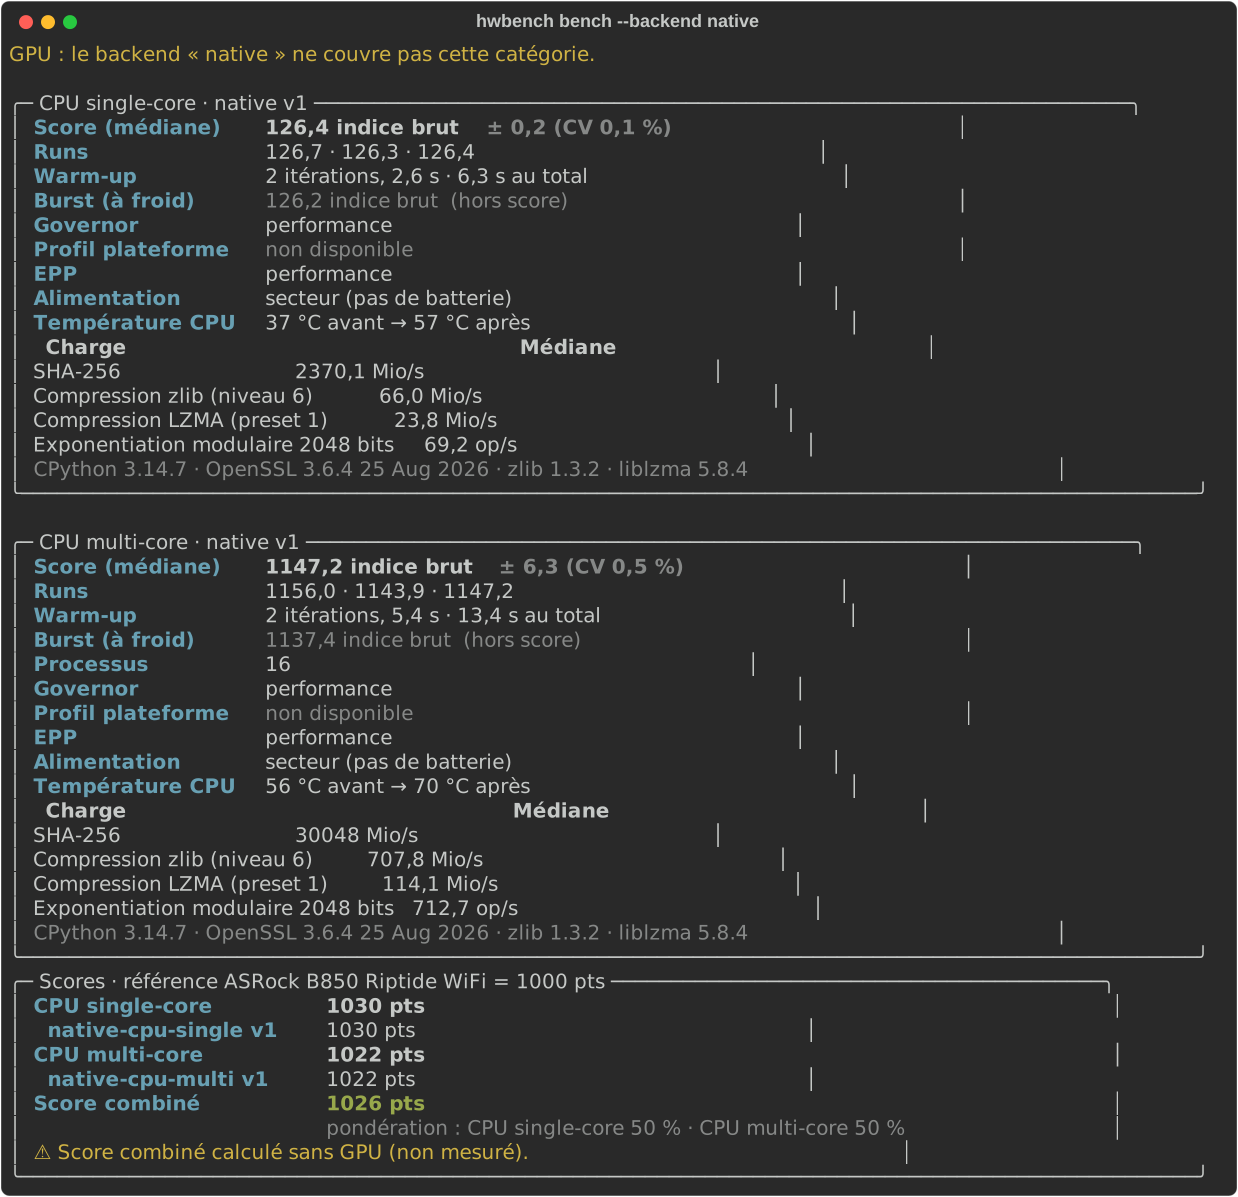
hwbench bench                          # toutes les catégories, tous les backends disponibles
hwbench bench cpu-single               # une catégorie : cpu-single, cpu-multi, gpu, memory, disk, all
hwbench bench cpu-multi --workers 4    # nombre de processus (défaut : CPU logiques)
hwbench bench --backend native --runs 5
hwbench bench cpu-multi --max-warmup 180   # plafond du warm-up en secondes
hwbench bench --max-cv 3 --hot-start 60    # seuils des avertissements (défaut : 5 %, 70 °C)
hwbench bench --weights cpu-single=1,cpu-multi=2,gpu=1   # pondération du score combiné
hwbench bench disk --disk-path /mnt/data --disk-size 4G  # dossier et taille du fichier de test
hwbench backends                       # backends disponibles et commande d'installation
Backend natif (CPU)
Quatre charges déterministes, identiques sur toutes les machines, dont le temps est passé dans du
code C (pour limiter l'effet de la version de Python) : SHA-256 (OpenSSL), compression zlib
niveau 6, compression LZMA preset 1, exponentiation modulaire 2048 bits (entiers de CPython).
Le score est la moyenne géométrique des débits des quatre charges ; le détail par charge est
affiché. Le multi-cœur lance la même charge dans N processus (multiprocessing, pas de threads
à cause du GIL) et additionne leurs débits. Les versions de Python, OpenSSL, zlib et liblzma
sont relevées avec chaque résultat.
Backend natif (mémoire)
Bande passante de copie : un gros buffer copié dans un autre via memoryview, que CPython
exécute en C (memcpy), si bien que le temps mesuré est celui de la copie. Les buffers dépassent
les caches : 128 Mio en single (256 Mio avec la destination), 32 Mio par processus en
multi-processus (N processus, débits additionnés, comme le CPU). Les pages sont touchées avant
le chrono. Le résultat compte les octets copiés, en Mio/s.
Backends externes
| Backend | Catégories | Protocole |
|---|---|---|
sysbench |
CPU single, multi | sysbench cpu, nombres premiers jusqu'à 10 000, 5 s par run ; 1 thread ou N threads |
sysbench |
mémoire | sysbench memory, lecture séquentielle d'un bloc par thread (128 Mio en single, 32 Mio par thread en multi), 5 s par run |
fio |
disque | 4 tests de 2 s en E/S directes (direct=1, libaio) : lecture et écriture séquentielles (1 Mio, QD8, en Mio/s), lecture et écriture aléatoires 4K (QD32, en IOPS) |
glmark2 |
GPU (OpenGL) | 8 scènes, 3 s chacune, 3840×2160 hors écran (--off-screen) |
vkmark |
GPU (Vulkan) | 2 scènes, 3 s chacune, 3840×2160, plugin headless (aucun affichage) |
Chaque résultat relève la version de l'outil ; pour le GPU aussi le binaire, la session, la
résolution, le mode de présentation et le pilote (ex. Mesa 26.2.3, RADV 26.2.3).
Vsync. glmark2 rend dans un framebuffer hors écran, jamais présenté : la vsync ne peut pas
s'appliquer (--swap-mode immediate n'est honoré que par la variante DRM, il n'est pas utilisé).
vkmark utilise son plugin headless s'il est installé ; sinon il ouvre une fenêtre (Wayland ou
X11) en demandant le mode immediate, que vkmark n'affiche pas : hwbench avertit alors que la
vsync n'est pas vérifiable. Un rendu logiciel (llvmpipe, lavapipe) est aussi signalé.
Binaire glmark2. glmark2-wayland sous Wayland (repli sur glmark2 via XWayland),
glmark2 sous X11, glmark2-drm sans session graphique.
Disque. fio travaille sur un fichier temporaire de 1 Gio (--disk-size, minimum 64M) dans
~/.cache/hwbench (--disk-path pour mesurer un autre disque ; $XDG_CACHE_HOME est
respecté). hwbench annonce le fichier avant de commencer, vérifie l'espace libre avant
d'écrire, et supprime le fichier à la fin, même en cas d'erreur ou de Ctrl+C. Les E/S directes
contournent le cache de pages ; un système de fichiers qui ne les accepte pas (tmpfs) fait
échouer le bench avec le message de fio. La taille du fichier fait partie de l'identité du
bench : une autre taille que 1 Gio n'est comparable ni à la référence ni à un fichier mesuré en
1 Gio (le cache SLC d'un SSD favorise les petits fichiers). Le score fio est un indice
(moyenne géométrique des quatre tests) ; les quatre valeurs sont affichées. Seuls le type de
système de fichiers et le modèle du disque sont relevés, jamais le chemin.
Ce que mesure le score disque. fio mesure un fichier dans un système de fichiers, pas le disque nu. Le même SSD peut donner des scores différents selon :
- le système de fichiers : ext4, btrfs (copie sur écriture, sommes de contrôle, compression éventuelle), xfs… n'empruntent pas le même chemin pour les E/S directes ;
- le cache du SSD : beaucoup de SSD écrivent d'abord dans un cache rapide (SLC, parfois DRAM) avant de ralentir quand il est plein ; avec 1 Gio et des tests de 2 s, on mesure surtout le disque dans son cache, pas son débit soutenu sur de gros volumes. Le remplissage du disque, son firmware et le noyau jouent aussi.
Le score disque ne se compare donc qu'à système de fichiers et taille de fichier égaux, ce que le rapport HTML rappelle. La référence est mesurée en ext4, avec un fichier de 1 Gio, sur un Lexar SSD NM1090 PRO 1TB.
Choix des scènes GPU
Une scène n'est gardée que si son FPS baisse d'au moins ×1,8 entre 1080p et 4K (4 fois plus de pixels) : son coût suit alors le nombre de pixels, elle mesure le GPU plutôt que le CPU ou le pilote. Étude sur Radeon RX 9070 XT (Mesa 26.2.3), rendu hors écran, 2 s par scène :
| Outil | Scène | FPS 1080p | FPS 4K | Ratio | Gardée |
|---|---|---|---|---|---|
| glmark2 | effect2d (flou 5×5) | 6 747 | 2 880 | 2,34 | oui |
| glmark2 | effect2d (contours) | 11 330 | 5 252 | 2,16 | oui |
| glmark2 | desktop (flou) | 4 569 | 2 250 | 2,03 | oui |
| glmark2 | terrain | 1 701 | 842 | 2,02 | oui |
| glmark2 | desktop (ombre) | 8 029 | 4 012 | 2,00 | oui |
| glmark2 | jellyfish | 10 816 | 5 548 | 1,95 | oui |
| glmark2 | refract | 3 332 | 1 721 | 1,94 | oui |
| glmark2 | shadow | 10 469 | 5 800 | 1,80 | oui |
| glmark2 | loop, function, conditionals | ~12 500 | ~7 400 | 1,66 à 1,71 | non |
| glmark2 | shading, bump, texture | ~15 500 | ~11 000 | 1,30 à 1,56 | non |
| glmark2 | build, buffer | 2 693 à 14 644 | 2 377 à 12 161 | 1,09 à 1,20 | non |
| vkmark | effect2d (flou) | 19 743 | 5 824 | 3,39 | oui |
| vkmark | effect2d (contours) | 35 680 | 15 448 | 2,31 | oui |
| vkmark | desktop, shading, texture, vertex | ~35 000 | ~25 000 | 1,20 à 1,50 | non |
| vkmark | cube, clear | ~33 000 | ~33 000 | 1,01 à 1,02 | non |
Les scènes simples plafonnent au même FPS quelle que soit la scène (~15 000 pour glmark2,
~35 000 pour vkmark en 1080p) : elles mesurent le coût d'une frame côté CPU et pilote. Changer
cette liste change les scores : la version du protocole (glmark2 v2, vkmark v2) est alors
incrémentée.
Fiabilité des mesures
Warm-up adaptatif : le bench enchaîne les itérations jusqu'à ce que deux consécutives soient à
moins de 3 % l'une de l'autre (--warmup-tolerance), dans la limite d'un plafond de 30 s en
single-core et mémoire, 90 s en multi-cœur et GPU, 60 s pour le disque (--max-warmup). Si le plafond est atteint sans stabilité,
hwbench l'indique. Suivent au moins 3 runs mesurés ; le score est leur médiane, l'écart-type est
conservé.
Le premier run, à froid, est gardé à part comme « burst » : sur un portable, le CPU tient un turbo court (PL2) avant de redescendre à sa puissance soutenue (PL1). Il est affiché pour information, mais n'entre jamais dans le score.
Le governor, le profil plateforme ACPI (platform_profile), l'EPP de cpu0
(energy_performance_preference), l'alimentation et la température CPU sont relevés avant et
après. hwbench avertit, sans bloquer, si la machine est sur batterie, si le profil d'énergie
n'est pas « performance », si le CPU dépasse 70 °C au départ (--hot-start) ou si les runs
varient de plus de 5 % (--max-cv).
Le score natif est un indice brut : la moyenne géométrique de débits hétérogènes, sans unité. Les points viennent du scoring, ci-dessous.
╭─ CPU single-core · native v1 ────────────────────────────────────────────────╮
│ Score (médiane)    126,0 indice brut  ± 0,8 (CV 0,6 %)                       │
│ Runs               125,0 · 126,0 · 126,6                                     │
│ Warm-up            2 itérations, 2,6 s · 6,3 s au total                      │
│ Burst (à froid)    125,1 indice brut  (hors score)                           │
│ Governor           performance                                               │
│ Profil plateforme  non disponible                                            │
│ EPP                performance                                               │
│ Alimentation       secteur (pas de batterie)                                 │
│ Température CPU    41 °C avant → 62 °C après                                 │
│  Charge                                   Médiane                            │
│  SHA-256                             2368,3 Mio/s                            │
│  Compression zlib (niveau 6)           66,0 Mio/s                            │
│  Compression LZMA (preset 1)           23,6 Mio/s                            │
│  Exponentiation modulaire 2048 bits     69,0 op/s                            │
│ CPython 3.14.7 · OpenSSL 3.6.4 25 Aug 2026 · zlib 1.3.2 · liblzma 5.8.4      │
╰──────────────────────────────────────────────────────────────────────────────╯
Scoring
Chaque bench est normalisé par rapport à la machine de référence, qui vaut 1000 points : un desktop ASRock B850 Riptide WiFi (AMD Ryzen 7 8700F, Radeon RX 9070 XT, EndeavourOS), mesuré en régime soutenu (référence actuelle mesurée avec Mesa 26.2.4). Choisi parce que ses mesures sont stables (CV ≤ 0,4 % en CPU et GPU, 1,64 % au plus en mémoire), qu'il n'a ni batterie ni profil d'énergie à surveiller, qu'il reste disponible pour régénérer la référence, et qu'il a le même environnement d'outils que les fixtures de test.
| Bench | Valeur de référence | CV |
|---|---|---|
| native-cpu-single v1 | 126,7 (indice) | 0,22 % |
| native-cpu-multi v1 | 1 143,6 (indice) | 0,39 % |
| sysbench-cpu-single v1 (sysbench 1.0.20) | 5 659 events/s | 0,13 % |
| sysbench-cpu-multi v1 (sysbench 1.0.20) | 45 642 events/s | 0,03 % |
| glmark2 v2 (2023.01, hors écran) | 3 664 fps | 0,14 % |
| vkmark v2 (2025.01, headless) | 10 733 fps | 0,11 % |
| native-memory-single v1 | 23 428 Mio/s | 0,17 % |
| native-memory-multi v1 | 30 036 Mio/s | 1,64 % |
| sysbench-memory-single v1 (sysbench 1.0.20) | 51 349 Mio/s | 0,16 % |
| sysbench-memory-multi v1 (sysbench 1.0.20) | 56 192 Mio/s | 0,30 % |
| fio-disk v1 (fio 3.42, fichier de 1 Gio, ext4) | 39 393 (indice) | 0,26 % |
Mémoire et disque sont notés (1000 points sur la référence) mais restent hors du score combiné et du classement.
- Un backend n'est noté que s'il a la même identité que dans la référence : même bench, même version du protocole, même version de l'outil, même mode de présentation. Sinon il est déclaré « non comparable », avec la raison. Exception : la version de fio, traitée comme le pilote GPU (voir plus bas).
- CPU single et multi : seul le backend natif compte. sysbench est noté à côté, pour information.
- GPU : moyenne géométrique de glmark2 et vkmark. Chaque score de catégorie garde la liste des backends utilisés ; si elle diffère de celle de la référence (vkmark absent par exemple), le score GPU est « non comparable ». Jamais de moyenne sur « ce qui est installé ».
- Mémoire et disque : catégories d'information. Mémoire = moyenne géométrique des deux benchs natifs (single et multi), sysbench à côté pour information ; disque = fio. Elles sont notées quand la référence contient ces benchs, sinon elles restent en valeurs brutes. Elles n'entrent jamais dans le score combiné ni dans le classement.
- Score combiné : moyenne géométrique pondérée des catégories CPU single, CPU multi et GPU
(1/3 chacune par défaut,
--weights). Sans GPU mesuré, il est calculé sur le CPU seul et le signale ; un GPU mesuré mais non comparable rend le combiné non comparable.
La référence est src/hwbench/data/reference.json, versionnée dans le repo. Elle se régénère
sur le desktop B850, depuis la session graphique (pour glmark2 et vkmark), rien d'autre ne
tournant :
.venv/bin/hwbench reference -o src/hwbench/data/reference.json
À refaire seulement quand ce qui fait l'identité d'un bench change : version du protocole hwbench (un test l'impose) ou version de l'outil (sysbench, glmark2, vkmark, fio) installée sur le desktop. Un résultat mesuré avec une autre version d'outil que la référence est déclaré non comparable.
Le pilote GPU (Mesa, RADV…) n'en fait pas partie : il change trop souvent (à chaque mise à
jour sur une distribution rolling comme Arch). Il reste relevé à titre d'information. Un
avertissement non bloquant n'apparaît que pour le même GPU avec une autre version amont
du pilote : dans hwbench bench, quand on mesure le GPU de la référence (la machine de
référence après une mise à jour de Mesa) ; dans hwbench compare, entre fichiers qui ont le
même GPU. Sur un autre GPU, le pilote est affiché comme simple information. La révision du
paquet est ignorée : « Mesa 26.2.4-arch1.1 », « Mesa 26.2.4-arch1.2 » et « Mesa 26.2.4 »
(Fedora) sont le même pilote. Le GPU est reconnu par son nom, sans les détails du renderer qui
changent avec le noyau.
La version de fio suit la même règle : elle est relevée et affichée, mais ne fait pas
partie de l'identité du bench disque. Le protocole fixe toutes ses options (libaio,
direct=1, taille de bloc, profondeur de file, durée), dont le comportement n'a pas changé de
fio 3.40 à 3.42, alors que chaque distribution livre une version différente. Un avertissement
non bloquant n'apparaît que pour le même modèle de disque mesuré avec une autre version de
fio (hwbench bench sur le disque de la référence, hwbench compare entre fichiers du même
disque) ; sur un autre disque, la version est une simple information. sysbench, lui, garde sa
version dans l'identité.
La commande refuse d'écrire le fichier si la machine n'est pas sur secteur, si le profil
d'énergie n'est pas « performance » (vérifié avant les mesures) ou si un warm-up ne se
stabilise pas (vérifié après). --force passe outre et l'inscrit dans le fichier
(forced_reasons), ce que hwbench bench rappelle ensuite. Tant que le fichier n'existe pas,
hwbench bench affiche les valeurs brutes, sans points.
Export et comparaison
hwbench export -o desktop.json                   # benchs + export (mêmes options que bench)
hwbench export -o portable.json --backend native
hwbench compare desktop.json portable.json [autre.json…]   # le premier fichier sert de base
export lance les benchmarks comme bench (mêmes options), affiche les mêmes résultats, puis
écrit un fichier JSON versionné : schema_version, date ISO, modèle de la machine, composants
(sans aucun identifiant, et passés par le filtre privacy.py), résultats complets (runs, burst,
état machine, versions d'outils), scores et empreinte de la référence utilisée.
compare affiche les fichiers côte à côte : machines, points par catégorie et combiné, valeurs
brutes de chaque bench, avec l'écart en pourcentage par rapport au premier fichier (vert si
meilleur, rouge si moins bon). Rien n'est comparé à peu près :
- un bench n'a d'écart que si son identité est la même dans les deux fichiers (version du protocole, version de l'outil, mode de présentation) ; sinon « non comparé (version différente) » et un avertissement ;
- un score de catégorie ou le combiné n'a d'écart que si les deux fichiers ont été notés contre la même référence (même empreinte) avec la même liste de backends (et, pour le combiné, les mêmes pondérations) ;
- un export sans référence garde ses valeurs brutes comparables, mais pas de points.
Les fichiers à comparer peuvent venir d'autres machines : leur texte est affiché tel quel, jamais interprété comme du balisage.
Deux exports successifs du desktop de référence (backend natif seul) :
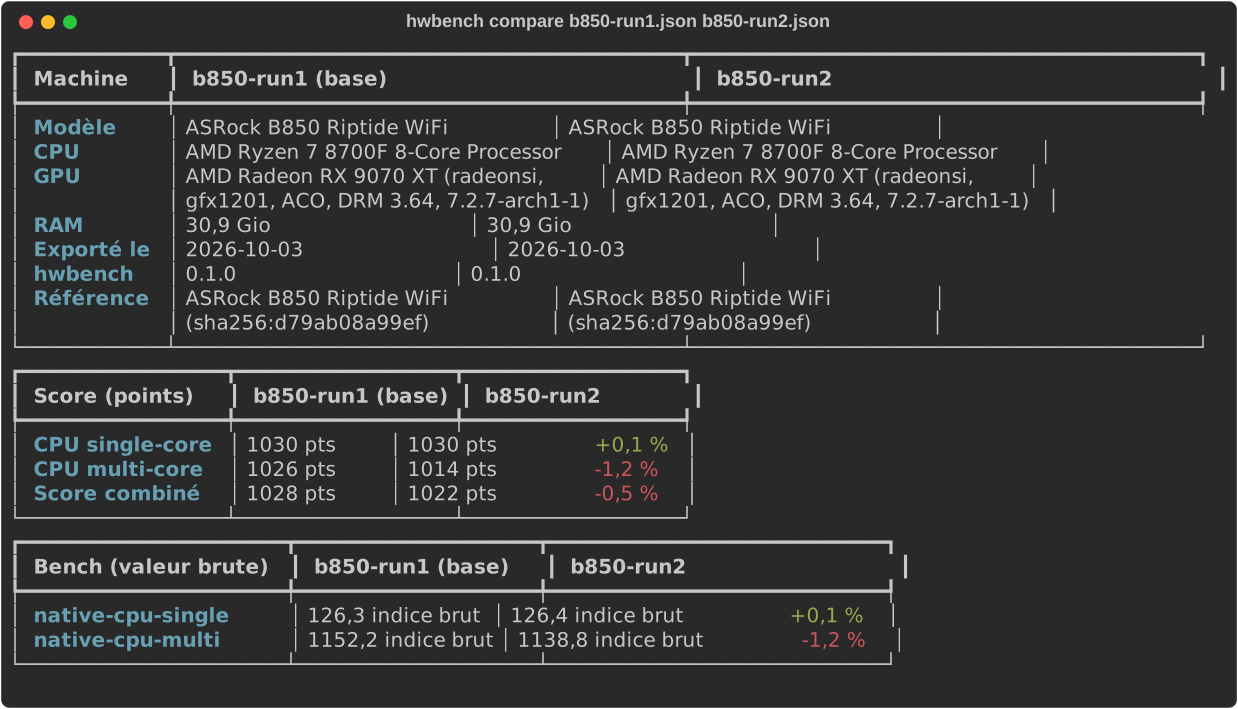
Les captures sont générées à partir de la vraie sortie des commandes par
scripts/readme_screenshots.py (info, bench, compare A B).
Rapport HTML
hwbench bench --report                    # session en JSON + rapport HTML
hwbench export -o desktop.json --report   # idem, en plus de l'export
hwbench report desktop.json               # rapport depuis un JSON existant (-o rapport.html)
Rien n'est écrit sans le demander. Avec --report, la session (même schéma que export) et
son rapport sont écrits dans ~/.local/share/hwbench/reports/ ($XDG_DATA_HOME respecté,
--report-dir pour un autre dossier), sous un nom horodaté à la seconde. Un bench interrompu
ou sans résultat n'écrit rien. hwbench report et --report produisent le même HTML : il est
toujours rendu à partir du JSON, jamais du système.
Le rapport est un fichier unique, hors ligne (aucune ressource externe), imprimable, en thème
clair ou sombre : chiffres clés, synthèse, conditions de mesure, processeur, carte graphique,
mémoire, disque, températures, fiabilité, composants, recommandations, lexique, et en annexe
les résultats bruts et le JSON complet de la session. Chaque phrase vient d'une règle qui cite
les valeurs mesurées et les seuils de la session (--max-cv, --hot-start, --reliable-cv…),
sans hypothèse sur une cause non mesurée. La température CPU n'est relevée qu'avant et après
chaque test, ce que le rapport précise. Les exports antérieurs au schéma 3 n'enregistrent pas
les seuils : le rapport utilise alors les seuils par défaut et l'indique.
La page de chaque machine du classement reprend les mêmes sections, sans les recommandations, et applique toujours les seuils par défaut.
Classement
Le classement est un site statique (GitHub Pages) généré à partir des exports déposés dans
results/ par pull request. Pour y ajouter une machine : hwbench export -o results/<nom>.json
puis une pull request, voir CONTRIBUTING.md.
Chaque fichier soumis est validé en CI (schéma connu, aucun identifiant, référence actuelle, versions de bench à jour, points cohérents avec les résultats bruts). Le site recalcule les points à partir des résultats bruts ; le score combiné n'est classé que s'il porte sur les trois catégories, comme la référence. Après une régénération de la référence, un fichier noté contre l'ancienne reste classé (points recalculés) avec la mention « à ré-exporter » ; une nouvelle soumission, elle, doit être notée contre la référence actuelle. Mémoire et disque apparaissent en colonnes d'information (points si la référence les contient, sinon valeurs brutes), hors classement. Les résultats sont déclaratifs.
python -m hwbench.leaderboard validate results/*.json      # validation locale
python -m hwbench.leaderboard site --results results --out _site
Dépendances système optionnelles
Aucune n'est obligatoire : si un outil manque, le champ correspondant est affiché « non disponible » ou « outil absent », sans erreur. hwbench n'installe jamais rien lui-même.
| Outil | Sert à | Fedora | Debian / Ubuntu |
|---|---|---|---|
lscpu, lsblk |
CPU, disques | util-linux (déjà présent) |
util-linux (déjà présent) |
lspci |
GPU (PCI) | sudo dnf install pciutils |
sudo apt install pciutils |
glxinfo |
GPU (OpenGL) | sudo dnf install glx-utils |
sudo apt install mesa-utils |
vulkaninfo |
GPU (Vulkan) | sudo dnf install vulkan-tools |
sudo apt install vulkan-tools |
nvidia-smi |
GPU NVIDIA | fourni par le pilote propriétaire | fourni par le pilote propriétaire |
dmidecode |
barrettes RAM (root) | sudo dnf install dmidecode |
sudo apt install dmidecode |
smartctl ≥ 7.0 |
santé des disques (root) | sudo dnf install smartmontools |
sudo apt install smartmontools |
sysbench |
bench CPU et mémoire externe | sudo dnf install sysbench |
sudo apt install sysbench |
glmark2 |
bench GPU OpenGL | sudo dnf install glmark2 |
sudo apt install glmark2-wayland glmark2-x11 |
vkmark |
bench GPU Vulkan | sudo dnf install vkmark |
sudo apt install vkmark |
fio |
bench disque | sudo dnf install fio |
sudo apt install fio |
Contribuer et versions
Les messages de commit suivent les conventional commits
(feat: …, fix: …, docs: …, ci: …), vérifiés par commitlint sur chaque pull request.
Chaque push sur main lance python-semantic-release,
qui déduit la version de ces messages (fix → correctif, feat → mineure), met à jour
pyproject.toml et CHANGELOG.md, crée le tag vX.Y.Z et la GitHub Release avec la wheel
et le sdist. Le développement se fait sur dev, les releases par pull request dev → main.
Vérifier la provenance d'une version
Chaque wheel et chaque sdist publiés sont accompagnés d'une attestation de provenance (SLSA, signée par Sigstore) produite par le workflow de release : elle prouve que le fichier a été construit par ce dépôt, à partir du commit tagué. Ce sont les mêmes fichiers sur la page Releases et sur PyPI. Pour vérifier, avec la CLI GitHub :
# dernière version publiée (ou VERSION=0.4.0 pour une version précise)
VERSION=$(gh release view --repo Mvth1s/hwbench --json tagName --jq '.tagName | ltrimstr("v")')

# depuis la GitHub Release
gh release download "v$VERSION" --repo Mvth1s/hwbench --pattern '*.whl'
gh attestation verify "hwbench-$VERSION-py3-none-any.whl" --repo Mvth1s/hwbench \
  --signer-workflow Mvth1s/hwbench/.github/workflows/release.yml

# ou depuis PyPI
pip download "hwbench==$VERSION" --no-deps
gh attestation verify "hwbench-$VERSION-py3-none-any.whl" --repo Mvth1s/hwbench
Sous fish : set VERSION (gh release view …) à la place de VERSION=$(…).
La commande échoue si le fichier a été modifié ou s'il n'a pas été construit par le workflow de release de ce dépôt. Les versions antérieures à l'ajout de l'attestation (0.1.0, 0.2.0) n'en ont pas.
Notifications
L'activité du projet est relayée sur Discord. Commits, pull requests, issues et discussions
passent par les webhooks natifs de GitHub. Le reste passe par des workflows GitHub Actions et
scripts/discord_notify.py (bibliothèque standard uniquement) :
- échecs de CI sur
devetmain, puis le retour au vert ; - soumissions au classement validées ou refusées (avec la raison) et nouvelles machines ;
- résultats de CI des pull requests Dependabot ;
- releases, publication sur PyPI et déploiements du site ;
- veille hebdomadaire des versions de glmark2, vkmark, sysbench et Python ;
- rapport hebdomadaire.
Ces workflows ne lisent que des métadonnées (événement, API GitHub), jamais le code d'une pull request. Une notification qui échoue ne fait jamais échouer un workflow.
Vie privée
Numéros de série (disques, RAM, système, carte mère), UUID produit, EUI-64/NGUID/WWN des
disques, asset tags et hostname ne sont pas lus par défaut et ne font jamais partie des données
collectées. Seul --show-serials les lit, dans une structure séparée, pour l'affichage local.
Toute sortie JSON passe en plus par un filtre de sécurité (privacy.py). L'UUID du GPU que
vkmark affiche n'est jamais relevé.
Licence
hwbench est distribué sous licence GNU AGPL v3 ou ultérieure (AGPL-3.0-or-later), à partir
de la version qui suit la 0.3.0 : texte complet dans
LICENSE. Les versions 0.1.0 à 0.3.0
ont été publiées sous licence MIT et le restent.
Les résultats soumis au classement (results/) sont des données, publiées sous CC0-1.0 :
voir CONTRIBUTING.md.
1 maintainer

Metadata
1 maintainer
Release files for hwbench 0.6.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| hwbench-0.6.0.tar.gz | 204.2 kB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| hwbench-0.6.0-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 343.4 kB
Release files / hwbench-0.6.0.tar.gz
| Download URL | hwbench-0.6.0.tar.gz |
|---|---|
| Size | 204.2 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
32ab298796d51aa3a6c98c6fdb55f09656b1e371ac13f6eb529d21e1c546b1c6
|
|
BLAKE2b-256 checksum How to use checksums |
eb21ca546699ef8810a87400e9f9dcef2cad2a1a9a924c49e59c441e8c097e59
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.14
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.


PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Oct 9, 2026.
Transparency logRelease files / hwbench-0.6.0-py3-none-any.whl
| Download URL | hwbench-0.6.0-py3-none-any.whl |
|---|---|
| Size | 139.2 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
de1c6c92d35ffc1f63fbd41860e263b39735e1f75cac0991716801668f1602fc
|
|
BLAKE2b-256 checksum How to use checksums |
ef0d72b564cfa8d1bb07a2880b91e6eebc39ca2b84ef607f8b27a226e864fe37
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.14
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Oct 9, 2026.
Transparency log













