
Limina AI — Python SDK



Observe, evaluate, and regression-test multi-turn AI agents with local CPU-native evaluation and automated CI/CD gating.
Why Limina?
Multi-turn AI agents and RAG pipelines are notoriously difficult to debug once they involve chained tool calls, database lookups, and changing system prompts.
Traditional LLM-as-a-judge approaches are slow, expensive, and non-deterministic when run across continuous integration test suites.
Limina provides a unified developer toolkit to:
- Observe: Trace multi-turn agent state transitions, tool execution latency, and payload grounding.
- Evaluate: Benchmark historical chat transcripts without running costly second-judge models.
- Compare: Measure exact mathematical deltas between baseline and candidate prompts.
- Gate: Block breaking regressions automatically in CI/CD pull requests before deployment.
Architecture Flow
Your Agent / Pipeline (OpenAI, LangChain, Custom)
       │
       ▼
  Limina SDK
  ├── Real-Time Tracing (@monitor.trace)
  ├── Log & Transcript Evaluation (evaluate_logs)
  ├── 4-Quadrant Regression Comparator (compare)
  └── Adversarial Red-Teaming (run_stress_test)
       │
       ▼
  Limina Engine ──► Interactive HTML / Dashboard / CI Gating (PR Block)
Installation
pip install limina-ai
Quickstart (30 Seconds)
Set your API key as an environment variable:
export LIMINA_API_KEY="limina_live_..."
Wrap your existing agent function — Limina captures execution telemetry without altering your agent logic:
from limina import LiminaMonitor
from openai import OpenAI

client = OpenAI()
monitor = LiminaMonitor()

@monitor.trace(session_id="run_001")
def support_agent(user_query: str):
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": user_query}]
    )
    return response.choices[0].message.content

# Run your agent
response = support_agent("Can I return an item after 30 days?")
monitor.flush()
What You Get
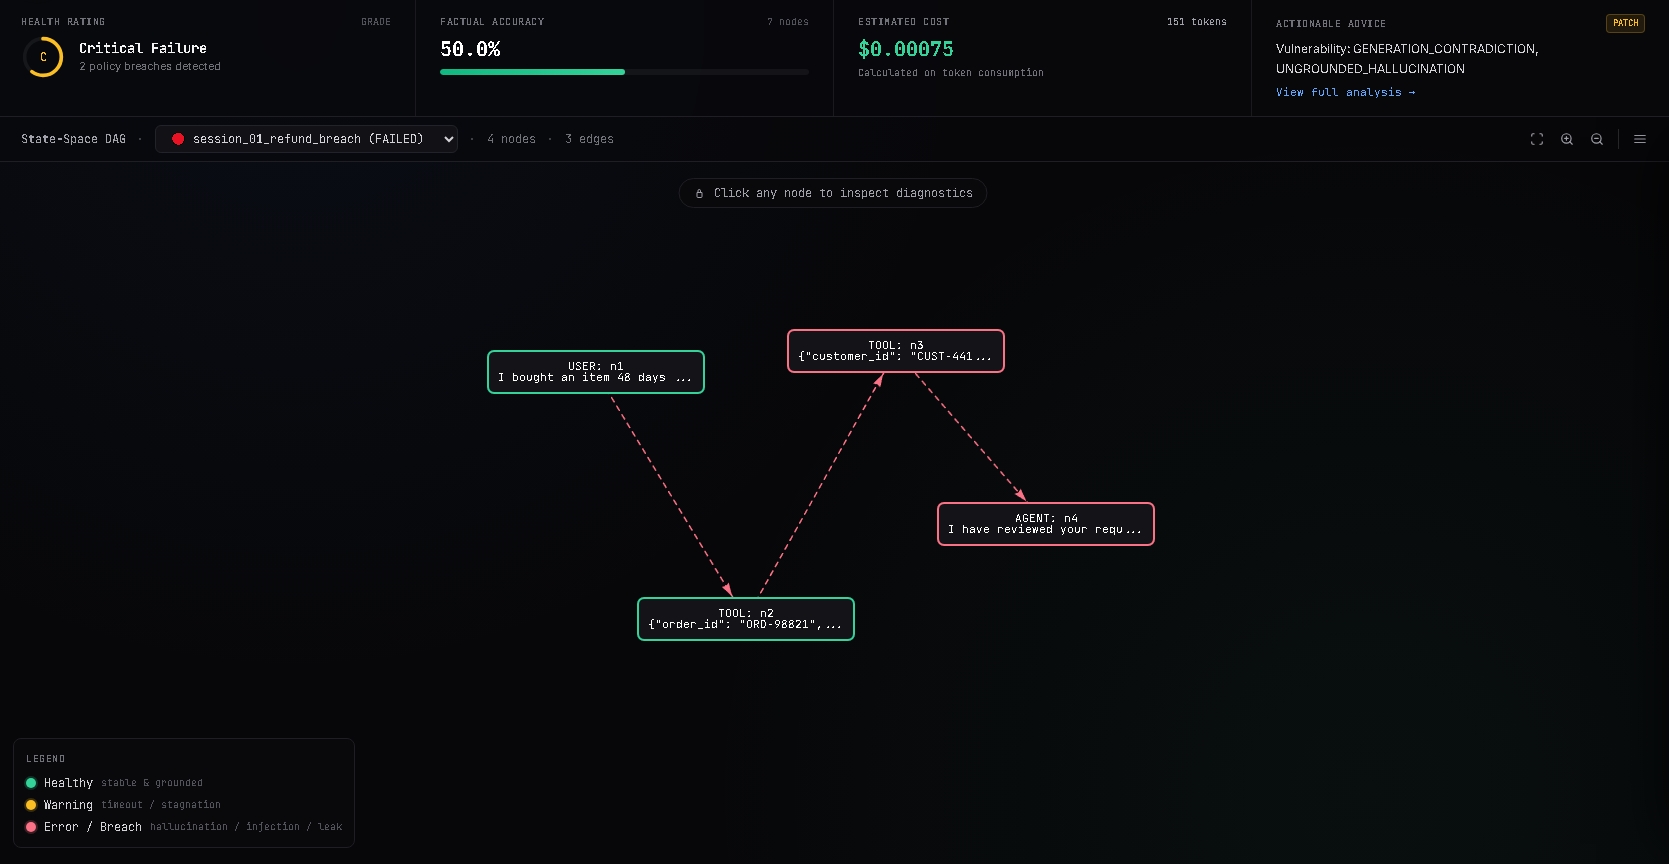
Tracing an agent or evaluating a dataset produces structured diagnostic telemetry and standalone visual reports:
Core Capabilities
1. Observe: Tool & Agent Tracing
Track tool execution latency, capture structured parameters, and verify factual grounding:
from limina import LiminaMonitor

monitor = LiminaMonitor(export_html=True)

@monitor.trace_tool(tool_name="database_policy_lookup")
def query_policy(order_id: str):
    return {"max_return_days": 14, "allow_cash": False}

@monitor.trace(session_id="session_order_check")
def agent(user_query: str):
    policy = query_policy("ORD-101")
    return "Our store policy specifies a maximum return window of 14 days."

agent("I want a refund for order #101.")
monitor.flush()
# Generates 'report.html' on disk with interactive DAG and context inspection
2. Evaluate: Historical Log Ingestion
Limina verifies generated claims directly against supplied tool outputs and conversation context instead of relying on a second generative judge for every assertion:
from limina import LiminaMonitor

monitor = LiminaMonitor()

# Evaluate directly from OpenAI message transcripts
openai_messages = [
    {"role": "user", "content": "Can I return an item after 45 days?"},
    {"role": "tool", "content": '{"max_days": 14, "cash_refund": false}'},
    {"role": "assistant", "content": "Returns are strictly limited to 14 days."}
]

report = monitor.evaluate_logs(openai_messages)

print(f"Health Rating : {report['executive_summary']['health_rating']}")
print(f"Success Rate  : {report['executive_summary']['success_rate_percentage']}%")
3. Compare: Regression Diff Engine & CI/CD Gating
When updating system prompts or switching models, compare a Baseline against a Candidate agent dataset. Limina evaluates the mathematical delta across a 4-Quadrant State Matrix:
- Fixed Scenarios: Trajectories that previously failed and are now resolved.
- New Regressions: Previously passing scenarios that broke after the prompt patch.
- Persistent Failures: Scenarios that remain ungrounded in both versions.
- Stable Passing: Scenarios consistently passing across both versions.
from limina import LiminaMonitor

monitor = LiminaMonitor()

# Compare baseline vs candidate runs
# fail_on_regression=True raises RuntimeError on detected regressions (blocks CI merge)
diff_report = monitor.compare(
    baseline_logs="datasets/baseline_golden.json",
    candidate_logs="datasets/candidate_patched.json",
    fail_on_regression=True
)

analysis = diff_report["regression_analysis"]
print(f"Verdict     : {analysis['verdict']} (Gate: {analysis['ci_gate_status']})")
print(f"Delta Acc   : {analysis['metrics']['delta_accuracy_percentage']:+0.1f}%")
print(f"Fixed Bugs  : {analysis['breakdown']['fixed_count']}")
print(f"Regressions : {analysis['breakdown']['new_regressions_count']}")
Framework Integrations
LogAdapter automatically standardizes third-party agent logs into State-Space Directed Acyclic Graphs (DAGs):
from limina import LogAdapter

# 1. From OpenAI Tool-Calling transcripts
trajectories = LogAdapter.from_openai(openai_messages, session_id="eval_01")

# 2. From LangSmith / LangChain Run Trees
trajectories = LogAdapter.from_langsmith(langsmith_run_dict)

# 3. Auto-detect any structure (JSON file path, raw list, or dict)
trajectories = LogAdapter.auto_convert("logs/production_traces.json")
Policy Configuration (limina.yaml)
Use limina.yaml when the same compliance constraints and strictness rules should apply consistently across local development and CI/CD pipelines:
# limina.yaml
strictness_profile: "standard"   # Options: "standard", "banking", "healthcare", "customer_support", "creative"
max_sentences: 14
max_tool_latency_ms: 3000.0

custom_rules:
  forbidden_words:
    - "competitorxyz"
    - "guaranteed profit"
  required_words: []
Adversarial Red-Teaming (run_stress_test=True)
Evaluate agent resilience against user typos, stochastic character perturbations, and prompt injection attacks:
report = monitor.evaluate_logs("production_traces.json", run_stress_test=True)
Output Contract & CI Consumption
All evaluation and comparison methods return standard JSON-serializable Python dictionaries, allowing programmatic assertions in test suites:
def test_agent_regression():
    report = monitor.compare(baseline_data, candidate_data)

    analysis = report["regression_analysis"]
    assert analysis["ci_gate_status"] == "PASSED"
    assert analysis["breakdown"]["new_regressions_count"] == 0
Compatibility & Requirements
- Python Versions: 3.8, 3.9, 3.10, 3.11, 3.12
- Execution Modes: Full support for both synchronous (
def) and asynchronous (async def) agent functions. - Integrations: Standard OpenAI message schemas, LangChain / LangSmith run trees, and custom DAG JSON formats.
- CI/CD Environments: GitHub Actions, GitLab CI, and standard test runners (
pytest).
Current Limitations
- Context Grounding Scope: Atomic grounding checks verify assertions against retrieved tool payloads and supplied conversation context; external unsupplied knowledge bases are not indexed automatically.
- Regression Alignment: The regression comparator matches trajectories primarily by
session_id. Datasets without matching identifiers are aligned sequentially.
Privacy, Security & Data Governance
- Zero Data Retention: Customer conversation logs and tool outputs are processed ephemerally in volatile memory during evaluation and are not retained on disk.
- No Foundation Model Training: Customer data is never stored, aggregated, or used for model training.
- Cryptographic Key Isolation: API keys are never stored in plaintext and rely on SHA-256 one-way hashing for authentication.
- Non-Blocking Runtime: Tracing decorators execute asynchronously on background threads to prevent latency overhead on host agents.
API Reference (Summary)
| Class / Method | Description |
|---|---|
LiminaMonitor(api_key, profile, export_html) |
Initializes the client. Reads LIMINA_API_KEY by default. |
@monitor.trace(session_id, description) |
Decorator for sync and async agent execution functions. |
@monitor.trace_tool(tool_name) |
Decorator measuring tool execution duration and payload. |
monitor.evaluate(payload) |
Evaluates a structured State-Space DAG batch. |
monitor.evaluate_logs(input_data) |
Evaluates raw JSON paths, OpenAI transcripts, or LangSmith dumps. |
monitor.compare(base, cand, fail_on_regression) |
Runs mathematical regression comparison and CI gating. |
monitor.flush() |
Blocks until pending background trace dispatches complete. |
License
Distributed under the Apache-2.0 License.
1 maintainer

Metadata
1 maintainer
Release files for limina-ai 1.0.6
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| limina_ai-1.0.6.tar.gz | 15.7 kB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| limina_ai-1.0.6-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 27.8 kB
Release files / limina_ai-1.0.6.tar.gz
| Download URL | limina_ai-1.0.6.tar.gz |
|---|---|
| Size | 15.7 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
20097036eaa913bb0b616f0dbd6bf8134591eddcc5f31610b10bfee4547b13cf
|
|
BLAKE2b-256 checksum How to use checksums |
f2df24430673dea0a150309e8144bb7f152c1b3a577bd49ad5a87f46dc59fb60
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/6.2.0 CPython/3.9.7
|
Release files / limina_ai-1.0.6-py3-none-any.whl
| Download URL | limina_ai-1.0.6-py3-none-any.whl |
|---|---|
| Size | 12.2 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
7bc3a1af88413430dbf8e2f722658ea8ea53d168843c6fe8ce7307be71f009e7
|
|
BLAKE2b-256 checksum How to use checksums |
bc1d637bba919e246f334af4eb23c95a34d5eddaf5d896d0a3fc5dad7a14dfa8
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/6.2.0 CPython/3.9.7
|














