
local-delegate
Delega tareas mecánicas texto→texto a un LLM local para conservar la cuota de tu suscripción de Claude.
Un servidor MCP (stdio o daemon HTTP compartido) que es cliente genérico de cualquier
endpoint OpenAI-compatible — llama-swap, Ollama, LM Studio, vLLM.


zahirinatzuke.github.io/local-delegate — qué
hace y por qué, en una página (es/en). Su fuente está en site/.
Demo
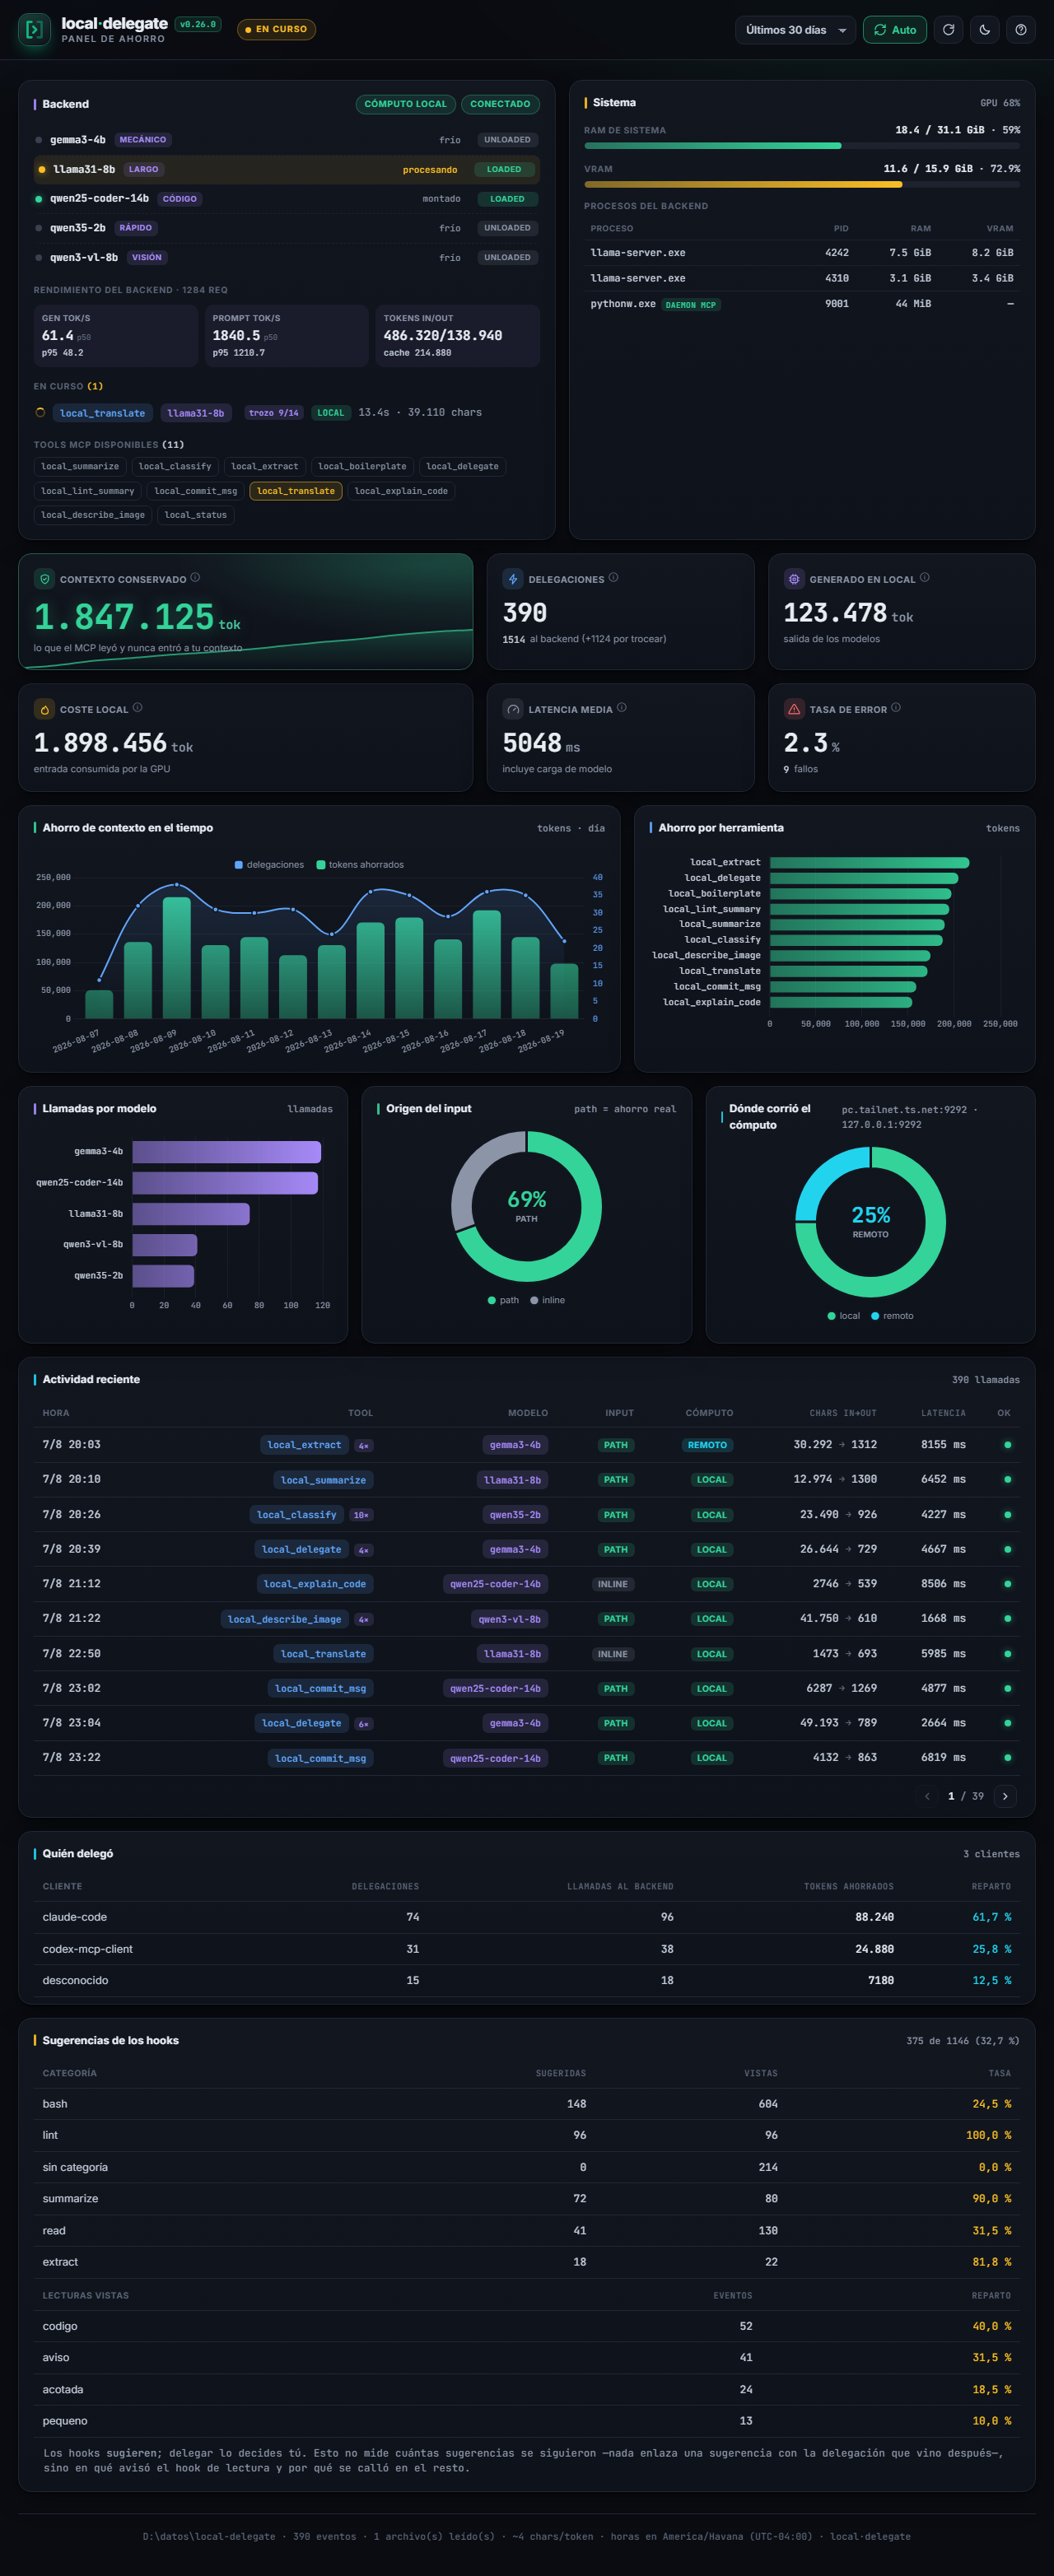
Dashboard embebido (datos de ejemplo): estado del backend local (modelos montados, delegación en curso con su progreso por trozos, tools MCP), RAM/VRAM del sistema con consumo por proceso, tokens de contexto conservados, ahorro por herramienta y modelo, dónde corrió el cómputo —esta máquina o un backend remoto— y actividad reciente paginada en tu hora local. Se sirve en http://127.0.0.1:9393.
¿Por qué?
Cuando Claude tiene que resumir un log enorme, clasificar, extraer campos o generar boilerplate,
gasta cuota de tu suscripción en trabajo mecánico. local-delegate expone esas tareas como
tools MCP que corren en un LLM local: pasas path en vez de text y el archivo se lee
del lado del servidor, así el contenido grande nunca entra al contexto de Claude. Solo
vuelve el resultado corto — cuota que no gastaste.
Instalación rápida
Con uv no hay nada que instalar: uvx baja y ejecuta el paquete aislado.
Añádelo a tu config de MCP (Claude Desktop / Claude Code) en modo compatible stdio:
{
  "mcpServers": {
    "local-delegate": {
      "command": "uvx",
      "args": ["local-delegate-mcp"]
    }
  }
}
Ver plantillas completas en examples/.
O deja que el paquete lo configure todo por ti —entrada MCP, hooks, skill y la regla de
delegación en tu CLAUDE.md/AGENTS.md global— con un solo comando:
uv tool install local-delegate-mcp          # deja `local-delegate` en el PATH
local-delegate install --dry-run            # muestra exactamente qué tocaría
local-delegate install                      # aplica
También sirve uvx local-delegate-mcp install para probarlo sin instalar nada, pero ten en cuenta
que uvx no deja el comando disponible: monta un entorno efímero y lo borra al terminar, así
que después local-delegate doctor responderá «command not found». El propio install te lo avisa
si detecta ese caso.
Es idempotente, deja .bak de lo que edita, no toca configuración ajena y se revierte con
local-delegate uninstall. Detalle y opciones en Instalación de la integración.
Si usas varias sesiones o varios clientes en la misma máquina, se recomienda un solo daemon:
uvx local-delegate-mcp serve
El daemon sirve MCP en http://127.0.0.1:9393/mcp y el dashboard en
http://127.0.0.1:9393/. Codex, Claude Code, opencode y cualquier cliente compatible con Streamable HTTP
pueden compartir esa URL sin levantar procesos MCP duplicados. Guía completa:
Daemon compartido.
Para usar la GPU de otra máquina manteniendo los paths locales del cliente, usa un MCP local que apunte al backend remoto: guía Mac → PC y recipe técnica completa.
No fijes una versión vieja «por estabilidad». Un pin (
==X.Y.Z) congela también los rangos de dependencias que declaraba aquel wheel, y eso envejece mal: las versiones anteriores a la 0.12.2 pedíanmcpsin techo, así que hoy resuelven al SDK 2.x y mueren en el import. Si necesitas fijar, fija la actual, y súbela cuando salga una nueva.
En Windows, si lo registras como tarea al iniciar sesión, ejecuta el pythonw.exe del entorno
donde instalaste el paquete con -m local_delegate serve --log-level warning. pythonw no crea
consola ni botón en la barra de tareas. La tarea pertenece al usuario de Windows, no a Codex
ni a Claude: cualquier cliente local comparte el mismo daemon. El dashboard identifica ese único
proceso con la insignia DAEMON MCP; las sesiones conectadas son clientes HTTP, no procesos MCP
adicionales.
Requisitos
Python 3.11+ — con uvx no tienes que instalarlo tú, lo resuelve él; solo importa si instalas
con pip en un entorno propio.
Y un endpoint OpenAI-compatible ya corriendo, accesible en LOCAL_DELEGATE_BASE_URL
(default http://127.0.0.1:9292/v1). Cualquiera sirve:
- llama-swap — ver recipe con GPU Blackwell.
- Ollama —
http://127.0.0.1:11434/v1. - LM Studio, vLLM, o cualquier servidor que hable la API de OpenAI.
El paquete no arranca ningún backend por defecto (LOCAL_DELEGATE_AUTOSTART=0). El
auto-arranque de llama-swap es opt-in (ver tabla de configuración).
¿Qué versiones de llama-server/llama-swap usar y cómo disponer el workspace? Ver
Versiones del backend y workspace de referencia (sugerencia
probada, no requisito). local-delegate doctor compara tu instalación contra esas versiones y, de
paso, comprueba el resto del andamiaje —hooks, skill, memoria, entradas MCP y el daemon— sin
escribir nada (qué mira cada check).
Tools
Pasar path (en vez de text) hace que el MCP lea el archivo server-side → ahorro real de cuota.
| Tool | Qué hace | Rol de modelo (default) |
|---|---|---|
local_summarize |
Resume texto o archivo | mecánico / largo (auto) |
local_classify |
Devuelve UNA etiqueta de una lista | mecánico |
local_extract |
Extrae campos → objeto validado, no una cadena que haya que parsear | mecánico / largo (auto) |
local_boilerplate |
Genera código desde una spec y lo escribe en target; devuelve solo un recibo |
código |
local_delegate |
Escape genérico texto→texto | mecánico (o el que pases) |
local_lint_summary |
Resume logs de lint/tests/CI | mecánico / largo (auto) |
local_commit_msg |
Mensaje de commit desde un diff | código |
local_translate |
Traduce texto o archivo | mecánico / largo (auto) |
local_explain_code |
Explica código en prosa | código |
local_describe_image |
Describe una imagen o responde una pregunta sobre ella (imagen→texto) | visión |
local_status |
Diagnóstico de solo lectura: backend, catálogo, log, VRAM, RAM de sistema | — (no llama al backend de chat) |
Los modelos locales no usan tool-calling: el server arma el prompt + guardrails, hace POST al endpoint y devuelve solo texto.
Documentos largos. local_translate (y local_delegate con entradas largas) parten el texto
por límites naturales —headers Markdown, párrafos, líneas— y procesan un trozo por llamada
respetando el techo de max_tokens, concatenando las salidas en orden y conservando el formato en
las costuras. Un documento de 20 000+ caracteres vuelve completo en vez de cortado a mitad. El log
registra chunks: N y el dashboard muestra el progreso (trozo 3/7) mientras corre.
Resúmenes de documentos enormes. local_summarize y local_lint_summary hacen map-reduce
cuando la entrada no cabe en el modelo: resumen cada parte y luego resumen los resúmenes, por
niveles si hace falta. Antes truncaban —de un log de CI enorme se resumía el principio y el resto
se descartaba en silencio, que es justo donde suelen estar los errores— y ahora se lee entero.
local_extract sigue truncando a propósito: fusionar el JSON de varios trozos no tiene una
respuesta única y adivinarla sería peor que avisar.
Configuración
Todo por variables de entorno; nada hardcodeado. Los ids de modelo default son solo eso — cámbialos por los de tu backend.
| Variable | Default | Descripción |
|---|---|---|
LOCAL_DELEGATE_BASE_URL |
http://127.0.0.1:9292/v1 |
Endpoint OpenAI-compatible |
LOCAL_DELEGATE_API_KEY |
(vacío) | Bearer token, si tu endpoint lo exige |
LOCAL_DELEGATE_BACKEND_ORIGIN |
auto |
local/remote fuerzan el origen del cómputo; auto lo deduce del host. Ponlo si llegas al backend por un túnel (ssh -L, port-forward): en loopback se vería como local |
LOCAL_DELEGATE_TIMEOUT |
180 |
Timeout HTTP (segundos) |
LOCAL_DELEGATE_MAX_CONCURRENT_REQUESTS |
2 |
Backpressure máximo por proceso; compartido por todos los clientes del daemon |
LOCAL_DELEGATE_ASK |
1 |
Preguntar al usuario (vía elicitation) en vez de fallar seco: backend caído, modelo fuera del catálogo, output_format vacío. 0 lo desactiva |
LOCAL_DELEGATE_ASK_TIMEOUT |
30 |
Segundos de espera por una respuesta; agotados, la tool sigue como si no hubiera preguntado |
LOCAL_DELEGATE_LOG_DIR |
(dir de datos de usuario) | Directorio de los usage-YYYYMM.jsonl rotados por mes y del clients.jsonl |
LOCAL_DELEGATE_LOG |
(vacío = rotación activa) | Si se fija, ruta de un usage.jsonl explícito sin rotar (compatibilidad) |
LOCAL_DELEGATE_MODEL_MECHANICAL |
gemma3-4b |
Modelo para clasificar/extraer/resumen corto |
LOCAL_DELEGATE_MODEL_LONG |
gemma4-26b-a4b |
Modelo para documentos largos |
LOCAL_DELEGATE_MODEL_CODE |
qwen36-35b-a3b |
Modelo para código |
LOCAL_DELEGATE_MODEL_VISION |
gemma4-12b |
Modelo de visión para local_describe_image |
LOCAL_DELEGATE_MAX_IMAGE_MB |
8 |
Tope de tamaño de imagen para local_describe_image |
LOCAL_DELEGATE_LONG_INPUT_CHARS |
6000 |
Umbral mecánico↔largo |
LOCAL_DELEGATE_CHUNK_CHARS |
3500 |
Tamaño de trozo al partir documentos largos (local_translate, local_delegate) |
LOCAL_DELEGATE_CHUNK_MAX_TOKENS |
2048 |
Techo de max_tokens por trozo |
LOCAL_DELEGATE_CHUNK_MIN_CHARS |
400 |
Trozo mínimo: por debajo ya no se vuelve a partir |
LOCAL_DELEGATE_JSON_SCHEMA |
auto |
response_format con schema en local_extract: auto/on/off |
LOCAL_DELEGATE_FEEDBACK |
1 |
Línea de ahorro anexada al resultado cuando source=path (0 la apaga). En local_extract no se anexa al texto —rompería el JSON—: va dentro de _local_delegate |
LOCAL_DELEGATE_ALLOWED_DIRS |
(vacío = sin restricción) | Raíces permitidas para path, separadas por ; |
LOCAL_DELEGATE_WEB |
1 |
Web embebida del modo stdio (0 para desactivarla) |
LOCAL_DELEGATE_WEB_HOST / _PORT |
127.0.0.1 / 9393 |
Host/puerto de la web o del daemon |
LOCAL_DELEGATE_WEB_FONTS |
1 |
Tipografía de marca desde Google Fonts (0 = cero peticiones a terceros) |
LOCAL_DELEGATE_AUTOSTART |
0 |
Auto-arranque de llama-swap (opt-in) |
LLAMASWAP_EXE / LLAMASWAP_CONFIG / LLAMASWAP_LISTEN |
— | Solo si AUTOSTART=1 |
LLAMASWAP_WATCH_CONFIG |
0 |
1 añade -watch-config al backend autoarrancado |
LOCAL_DELEGATE_FALLBACK |
1 |
Respaldo entre modelos: si el modelo de un rol falla por su culpa, responde el siguiente de su cadena (_MAX_HOPS=2; cadenas con _<ROL>, ver la wiki). 0 lo apaga |
LOCAL_DELEGATE_COOLDOWN |
1 |
Enfriamiento por modelo: 3 fallos seguidos (_FAILURES) lo paran 120 s (_S), doblando hasta 900 s (_MAX_S). 0 lo apaga |
La métrica de ahorro
El MCP registra cada llamada en un log rotado por mes y sirve un dashboard en
http://127.0.0.1:9393, con selector de rango y visibilidad de delegaciones en curso.
El ahorro de contexto = la entrada leída server-side (llamadas con source=path) ≈ tokens que
nunca entraron al contexto de Claude, contados una vez por delegación aunque el MCP la trocee.
Enfrente, el coste local = los tokens que consumió de verdad tu GPU sumando todas las
llamadas: una delegación troceada repite el prompt de sistema en cada trozo, y esa diferencia es
lo que costó trocear. Se usa siempre el token real que reporta el backend; chars ÷ 4 es solo el
respaldo cuando no lo da. Detalle en la wiki.
Los rangos, los días del gráfico y las horas de la tabla usan tu zona horaria (el log se
escribe en UTC, que es un instante sin ambigüedad; la conversión es de presentación). El
dashboard también separa dónde corrió el cómputo: local si el backend escucha en loopback,
remote si la inferencia se fue a otra máquina —por ejemplo esta Mac usando la GPU de la PC—.
Los eventos anteriores a la v0.11.0 no traen el campo y aparecen como n/d.
Alcance / no-objetivos
local-delegate es deliberadamente texto/imagen→texto: arma el prompt (o el payload
multimodal), hace POST a /chat/completions y devuelve solo texto. Cosas que no hace
a propósito:
- Tool-calling local. Los modelos locales no invocan herramientas ni ejecutan código; eso lo sigue haciendo Claude. Añadirlo convertiría este paquete en un orquestador paralelo, que no es el objetivo.
- Generación o edición de imágenes.
local_describe_imagees solo imagen→texto (describir, leer texto visible, responder una pregunta puntual); nada de generar ni editar imágenes. - Audio. Para transcripción usa el companion
whisper-transcribe-mcpen vez de intentar meter audio aquí. - Sustituir la suscripción. El objetivo es conservar cuota delegando pasos mecánicos acotados, no enrutar todo el trabajo a modelos locales.
Integración con el cliente: hooks, skill y memoria
local-delegate install deja lista la integración completa en tu HOME:
| Componente | Dónde | Qué hace |
|---|---|---|
| Entrada MCP | config de Claude Code / ~/.codex/config.toml / ~/.config/opencode/opencode.json[c] |
registra el servidor (stdio con uvx o HTTP contra el daemon) |
| Hooks | ~/.claude/hooks/local-delegate/ + settings.json |
sugieren delegar; los de lectura además pueden rechazar una lectura completa de documentación, si se enciende |
| Skill | ~/.claude/skills/delegacion-local/ y ~/.config/opencode/skill/delegacion-local/ |
regla de oro y catálogo de tools |
| Memoria | bloque gestionado en ~/.claude/CLAUDE.md, ~/.codex/AGENTS.md y ~/.config/opencode/AGENTS.md |
la regla en una nota corta siempre cargada |
Por defecto se configuran solo los clientes que tengas instalados; se elige a mano con
--clients claude|codex|opencode. Los hooks son solo de Claude Code: opencode extiende con
plugins en TypeScript, que es otra superficie, y Claude Desktop no tiene hooks en absoluto. Cada
pieza se puede excluir (--no-hooks, --no-skill, --no-memory, --no-mcp).
El único hook que se instala solo es UserPromptSubmit (intenciones mecánicas). Los dos de
lectura —PreToolUse/Read y PreToolUse/Bash|PowerShell— quedan apagados salvo
--enable-read-hook, que los registra y los enciende juntos (uninstall los apaga). Van juntos
porque son una regla sola sobre dos caminos: cerrar la tool Read y dejar cat informe.md
abierto no cambia la conducta, la muda de sitio.
Esos dos avisan; rechazar una lectura es otra cosa y viene aparte y apagada
(LD_HOOK_READ_BLOQUEAR). Solo alcanza a la lectura completa de un .md o un .txt grande, con
el backend local respondiendo, y el mensaje del rechazo nombra la tool que sirve y la salida de
emergencia: leer por franjas nunca se bloquea. El motivo de que exista es que está medido —cuatro
veces— que sugerir no cambia la conducta.
Ver Instalación de la integración y
docs/recipes/claude-code-hooks.md.
Groups de llama-swap (opcional)
Con pip install "local-delegate-mcp[llamaswap]" quedan disponibles dos CLIs para gestionar
groups de llama-swap (un modelo residente siempre cargado + un pool que se turna) con
guardrail de VRAM y RAM de sistema incorporado (--ram-gb es opcional: llama-server
mapea el GGUF también en RAM aunque el cómputo sea 100% GPU, así que un catálogo que cabe en
VRAM puede igual agotar la RAM en máquinas con menos de 32 GB):
local-delegate check-llamaswap --config config.yaml --vram-gb 16 --ram-gb 32
local-delegate init-llamaswap --config config.yaml --resident gemma3-4b --swap gemma4-26b-a4b,qwen36-35b-a3b --vram-gb 16 --ram-gb 32
El paquete nunca toca tu config.yaml por su cuenta — estos comandos solo corren si vos
los invocás. init-llamaswap corre el/los guardrail(es) antes de escribir (no escribe nada si
no cabe en VRAM o, si pasaste --ram-gb, en RAM) y nunca sobreescribe sin --force (dejando
.bak). Detalle completo, semántica de groups verificada contra el código de llama-swap, y
ritual de aplicación en docs/recipes/llama-swap-groups.md.
Enlaces
1 maintainer

Metadata
1 maintainer
Release files for local-delegate-mcp 0.31.2
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| local_delegate_mcp-0.31.2.tar.gz | 3.7 MB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| local_delegate_mcp-0.31.2-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 4.1 MB
Release files / local_delegate_mcp-0.31.2.tar.gz
| Download URL | local_delegate_mcp-0.31.2.tar.gz |
|---|---|
| Size | 3.7 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
bb2d6a43af273a82ad1ed26946a739ac244b61d8ec17488c5710d52767114c8b
|
|
BLAKE2b-256 checksum How to use checksums |
aa15a91304974d07126938138da8ccfe39b641db71350af8ccb7ab717220a861
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
uv/0.12.17 {"installer":{"name":"uv","version":"0.12.17","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
|
Release files / local_delegate_mcp-0.31.2-py3-none-any.whl
| Download URL | local_delegate_mcp-0.31.2-py3-none-any.whl |
|---|---|
| Size | 325.5 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
72629fc6136aa263569f0d2e14c38573b2551f7b4bc860ef08e44afc1d72a484
|
|
BLAKE2b-256 checksum How to use checksums |
e60e8b38744a39914b009d696219dde865de2f10e00e4afcba08afe3b460a079
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
uv/0.12.17 {"installer":{"name":"uv","version":"0.12.17","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
|














