
md-to-word




English | 简体中文
把 Markdown 编译成符合规范的 Word(.docx)。学位论文、期刊投稿、技术报告、公文、说明书都用
同一套写法——差别只在那份 format.txt:排版规则写在稿件旁边,跟着稿件一起进 Git;同一份源任何
时候重跑,产物逐字节一致;格式没写全、样式名写错、引文缺文献库,导出前就中止并指出第几行。
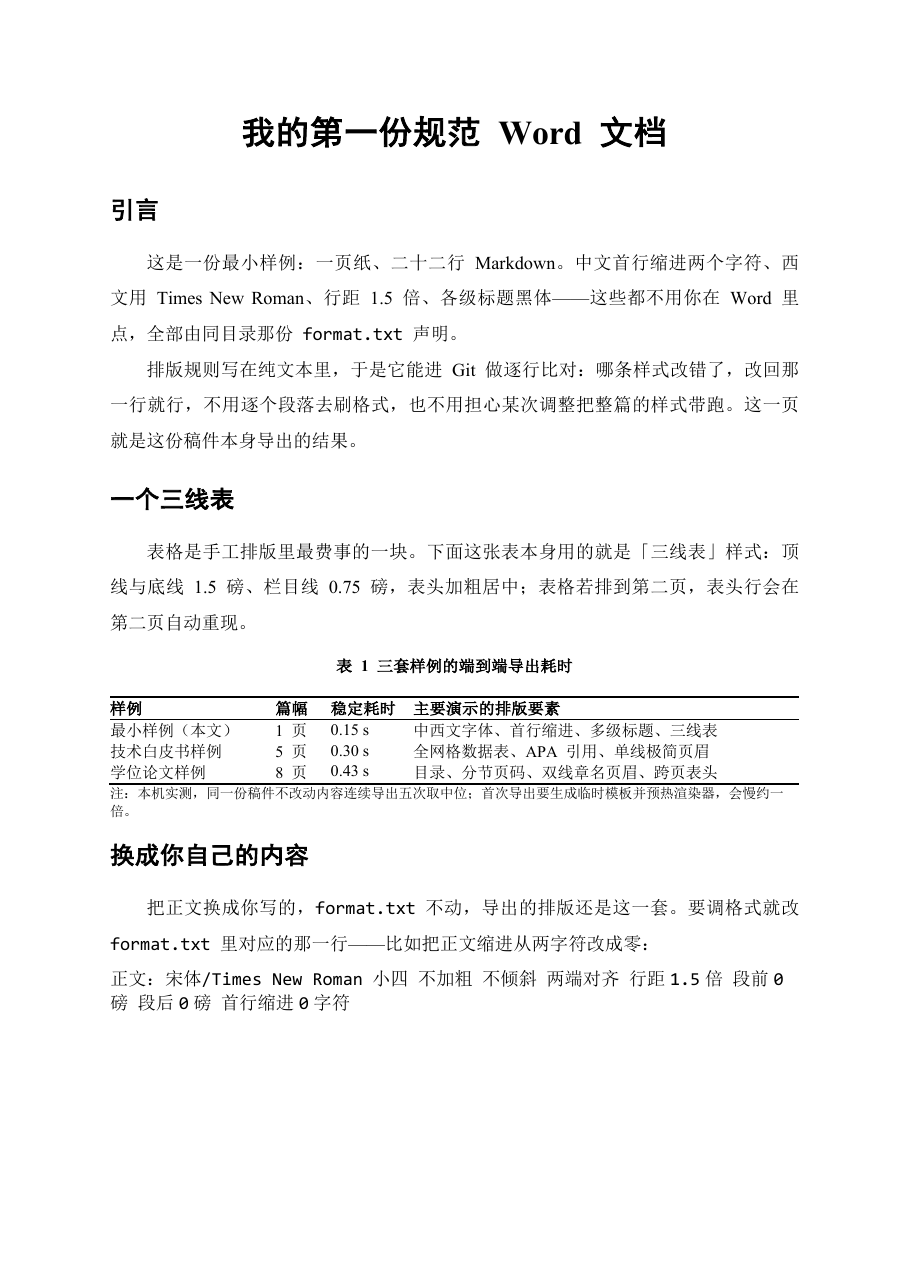
上图由 demo/00_quickstart 导出:
中文首行缩进两字符、西文 Times New Roman、三线表带表题表注——没有一步是在 Word 里点的。
安装
pip install md-to-word-docx
包名比命令多一个 -docx 后缀:PyPI 上 md-to-word 与既有项目过于相似,被命名规则挡住;命令仍是
md-to-word。隔离环境用 pipx install md-to-word-docx,更新用 pip install -U md-to-word-docx。
第一次用先过一遍 md-to-word --guide:流程、门禁判据、能力边界都在里面。它就是仓库根
SKILL.md 的正文——用技能的人读 SKILL.md,只装包的人读这份,内容相同,只是入口不同。
30 秒
先跑一条命令:md-to-word init 在当前目录放好 format.txt 与 hello.md,hello.md 能直接导出——
先看到成品,再改内容与格式。
md-to-word init
md-to-word hello.md -o hello.docx
写稿件——正文是普通 Markdown,只有三处约定:以 %% 开头的行指定这一段的样式,$$…$$ {#eq-x}
是带编号的公式,{{< toc >}} 这类标记单独成行。
%% 文档标题 我的第一份规范 Word 文档

# 引言

这是一份最小样例:中文首行缩进两个字符、西文用 Times New Roman、行距 1.5 倍,
这些都不用你在 Word 里点。

%% 表题 **表 1** 三套样例的端到端导出耗时

| 样例 | 篇幅 | 稳定耗时 |
|:------|:--|:---|
| 最小样例(本文) | 1 页 | 0.15 s |
| 学位论文样例 | 8 页 | 0.43 s |
声明格式——一行一种样式,字段写全就生效(节选:完整的一份还会声明各级标题、脚注、参考文献与页码):
纸张:A4
页边距:上2.54cm 下2.54cm 左2.54cm 右2.54cm
西文字体:Times New Roman

正文:宋体/Times New Roman 小四 不加粗 不倾斜 两端对齐 行距1.5倍 段前0磅 段后0磅 首行缩进2字符
表格:居中 三线表 线宽上1.5磅 线宽底1.5磅 线宽表头下0.75磅 单元格垂直居中
表头:宋体/Times New Roman 五号 加粗 不倾斜 居中 行距1.0倍 段前0磅 段后0磅 首行缩进0字符 跨页重复
导出:
md-to-word 稿件.md -r format.txt -o 稿件.docx
约 0.2 秒。不传 -r 时用内置预设,按稿件语种选:中文走 zh-academic,其他语言走 en-nature。
样例
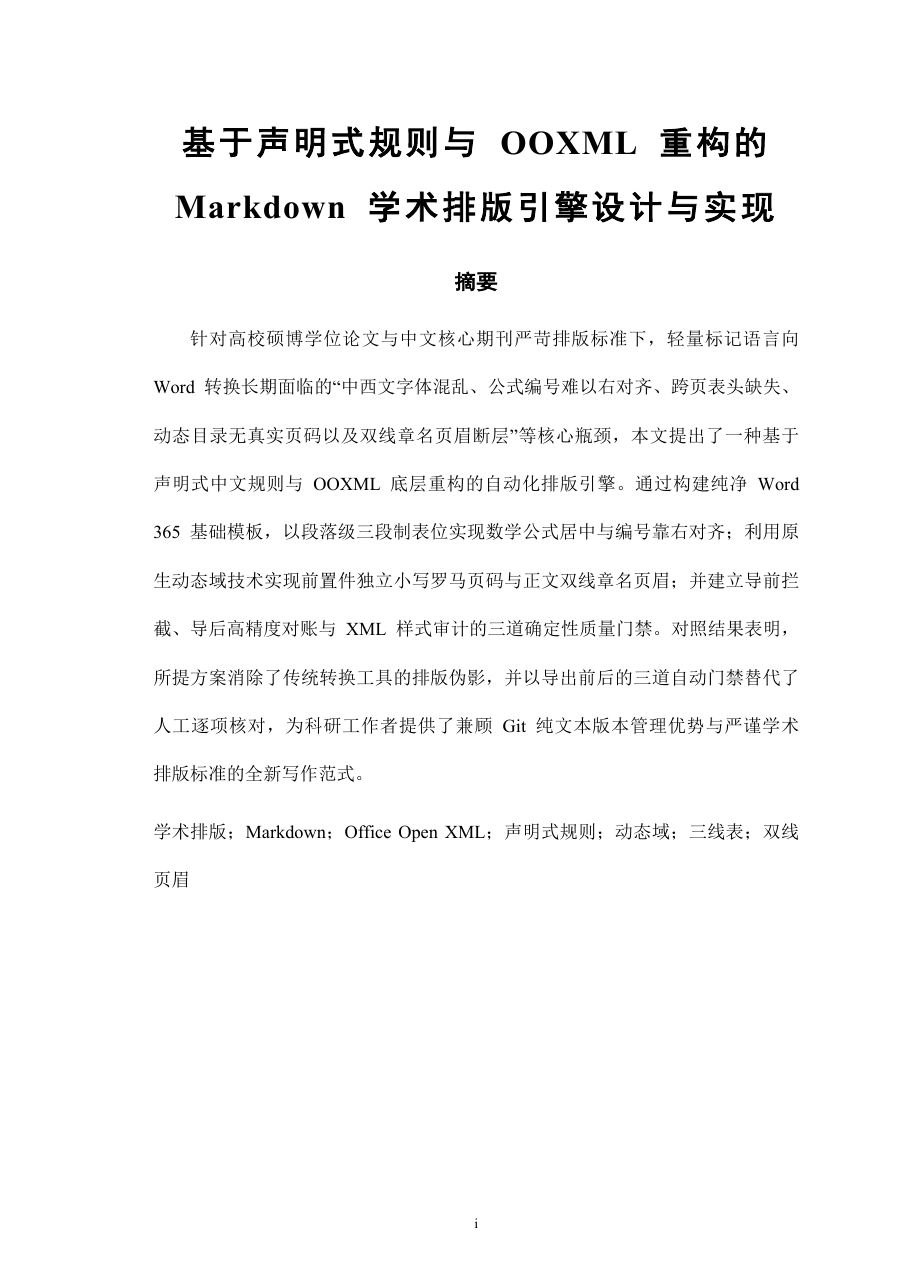
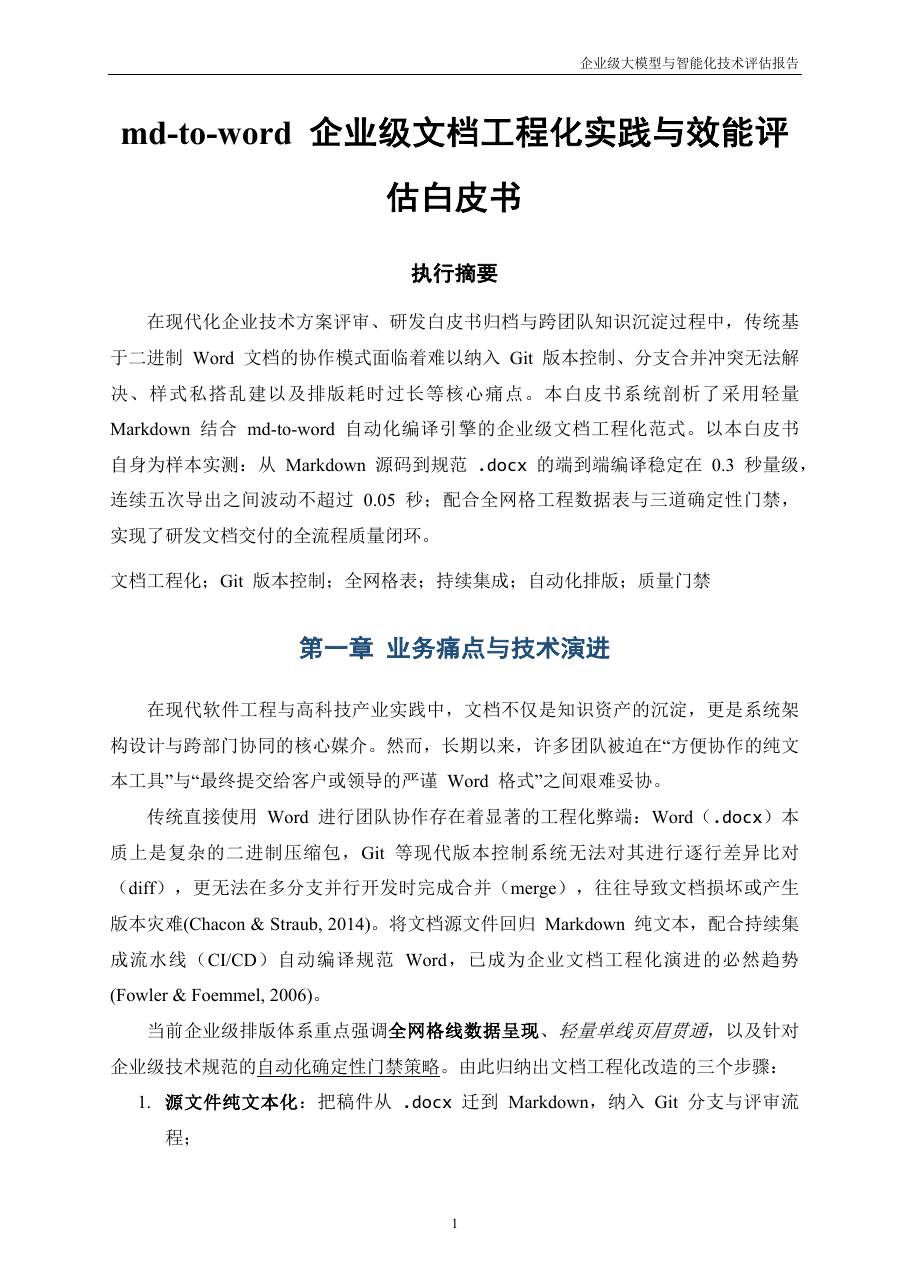
四份样例都真导出、真在 Word 里开过;下面的页图直接由导出的 PDF 生成,不是效果图。
 |
 |
|---|---|
| 最小样例 · 一页纸,从稿件到成品的最短路径 | 中文学位论文 · 目录域、分节页码、按章编号、双线章名页眉 |
 |
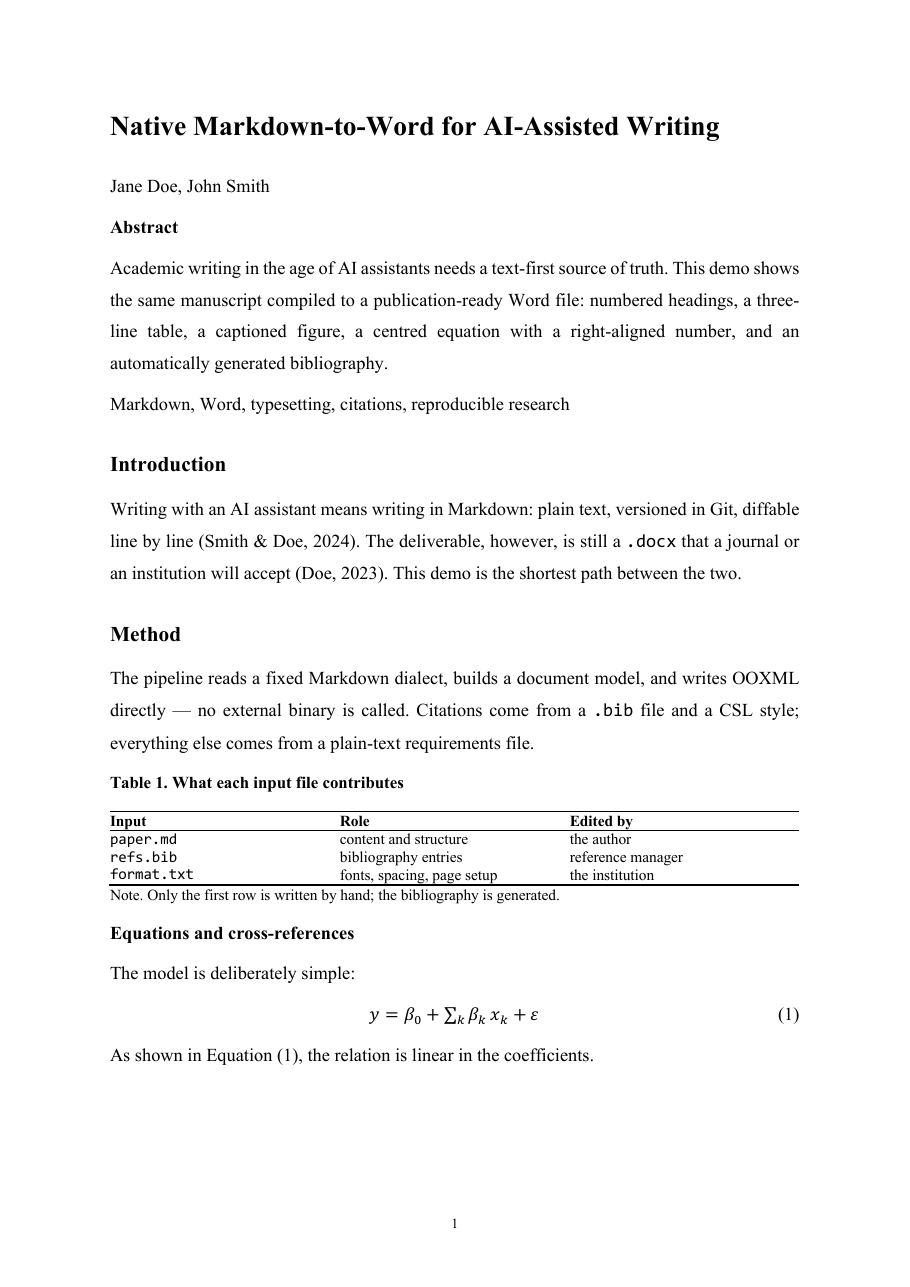 |
| 技术白皮书 · 全网格表、引用块、彩色一级标题 | 英文期刊投稿 · APA 作者-年份制、Equation 1 交叉引用 |
能做什么
- 页面与正文:纸张、页边距、装订线、文档网格、中西文字体、字号、行距、缩进、段距、对齐、颜色
- 标题与页眉页脚:六级标题、奇偶页与首页不同、分节、页码格式与起始、
{页码}{总页数}{样式标题}域 - 表格:三线表、全网格线、顶底线、无边框,线宽、跨页重复表头、单元格对齐与内边距、列宽比例
- 公式:原生 OMML,居中、编号靠右,按章编号,编号外观可声明,
@eq-交叉引用 - 图与题注:图片宽度按版心钳制,题注与图同页绑定,图题在上一律由作者决定
- 文献:
.bib+ CSL,内置 29 份常用样式(GB/T 7714、APA、Nature、IEEE、Vancouver 等),也可指向自己的 CSL 文件 - 行内:加粗、斜体、删除线、下划线、上下标、行内代码、行内公式、链接、脚注
- 列表:有序、无序、三级嵌套、引用块内的列表
- 质量门禁:导前预检(契约、样式、引文)、导后防丢数、逐条样式对账
- 无外部程序:不调用 Pandoc、Quarto 或 Word,导出不依赖任何外部二进制
做不到什么、为什么,以及完整词表见使用手册——
md-to-word --contract 会打印它的路径(中英各一份);实现取舍见
design.md。
常用写法
| 你要写的 | 写成 |
|---|---|
| 章节标题 | # 引言、## 2.1 方法;一个 # 一级,不跳级 |
| 给某一段指定样式 | 行首写 %% 摘要 本文提出……(一行即一段,无闭合符号) |
| 带编号的公式 | $$E=mc^2$$ {#eq-mass},正文用 @eq-mass 引用 |
| 参考文献 | YAML 里 bibliography: refs.bib,正文写 [@smith2024] |
| 图 | {width=13cm},下一行 %% 图片题注 图 1 系统架构 |
| 表 | 表上方 %% 表题 **表 1** ……,表下 %% 表注 注:…… |
| 目录 | 单独一行 {{< toc >}} |
| 分节、换页码 | 单独一行 {{< section page_number=lowerRoman start=1 >}} |
| 分页 | 单独一行 {{< pagebreak >}} |
与其他方案的区别
| Pandoc / Quarto | 常见的 Markdown→Word 库 | 这里 | |
|---|---|---|---|
| 排版规则写在哪 | 命令行参数 + Word 底模,改细节要动 XML | 代码里,或只有几档预设 | 一份 format.txt,随稿件进 Git |
| 公式编号靠右 | 需额外后处理 | 一般不做 | 默认;按章编号可声明 |
| 分节页码、章名页眉 | 要手工改底模并插域 | 不支持 | 一行标记 + 一行要求 |
| 出错时 | 多为静默走样 | 抛异常或静默 | 导前预检带行号,导后逐条对账 |
各家默认就能做到的(中西文字体分离、三线表、跨页表头、参考文献排版),这里同样支持; 上表只列拉开差距的项。
另外两个入口
当作 Python 库——需要接进自己的流程时:
from md_to_word import export

result = export("稿件.md", "稿件.docx")
if not result.ok:
    raise SystemExit("\n".join(result.errors))
当作 Agent 技能——把活交给 AI 时,克隆本仓库,让 Agent 读根目录的 SKILL.md,
它依次完成:整理稿件 → 写 format.txt → 导出 → 读门禁、按行号改稿。
给脚本与 Agent——加 --json,结果是一行 JSON,消息走 stderr:
md-to-word 稿件.md -o 稿件.docx --json
键名固定(ok、returncode、output、pdf、messages、errors),不随版本变;
里面的句子跟着稿件语种走。读键,不读措辞。
环境
- 依赖:
python-docx、lxml、PyYAML、latex2mathml、citeproc-py五个包;除lxml(C 扩展,各平台都有现成轮子)外都是纯 Python - 导出不需要任何外部二进制:没有 Pandoc,没有 Quarto,不调用 Word
--pdf核对版才用到本机 Word(仅 macOS;不可用时自动跳过,不影响.docx)- 中英双语:运行时消息、门禁报错、使用手册各有两份,语言跟着稿件语种走—— 英文稿拿到英文报错与英文样式名举例,中文稿一字不变
手上有现成的模板?
学校、期刊或单位下发的 .docx 不必逐条抄成要求文件。用包内的读取器反推一份草稿:
md-to-word-template 学校模板.docx -o 论文_format.txt
读出页面尺寸、页边距、页眉页脚距边界、页码格式与起始、各样式的中西文字体与字号、加粗倾斜、 对齐、行距(区分倍数/固定值/最小值)、段前段后、缩进(含字符单位)、段落下边框、表格边框与 表头行、页眉页脚内容与域。读不出的项列成待确认清单,不假装读到了。
推荐上游生态
本项目专注下游的确定性排版与格式交付,写稿、找文献的部分推荐配合这两个学术 Agent 框架使用:
- Academic Research Skills:五阶段学术研究与写作
全流程框架。Stage 5(FINALIZE)产出 Markdown 草稿与参考文献后,可直接接到本工具出规范
.docx。 - Nature Skills:学术论文写作的 Agent 技能集,覆盖文献综述、 实验论证与草稿生成。
(本项目目前被 Academic Research Skills 列在第三方项目清单中。)
许可
代码为 MIT。内置引文样式来自 citation-style-language/styles,按 CC BY-SA 3.0 使用; 内置底模由本项目生成,随 MIT 发布。
1 maintainer

Metadata
1 maintainer
Release files for md-to-word-docx 2.2.1
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | Provenance | |
|---|---|---|---|---|
| md_to_word_docx-2.2.1.tar.gz | 299.2 kB | Without provenance | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| md_to_word_docx-2.2.1-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 643.5 kB
Release files / md_to_word_docx-2.2.1.tar.gz
| Download URL | md_to_word_docx-2.2.1.tar.gz |
|---|---|
| Size | 299.2 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
16211ee141a85e9d7016f242297f9026e5e0b6a1b1b89463fdb5332ae82f6242
|
|
BLAKE2b-256 checksum How to use checksums |
c0d842d5158e53b4dc6d472b730160da46f53b77bd1a64a121489dea113d6ab0
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.11.0
|
Release files / md_to_word_docx-2.2.1-py3-none-any.whl
| Download URL | md_to_word_docx-2.2.1-py3-none-any.whl |
|---|---|
| Size | 344.3 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
ac1cb4ba7fb14a45eeaf4143e6e2df1856fc7aad2a31293efe7c3a0d21770470
|
|
BLAKE2b-256 checksum How to use checksums |
31928ca7b085145f59d8888e78a589e59bc0a1a7ce3dc3e12c90640e8664033f
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.11.0
|
Security for md-to-word-docx 2.2.1
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
No provenance found
None of the files in this release were uploaded with provenance metadata.
A note on package security
PyPI is a repository for distributing packages, not a service for auditing them. While third-party security researchers and our staff do their best to detect and remove malicious packages, PyPI cannot guarantee the quality, security or suitability of any given package.














