


Модель поменяли — стало ли лучше, где и почему? ranklens отвечает на это из таблиц pandas одной строкой: разница с интервалом, p- и q-value, минимальный заметный эффект (MDE), разбивка по сегментам с поправкой на множественные сравнения. Метрики совпадают с trec_eval до 1e-9.
import ranklens as rl

rl.compare(current, new, qrels, ["ndcg@10"], by="device")
Типичные задачи
Примеры — на синтетическом каталоге из docs/examples/catalog.py: запросы, товары
и оценки выдуманы, но устроены как в настоящем поиске. На
главной странице документации они
выполняются при каждой сборке.
    query                            product  grade history  base_s0  new_s0
0  молоко            Молоко Луговое 3,2% 1 л      3     нет     0.92    1.08
1  молоко  Молоко Северная ферма 2,5% 930 мл      2     нет     0.97    1.04
Эффект виден только в сегменте. Новая модель знает, покупал ли пользователь товар раньше, — такой признак есть только у пользователей с историей покупок (около 9% запросов). У каждой модели два сида: они усредняются по запросу.
rl.compare([base_s0, base_s1], [new_s0, new_s1], qrels, ["ndcg@10"], by="history")
                 n_queries   delta  ci_low  ci_high     mde  q_value
metric  history
ndcg@10 есть            29  0.0387  0.0190   0.0616  0.0308   0.0006
        нет            291 -0.0010 -0.0034   0.0015  0.0035   0.4194
В среднем по всем запросам прирост +0.0026 не отличим от нуля и меньше MDE (0.0046) — минимального эффекта, который эти запросы способны показать. Разбивка находит, где он.
Две версии выдачи размечены разными партиями асессоров.
rl.agreement(batch_cur, batch_new)
# Agreement(2495 common pairs: exact 88.8%, mean grade A 1.801, B 1.913, shift +0.112)
qrels = rl.merge_qrels(batch_cur, batch_new)  # одна разметка для обеих сторон
rl.compare(current, new_version, qrels, ["ndcg@5", "ndcg@10", "err@10"])
         n_queries   delta  ci_low  ci_high     mde  q_value
metric
ndcg@5         320 -0.0019 -0.0039   0.0000  0.0028   0.0801
ndcg@10        320  0.0629  0.0559   0.0699  0.0099   0.0003
err@10         320  0.0019 -0.0016   0.0054  0.0051   0.2966
Вторая партия мягче, поэтому сравниваем на общей разметке. NDCG@10 значимо выше, а метрики верха выдачи — нет: новая версия улучшает позиции 6–10.
Почему: вклад признаков в метрику. Модель — CatBoost, LightGBM, XGBoost, scikit-learn, PyTorch, ONNX или любая функция скоринга.
ex = rl.explainer(model, df, query="query", doc="product", relevance="grade")
ex.importance("ndcg@10")  # насколько падает метрика, если перемешать признак
ex.worst(20)  # худшие запросы и признаки, которые их подвели
               drop of ndcg@10
feature
text_match              0.1548
bought_before           0.0066
popularity              0.0046
price_rank              0.0006
Установка
pip install "ranklens[viz]"
Extras: viz (графики и HTML-отчёты), arrow (parquet, Feather), models (CatBoost,
LightGBM, XGBoost, scikit-learn), neural (ONNX). PyTorch ставится по инструкции
pytorch.org. Свежий main — pip install "ranklens @ git+https://github.com/AlexandrBaranov7/ranklens".
Данные и командная строка
rl.run и rl.qrels берут таблицу pandas, polars или pyarrow с одной строкой на пару
«запрос — документ»; порядок — по скору модели (score=), по позиции (rank=) или
порядку строк. Несколько выдач на запрос (по магазинам, сессиям) — list_id=.
qrels = rl.qrels(labels, query="qid", doc="sku", relevance="grade")
current = rl.run(df_a, query="qid", doc="sku", rank="pos", segments="device")
new = rl.run(df_b, query="qid", doc="sku", rank="pos", segments="device")
Те же сравнения из терминала — для файлов и CI:
ranklens eval --run run.trec --qrels qrels.trec --metrics ndcg@10 mrr@10
ranklens compare --baseline a.csv --candidate b.csv --qrels qrels.csv \
    --metrics ndcg@10 mrr@10 --segments device locale --report compare.html
ranklens explain --model model.cbm --features features.csv --top-worst 20
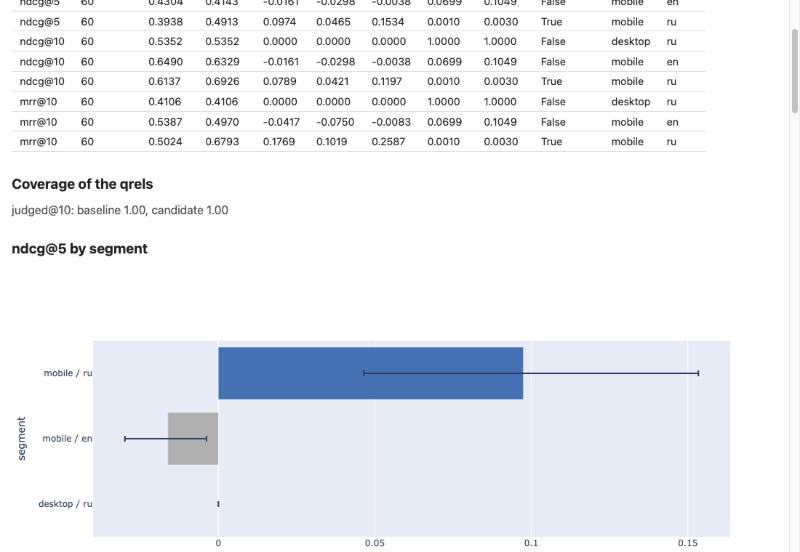
metric   device   locale  queries  mean A  mean B  delta    95% CI              p       q
ndcg@10  desktop  ru      60       0.5352  0.5352  +0.0000  [+0.0000, +0.0000]  1.0000  1.0000
ndcg@10  mobile   en      60       0.6490  0.6329  -0.0161  [-0.0302, -0.0038]  0.0655  0.0982
ndcg@10  mobile   ru      60       0.6137  0.6926  +0.0789  [+0.0409, +0.1234]  0.0005  0.0015  *
--report compare.html пишет один файл со всеми графиками, который открывается без
интернета: таблица, покрытие разметкой, разница по сегментам с интервалами (значимые
после поправки — синим), распределение поразапросных разниц, метрика по cutoff,
перемещения документов из топ-10.
Подробнее — «Первые шаги».
| Что | Где |
|---|---|
| Таблицы pandas/polars → сравнение одной строкой: сиды, сегменты, MDE, покрытие разметки | import ranklens as rl |
| NDCG, MAP, MRR (умолчания trec_eval), ERR, RBP, RBO, judged@k; свои метрики — плагином | ranklens.metrics |
| Парный bootstrap по запросам, перестановочный тест, Бенджамини — Хохберг, MDE | ranklens.stats |
| Сравнение по сегментам с q-values | ranklens.aggregate |
| Неточная разметка: согласие партий, общая разметка, PPI++ (дешёвая proxy-разметка + gold-выборка), judged@k | rl.agreement, rl.merge_qrels, ranklens.stats |
| Off-policy: IPS и SNIPS по логам кликов, PBM, симулятор с известной истиной, ESS | ranklens.offpolicy |
| Объяснение: Шепли для пары документов, вклад признаков в метрику, группы коррелированных признаков, худшие запросы | rl.explainer, ranklens.explain |
| Графики и самодостаточные HTML/Markdown-отчёты | ranklens.viz, ranklens.report |
Почему не существующие библиотеки
- pytrec_eval — обёртка над trec_eval: быстрый эталон метрик, десятки мер. ranklens сверяется с ним golden-тестами и проигрывает ему в числе мер. Но pytrec_eval отвечает на «сколько», а не на «отличимо ли это от шума» — сравнения, интервалов и сегментов в нём нет.
- ir_measures — единый интерфейс к нескольким реализациям мер; хорош, когда нужна именно мера из конкретного инструмента. Статистику сравнения и объяснения он не делает.
- ranx умеет и метрики, и статистическое сравнение прогонов, и fusion — ближайший аналог в части сравнения. ranklens добавляет то, чего в нём нет: поправку FDR по сегментам, MDE, PPI для неточной разметки, off-policy оценку по кликам и объяснение модели по метрике.
ranklens не заменяет их в скорости и полноте набора мер — он закрывает путь от «цифра изменилась» до «вот где и почему».
Архитектура
Слои с проверяемыми границами: core (типы, результаты, протоколы, исключения — только
stdlib) → io, metrics, stats, viz → aggregate, offpolicy, explain, report
→ api (import ranklens as rl) и cli. tests/test_architecture.py разбирает AST каждого модуля и падает, если слой
импортирует то, что ему не положено, или тяжёлую библиотеку не лениво. Прогоны читаются
потоком (генератор, в памяти — одна выдача), разметка — в словарь для поиска за O(1).
Подробно — «Устройство».
Выбор структур данных и средств языка
| Требование | Где | Почему так |
|---|---|---|
list |
буфер строк текущего запроса в iter_run, iter_clicklog |
дописывание в конец — амортизированное O(1); собранная выдача сразу становится tuple |
tuple |
RankedList.docs, SegmentKey, Impression.positions, вклады признаков |
порядок — это позиция; неизменяем и хешируем: поле frozen-объекта и ключ словаря. list в frozen dataclass менялся бы на месте |
dict |
Qrels: dict[QueryId, dict[DocId, float]], реестр метрик, ADAPTERS |
поиск оценки пары запрос–документ за O(1) в горячем цикле; реестры вместо цепочек if — точки расширения |
set |
дубликаты документов в RankedList, общие запросы двух прогонов, повторы в ридерах |
проверка дубликатов O(n) вместо O(n²); общие запросы — ровно a.keys() & b.keys() |
| генератор | iter_run, iter_clicklog, iter_records |
в памяти — строки одного запроса: на отсортированном входе память постоянна, на сгруппированном растёт на ~200 байт на запрос (id уже прочитанных); тесты меряют пик tracemalloc на файле в 10 раз больше |
| свой итератор | PairedRuns (__iter__/__next__) |
merge-join двух отсортированных потоков; zip молча спарил бы разные запросы, когда в одном прогоне запрос пропущен |
| своё исключение | иерархия RankLensError: DataError, ConfigError, ModelError, StatisticalError |
у ошибок поля (line_no, path, column) и подсказки («did you mean 'ndcg'?»); аргументы в super().__init__ — иначе не переживают pickle (тест) |
| осмысленная обработка | ErrorCollector: битые строки пропускаются и считаются; --strict останавливает |
два сценария — разведка данных и CI-гейт; коды выхода 0 / 1 конфигурация / 2 аргументы / 3 данные |
| контекстный менеджер | AtomicReport |
временный файл в той же директории, fsync, os.replace только без исключения; при ошибке или Ctrl-C остаётся прежний отчёт. with open() сначала обнулил бы цель |
| аннотации + mypy | весь пакет и тесты, mypy strict, py.typed |
ошибки типов ловятся в CI до тестов; пакет отдаёт типы пользователям |
| pytest | 750+ тестов, покрытие ~99%, порог 90% | точные значения, property-based (Hypothesis), golden против trec_eval, статистическая валидация на симуляциях |
pyproject.toml |
PEP 621, [project.scripts], entry points ranklens.metrics, extras |
одна точка для метаданных, команды, плагинов и необязательных зависимостей |
| установка pip | задание CI install |
собранный wheel ставится обычным pip в чистое окружение, и scripts/tutorial_smoke.py проходит «Первые шаги» вне репозитория |
| pandas + агрегация | offpolicy/events.py: merge, groupby().max(), explode, value_counts; aggregate — таблица по сегментам |
склейка событий показов и реакций — табличная операция; сегменты отдаются DataFrame |
Неизменяемость результатов: frozen=True, slots=True + tuple + MappingProxyType +
read-only массивы numpy — frozen сам по себе запрещает только присваивание полей.
Почему Protocol, а не ABC
Метрика — любой вызываемый объект (ranked, judgements, k) -> float, в том числе обычная
функция; модель для объяснений — любой объект с feature_names, score,
native_importance. Это typing.Protocol: структурная типизация, реализации не
наследуются от наших классов, и чужую модель или функцию не нужно встраивать в иерархию.
С ABC каждую сторонюю модель пришлось бы оборачивать в подкласс. Имя метрики хранится
в спецификации (ndcg@10): у функции нет атрибута name, и протокол с ним её бы
не принял. Новая модель — класс-адаптер и одна строка в ADAPTERS; адаптер находится
по MRO класса модели, поэтому подкласс LGBMRanker из чужого кода тоже распознаётся.
Почему ресемплинг по запросам
Единица наблюдения — запрос. Пусть 100 запросов по 10 документов. Ресемплинг строк
считал бы, что наблюдений 1000, хотя документы одной выдачи зависимы — интервал вышел бы
примерно в √10 ≈ 3 раза уже правды. Поэтому bootstrap берёт с возвращением запросы
и усредняет поразапросные разницы M_B(q) − M_A(q); перестановочный тест меняет знак
разницы целиком у запроса. Проверено симуляцией: 95%-й интервал покрывает истинную
разницу в 95.3% из 1000 повторов. Вывод — в
«Статистике сравнения».
Ограничения
- Вход должен быть сгруппирован по запросу (строки запроса подряд), для
PairedRuns— отсортирован; иначе ошибка, а не тихая потеря запросов. Разметка грузится в память целиком. - Неразмеченный документ считается нерелевантным (как в trec_eval): прогон, который
приносит много нового, проигрывает из-за разметки.
compareпоказывает judged@k и предупреждает о разрыве; PPI++ лечит систематическую ошибку разметки при наличии случайной gold-выборки. - Перцентильный bootstrap-интервал на малых выборках бывает уже нужного; поэтому p-value — из перестановочного теста, а меньше 20 запросов — предупреждение.
- Off-policy: PBM с фиксированными propensity не описывает каскадное поведение; неверные propensity смещают IPS; документы, которых старая модель не показывала, не оцениваются никакими весами. SNIPS здесь — отношение (классический SNIPS на PBM-веса не переносится) и оценивает долю, а не клики.
- Объяснения: точки «наполовину A, наполовину B» и перемешанные признаки бывают нереалистичными; Шепли точен до 12 признаков, дальше — по выборке порядков; текстовые кросс-энкодеры и LLM-реранкеры (без матрицы признаков) не объясняются (#34, #35).
- Модели из pickle исполняют код при загрузке — только с
--allow-pickle(SECURITY.md).
Roadmap
- Doubly Robust оценщик и Regression-EM для оценки propensity по логам; каскадные click-модели.
- PPI в сравнении по сегментам и в CLI; стратифицированная gold-выборка.
- Объяснение текстовых реранкеров (#34), смещения LLM-реранкеров (#35), GPU-бэкенд метрик (#17).
Разработка
git clone https://github.com/AlexandrBaranov7/ranklens.git
cd ranklens
poetry install --all-extras   # Poetry >= 2.4
poetry run pytest
Правила — в CONTRIBUTING.md, изменения — в CHANGELOG.md.
Лицензия
MIT
1 maintainer

Metadata
1 maintainer
Release files for ranklens 0.2.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | Provenance | Actions |
|---|---|---|---|---|
| ranklens-0.2.0.tar.gz | 95.2 kB | With provenance | Details for ranklens-0.2.0.tar.gz |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Actions Reset |
|---|---|---|---|---|
| ranklens-0.2.0-py3-none-any.whl | Python 3 | none | any | Details for ranklens-0.2.0-py3-none-any.whl |
Total release size: 214.6 kB
Release files / ranklens-0.2.0.tar.gz
| Download URL | ranklens-0.2.0.tar.gz |
|---|---|
| Size | 95.2 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
c032a9cbd2717dd03469c04de53eb73741c493bdc3f094a7cf80d5c6ca0bfbbb
|
|
BLAKE2b-256 checksum How to use checksums |
3022f8136ecde257b0bb0aa5061e3e92eb507eacf46e548b359b848362bd51bf
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.16
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.


PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Nov 5, 2026.
Transparency logRelease files / ranklens-0.2.0-py3-none-any.whl
| Download URL | ranklens-0.2.0-py3-none-any.whl |
|---|---|
| Size | 119.4 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
1eb5749579b396d320e014252e93fc3e7e08274889e551c9abfddaef613038bb
|
|
BLAKE2b-256 checksum How to use checksums |
997a0a0e5714797aff2a6215b02badc0fb2597f405187bd96538152325114bc6
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.16
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Nov 5, 2026.
Transparency logSecurity for ranklens 0.2.0
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
Full provenance
Both files in this release have been uploaded with provenance metadata.
Attestation for ranklens-0.2.0.tar.gz
PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Nov 5, 2026.
Transparency logA note on package security
PyPI is a repository for distributing packages, not a service for auditing them. While third-party security researchers and our staff do their best to detect and remove malicious packages, PyPI cannot guarantee the quality, security or suitability of any given package.
To learn more about protecting yourself from malicious actors, visit our package security documentation.













