
ruTS
Russian Texts Statistics - библиотека для извлечения статистик из текстов на русском языке
Документация · PyPI · English




ruTS считает по русскому тексту то, для чего обычно приходится собирать несколько разрозненных инструментов: базовые статистики, метрики удобочитаемости и лексического разнообразия, морфологические признаки. Функционал основан на адаптированных для русского языка статистиках библиотеки textacy.
Работать можно как с обычными строками, так и с готовыми Doc-объектами spaCy - каждая статистика доступна и как отдельный класс, и как компонент пайплайна spaCy.
- Извлечение объектов - настраиваемые токенизаторы слов и предложений
- Базовые статистики - количество слов, предложений, слогов, знаков препинания и их распределения
- Метрики удобочитаемости - тест Флеша-Кинкайда, индекс SMOG, LIX и другие, с коэффициентами для русского языка
- Метрики лексического разнообразия - TTR и его вариации, MTLD, HD-D, индексы Симпсона и Юла, энтропия, законы Ципфа и Хипса
- Морфологические статистики - часть речи, падеж, наклонение, переходность и другие признаки
- SEO-метрики стиля - тошнота, водность, заспамленность, естественность по Ципфу, плотность ключевых слов
- Фоностатистики - классы звуков, кластеры, аллитерация и ассонанс, слоги по правилу восходящей звучности
- Наборы данных - готовые предобработанные корпуса с фильтрацией
- Визуализация - закон Ципфа, литературная дактилоскопия, дерево слов
- Компоненты spaCy - встраивание любой статистики в пайплайн
Установка
Требуется Python 3.11 или новее.
pip install ruts
Или с помощью uv:
uv add ruts
Для работы с компонентами spaCy понадобится русскоязычная модель:
python -m spacy download ru_core_news_sm
Быстрый старт
>>> from ruts import BasicStats, DiversityStats, ReadabilityStats

>>> text = "Существуют три вида лжи: ложь, наглая ложь и статистика"

>>> BasicStats(text).get_stats()
{'c_letters': {1: 1, 3: 2, 4: 3, 6: 1, 10: 2},
 'c_syllables': {1: 5, 2: 1, 3: 1, 4: 2},
 'n_sents': 1,
 'n_words': 9,
 'n_unique_words': 8,
 'n_long_words': 3,
 'n_complex_words': 2,
 'n_simple_words': 7,
 'n_monosyllable_words': 5,
 'n_polysyllable_words': 4,
 'n_chars': 55,
 'n_letters': 45,
 'n_spaces': 8,
 'n_syllables': 18,
 'n_punctuations': 2}

>>> ReadabilityStats(text).flesch_reading_easy
74.93500000000003

>>> DiversityStats(text).ttr
0.8888888888888888
Возможности
Извлечение объектов
Библиотека позволяет создавать свои инструменты для извлечения предложений и слов из текста, которые затем можно использовать при вычислении статистик.
>>> import re
>>> from nltk.corpus import stopwords
>>> from ruts import SentsExtractor, WordsExtractor

>>> text = "Не имей 100 рублей, а имей 100 друзей"

>>> se = SentsExtractor(tokenizer=re.compile(r', '))
>>> se.extract(text)
('Не имей 100 рублей', 'а имей 100 друзей')

>>> we = WordsExtractor(use_lexemes=True, stopwords=stopwords.words('russian'), filter_nums=True, ngram_range=(1, 2))
>>> we.extract(text)
('иметь', 'рубль', 'иметь', 'друг', 'иметь_рубль', 'рубль_иметь', 'иметь_друг')

>>> we.get_most_common(3)
[('иметь', 2), ('рубль', 1), ('друг', 1)]
Подробнее - в документации: слова, предложения.
Базовые статистики
Библиотека позволяет извлекать из текста следующие статистические показатели:
- количество предложений
- количество слов
- количество уникальных слов
- количество длинных слов
- количество сложных слов
- количество простых слов
- количество односложных слов
- количество многосложных слов
- количество символов
- количество букв
- количество пробелов
- количество слогов
- количество знаков препинания
- распределение слов по количеству букв
- распределение слов по количеству слогов
Любую статистику можно вывести на экран в читаемом виде:
>>> from ruts import BasicStats

>>> text = "Существуют три вида лжи: ложь, наглая ложь и статистика"
>>> BasicStats(text).print_stats()
     Статистика     | Значение
------------------------------
Предложения         |    1
Слова               |    9
Уникальные слова    |    8
Длинные слова       |    3
Сложные слова       |    2
Простые слова       |    7
Односложные слова   |    5
Многосложные слова  |    4
Символы             |    55
Буквы               |    45
Пробелы             |    8
Слоги               |    18
Знаки препинания    |    2
Подробнее - в документации.
Метрики удобочитаемости
Библиотека позволяет вычислять для текста следующие метрики удобочитаемости:
- Тест Флеша-Кинкайда
- Индекс удобочитаемости Флеша
- Индекс Колман-Лиау
- Индекс SMOG
- Автоматический индекс удобочитаемости
- Индекс удобочитаемости LIX
- Индекс удобочитаемости RIX
- Формула Соловьёва, Иванова, Солнышкиной
- Формула Мацковского
- Индекс Дейла-Чейла
- Индекс Ганнинга
Поверх формул работает интерпретирующий слой: сводный класс по медиане формул класса, соответствие класса возрасту читателя по таблице plainrussian и время чтения.
Коэффициенты формул, адаптированных для русского языка, задаются пресетом preset: по умолчанию используются коэффициенты проекта Plain Russian Language, полученные на текстах с метками класса (plainrussian), доступны также коэффициенты Оборневой для художественных текстов (fiction) и казанской группы (Соловьёв, Иванов, Солнышкина) для учебных (academic).
>>> from pprint import pprint
>>> from ruts import ReadabilityStats

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"
>>> rs = ReadabilityStats(text)

>>> pprint(rs.get_stats())
{'automated_readability_index': 0.2941666666666656,
 'coleman_liau_index': 1.1700000000000053,
 'consensus_grade': 1.5,
 'dale_chall_index': 4.095000000000001,
 'flesch_kincaid_grade': -2.0633333333333326,
 'flesch_reading_easy': 87.16833333333334,
 'gunning_fog_index': 6.0,
 'lix': 28.333333333333336,
 'matskovsky_index': 9.351,
 'reading_time': 0.08333333333333333,
 'rix': 2.0,
 'sis_grade': 1.5166666666666675,
 'smog_index': 0.05}

>>> rs.print_stats()
                   Метрика                   | Значение
-------------------------------------------------------
Тест Флеша-Кинкайда                          |  -2.06
Индекс удобочитаемости Флеша                 |  87.17
Индекс Колман-Лиау                           |   1.17
Индекс SMOG                                  |   0.05
Автоматический индекс удобочитаемости        |   0.29
Индекс удобочитаемости LIX                   |  28.33
Индекс удобочитаемости RIX                   |   2.00
Формула Соловьёва, Иванова, Солнышкиной      |   1.52
Формула Мацковского                          |   9.35
Индекс Дейла-Чейла                           |   4.10
Индекс Ганнинга                              |   6.00
Сводный класс                                |   1.50
Время чтения (мин.)                          |   0.08

>>> rs.describe_grade()
'1-3-й класс (6-8 лет)'
Подробнее - в документации.
Метрики лексического разнообразия
Библиотека позволяет вычислять для текста следующие метрики лексического разнообразия:
- Type-Token Ratio (TTR)
- Root Type-Token Ratio (RTTR)
- Corrected Type-Token Ratio (CTTR)
- Herdan Type-Token Ratio (HTTR)
- Summer Type-Token Ratio (STTR)
- Maas Type-Token Ratio (MTTR)
- Dugast Type-Token Ratio (DTTR)
- Moving Average Type-Token Ratio (MATTR)
- Mean Segmental Type-Token Ratio (MSTTR)
- Measure of Textual Lexical Diversity (MTLD)
- Moving Average Measure of Textual Lexical Diversity (MA-MTLD)
- MTLD со скользящим окном и заворотом текста (MTLD-W)
- Hypergeometric Distribution D (HD-D)
- Индекс Симпсона (D), обратный индекс Симпсона (1/D) и индекс Джини-Симпсона (1-D)
- Гапакс-индекс (Honoré's R), доля гапаксов, меры Баайена (P) и показатель α₂
- Характеристики Юла (K и I), меры Хердана (Vm), Сишела (S), Мишеа (M), Брюне (W) и Дюга (k)
- Энтропия Шеннона, выравненность и перплексия
- Наклон закона Ципфа (α) и показатель закона Хипса (β)
Окна, пороги и основание логарифма вынесены в параметры DiversityStats, любую метрику можно посчитать по окнам с доверительным интервалом методом windowed. Часть реализаций метрик взята из проекта lexical_diversity, формулы мер по спектру частот сверены с Tweedie и Baayen (1998), zipfR и quanteda.
>>> from pprint import pprint
>>> from ruts import DiversityStats

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"

>>> pprint(DiversityStats(text).get_stats())
{'alpha2': 0.5,
 'baayen_p': 0.5333333333333333,
 'brunet_w': 6.00637847898991,
 'cttr': 2.008316044185609,
 'dttr': 10.268784661968118,
 'dugast_k': 14.783895126869226,
 'entropy': 3.3232314287976203,
 'evenness': 0.9606293157795304,
 'gini_simpson_index': 0.9523809523809523,
 'hapax_index': 992.9517404041437,
 'hapax_ratio': 0.7272727272727273,
 'hdd': nan,
 'heaps_beta': 0.8366147342060046,
 'herdan_vm': 0.1421338109037403,
 'httr': 0.8854692840710255,
 'inverse_simpson_index': 21.0,
 'mamtld': 12.0,
 'mattr': 0.7333333333333333,
 'michea_m': 5.5,
 'msttr': 0.7333333333333333,
 'mtld': 15.0,
 'mtldw': 13.25,
 'mttr': 0.09738250756232528,
 'perplexity': 10.009038104159247,
 'rttr': 2.840187787218772,
 'sichel_s': 0.18181818181818182,
 'simpson_index': 0.047619047619047616,
 'sttr': 0.2500605793160848,
 'ttr': 0.7333333333333333,
 'yule_i': 8.642857142857142,
 'yule_k': 444.44444444444446,
 'zipf_alpha': 0.4884512334695912}

>>> DiversityStats(text).windowed("ttr", window_len=5)
WindowStats(mean=0.9333333333333332, std=0.11547005383792512, lower=0.6464898180167025, upper=1.220176848649964, n_windows=3)
Подробнее - в документации.
Морфологические статистики
Библиотека позволяет извлекать из текста следующие морфологические признаки:
- часть речи
- одушевленность
- вид
- падеж
- род
- совместность
- наклонение
- число
- лицо
- время
- переходность
- залог
Для морфологического разбора текста используется библиотека pymorphy3. Описание статистик взяты из корпуса OpenCorpora.
>>> from pprint import pprint
>>> from ruts import MorphStats

>>> text = "Постарайтесь получить то, что любите, иначе придется полюбить то, что получили"
>>> ms = MorphStats(text)

>>> ms.pos
('VERB', 'INFN', 'CONJ', 'CONJ', 'VERB', 'ADVB', 'VERB', 'INFN', 'CONJ', 'CONJ', 'VERB')

>>> pprint(ms.get_stats())
{'animacy': {None: 11},
 'aspect': {None: 5, 'impf': 1, 'perf': 5},
 'case': {None: 11},
 'gender': {None: 11},
 'involvement': {None: 10, 'excl': 1},
 'mood': {None: 7, 'impr': 1, 'indc': 3},
 'number': {None: 7, 'plur': 3, 'sing': 1},
 'person': {None: 9, '2per': 1, '3per': 1},
 'pos': {'ADVB': 1, 'CONJ': 4, 'INFN': 2, 'VERB': 4},
 'tense': {None: 8, 'futr': 1, 'past': 1, 'pres': 1},
 'transitivity': {None: 5, 'intr': 2, 'tran': 4},
 'voice': {None: 11}}

>>> ms.print_stats('pos', 'tense')
---------------Часть речи---------------
Глагол (личная форма)         |    4
Союз                          |    4
Глагол (инфинитив)            |    2
Наречие                       |    1

-----------------Время------------------
Неизвестно                    |    8
Настоящее                     |    1
Будущее                       |    1
Прошедшее                     |    1
Отдельные слова можно разобрать с расшифровкой признаков через ms.explain_text(filter_none=True).
Подробнее - в документации.
SEO-метрики стиля
Библиотека повторяет показатели сервисов Advego и Text.ru:
- Классическая и академическая тошнота
- Водность
- Заспамленность
- Естественность по закону Ципфа
- Плотность ключевых слов и фраз
Точные формулы сервисов не опубликованы, поэтому реализованы общепринятые определения; стоп-слова для водности определяются по части речи с помощью pymorphy3 или задаются списком.
>>> from pprint import pprint
>>> from ruts import StyleStats

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"
>>> ss = StyleStats(text)

>>> pprint(ss.get_stats())
{'academic_nausea': 93.33333333333333,
 'classic_nausea': 1.7320508075688772,
 'spam': 26.666666666666668,
 'water': 46.666666666666664,
 'zipf_naturalness': 33.333333333333336}

>>> ss.keyword_density("когда", "нет а")
{'когда': 20.0, 'нет а': 13.333333333333334}
Подробнее - в документации.
Фоностатистики
Библиотека считает по буквам, без учета оглушения и ударения:
- Доли гласных, сонорных, звонких и глухих согласных, отношение согласных к гласным
- Консонантные кластеры и зияния гласных
- Энтропию CV-шаблонов слов и «жёсткость»
- Индексы аллитерации и ассонанса относительно ожидаемых повторов
- Слоги по правилу восходящей звучности: доля открытых слогов, средняя длина слога, CV-шаблоны
>>> from pprint import pprint
>>> from ruts import PhonStats
>>> from ruts.phon_stats import syllabify

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"
>>> ps = PhonStats(text)

>>> pprint(ps.get_stats())
{'alliteration': 0.9149440867502556,
 'assonance': 0.802520508857449,
 'consonant_vowel_ratio': 1.48,
 'cv_entropy': 3.1395722619867223,
 'hardness': 0.5625,
 'mean_syllable_len': 2.6,
 'p_heavy_clusters': 0.034482758620689655,
 'p_hiatus': 0.0,
 'p_open_syllables': 0.76,
 'p_sonorants': 0.11290322580645161,
 'p_voiced': 0.1935483870967742,
 'p_voiceless': 0.2903225806451613,
 'p_vowels': 0.4032258064516129}

>>> syllabify("здравствуйте")
['здра', 'вствуй', 'те']
Подробнее - в документации.
Наборы данных
Библиотека позволяет работать с несколькими заранее предобработанными наборами данных:
- sov_chrest_lit - советские хрестоматии по литературе
- stalin_works - полное собрание сочинений И.В. Сталина
- texts_by_grade - тексты с метками класса проекта Plain Russian Language (CC0), на которых проверяются формулы удобочитаемости
Существует возможность работать как с чистыми текстами (без заголовочной информации), так и с записями, а также фильтровать их по различным критериям.
>>> from pprint import pprint
>>> from ruts.datasets import SovChLit

>>> sc = SovChLit()
>>> sc.info
{'Наименование': 'sov_chrest_lit',
 'url': 'https://dataverse.harvard.edu/file.xhtml?fileId=3670902&version=DRAFT',
 'description': 'Корпус советских хрестоматий по литературе',
 'author': 'Шкарин С.С.'}

>>> for record in sc.get_records(max_len=100, category='Весна', limit=1):
...     pprint(record)
{'author': 'Е. Трутнева',
 'book': 'Родная речь. Книга для чтения в I классе начальной школы',
 'category': 'Весна',
 'file': PosixPath('.../ruts_data/texts/sov_chrest_lit/grade_1/155'),
 'grade': 1,
 'subject': 'Дождик',
 'text': 'Дождик, дождик, поливай, будет хлеба каравай!\n'
         'Дождик, дождик, припусти, дай гороху подрасти!',
 'type': 'Стихотворение',
 'year': 1963}
Набор данных скачивается методом download() и кэшируется локально, повторный вызов ничего не качает; до загрузки get_texts() и get_records() поднимают OSError с подсказкой.
Визуализация
Библиотека позволяет визуализировать тексты с помощью следующих видов графиков:
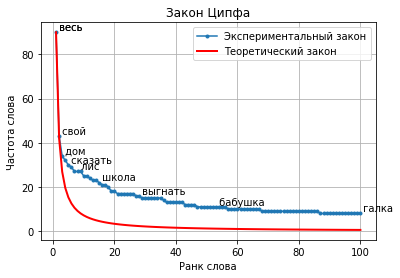
- Закон Ципфа (Zipf's law)
- Литературная дактилоскопия (Literature Fingerprinting)
- Дерево слов (Word Tree)
>>> from collections import Counter
>>> from nltk.corpus import stopwords
>>> from ruts import WordsExtractor
>>> from ruts.datasets import SovChLit
>>> from ruts.visualizers import zipf

>>> sc = SovChLit()
>>> text = "\n".join(text for text in sc.get_texts(limit=100))
>>> we = WordsExtractor(use_lexemes=True, stopwords=stopwords.words("russian"), filter_nums=True)
>>> tokens_with_count = Counter(we.extract(text))
>>> zipf(tokens_with_count, num_words=100, num_labels=10, log=False, show_theory=True, alpha=1.1)
Компоненты spaCy
Библиотека позволяет создавать компоненты spaCy для следующих классов:
BasicStatsDiversityStatsMorphStatsPhonStatsReadabilityStatsStyleStats
>>> import ruts
>>> import spacy

>>> nlp = spacy.load('ru_core_news_sm')
>>> nlp.add_pipe('basic', last=True)

>>> doc = nlp("Существуют три вида лжи: ложь, наглая ложь и статистика")
>>> doc._.basic.c_letters
{1: 1, 3: 2, 4: 3, 6: 1, 10: 2}

>>> doc._.basic.n_words
9
Значения совпадают с примером выше: знаки препинания и пробельные токены spaCy при подсчёте отфильтровываются.
Подробнее - в документации.
Разработка
Проект использует uv для управления зависимостями и ruff для линтинга и форматирования.
git clone https://github.com/SergeyShk/ruTS.git
cd ruTS

make deps        # создать окружение и установить зависимости
make nltk-data   # загрузить данные NLTK, нужные для тестов
make test        # запустить тесты
make lint        # ruff + mypy
Полный список команд - make help.
Перед отправкой изменений стоит установить хуки, которые прогонят линтеры на коммите и тесты на пуше:
uv run pre-commit install
Участие в проекте
Баг-репорты, идеи и пул-реквесты приветствуются - issues открыты. Перед отправкой пул-реквеста убедитесь, что make lint и make test проходят без ошибок.
Структура проекта
- docs - документация по проекту
- ruts:
- basic_stats.py - базовые текстовые статистики
- components.py - компоненты spaCy
- constants.py - основные используемые константы
- diversity_stats.py - метрики лексического разнообразия текста
- extractors.py - инструменты для извлечения объектов из текста
- morph_stats.py - морфологические статистики
- phon_stats.py - фоностатистики текста
- readability_stats.py - метрики удобочитаемости текста
- style_stats.py - SEO-метрики стиля текста
- utils.py - вспомогательные инструменты
- datasets - наборы данных:
- dataset.py - базовый класс для работы с наборами данных
- sov_chrest_lit.py - советские хрестоматии по литературе
- stalin_works.py - полное собрание сочинений И.В. Сталина
- texts_by_grade.py - тексты с метками класса проекта Plain Russian Language
- visualizers - инструменты для визуализации текстов:
- fingerprinting.py - Литературная дактилоскопия
- word_tree.py - Дерево слов
- zipf.py - Закон Ципфа
- tests - тесты, повторяющие структуру пакета
Авторы
- Шкарин Сергей (kouki.sergey@gmail.com)
- Смирнова Екатерина (ekanerina@yandex.ru)
Лицензия
Цитирование
Пожалуйста, используйте следующую BibTeX нотацию для цитирования библиотеки ruTS, если вы используете ее в своих исследованиях или программах. Цитирование является очень полезным для дальнейшей разработки и поддержки данного проекта.
@software{ruTS,
  author = {Sergey Shkarin},
  title = {{ruTS, a library for statistics extraction from texts in Russian}},
  year = 2026,
  publisher = {Moscow},
  url = {https://github.com/SergeyShk/ruTS}
}
1 maintainer

Download files
Download the file for your platform. If you're not sure which to choose, learn more about installing packages.
Source Distribution
Built Distribution
Filter files by name, interpreter, ABI, and platform.
If you're not sure about the file name format, learn more about wheel file names.
Copy a direct link to the current filters
File details
Details for the file ruts-0.10.0.tar.gz.
File metadata
- Download URL: ruts-0.10.0.tar.gz
- Upload date:
- Size: 77.9 kB
- Tags: Source
- Uploaded using Trusted Publishing? Yes
- Uploaded via:
uv/0.12.13 {"installer":{"name":"uv","version":"0.12.13","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
File hashes
| Algorithm | Hash digest | |
|---|---|---|
| SHA256 |
dfdbf519ed7e3e8dde99d61b4ea83452c5a812490745e30eb3c47aa855059484
|
|
| MD5 |
5061ce93f45291bb178534bdc40b0332
|
|
| BLAKE2b-256 |
17631a2e0d8aa846b0c8ed98b6752f08eb7b38e57d0a499cbbec70083a9cb412
|
File details
Details for the file ruts-0.10.0-py3-none-any.whl.
File metadata
- Download URL: ruts-0.10.0-py3-none-any.whl
- Upload date:
- Size: 78.5 kB
- Tags: Python 3
- Uploaded using Trusted Publishing? Yes
- Uploaded via:
uv/0.12.13 {"installer":{"name":"uv","version":"0.12.13","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
File hashes
| Algorithm | Hash digest | |
|---|---|---|
| SHA256 |
8e889c776d0afd8e797c0a1555dc793945c892c97198680f7de6a1103979f836
|
|
| MD5 |
76fde9c3248953ed82975ec0b59567e8
|
|
| BLAKE2b-256 |
51ec92f20a8dbf8863f4aa791df68af335989b88767e942ae43ae3610471db45
|














