
sk_speech
sk_speech — исследовательский Python-пакет для анализа, измерения,
преобразования, синтеза и визуализации речи. Он объединяет акустические методы
Praat/Parselmouth, Librosa и SciPy с собственными алгоритмами обработки F0,
формант F1–F5, интенсивности, гласных, шума, просодии и физиологических
параметров голосообразования.

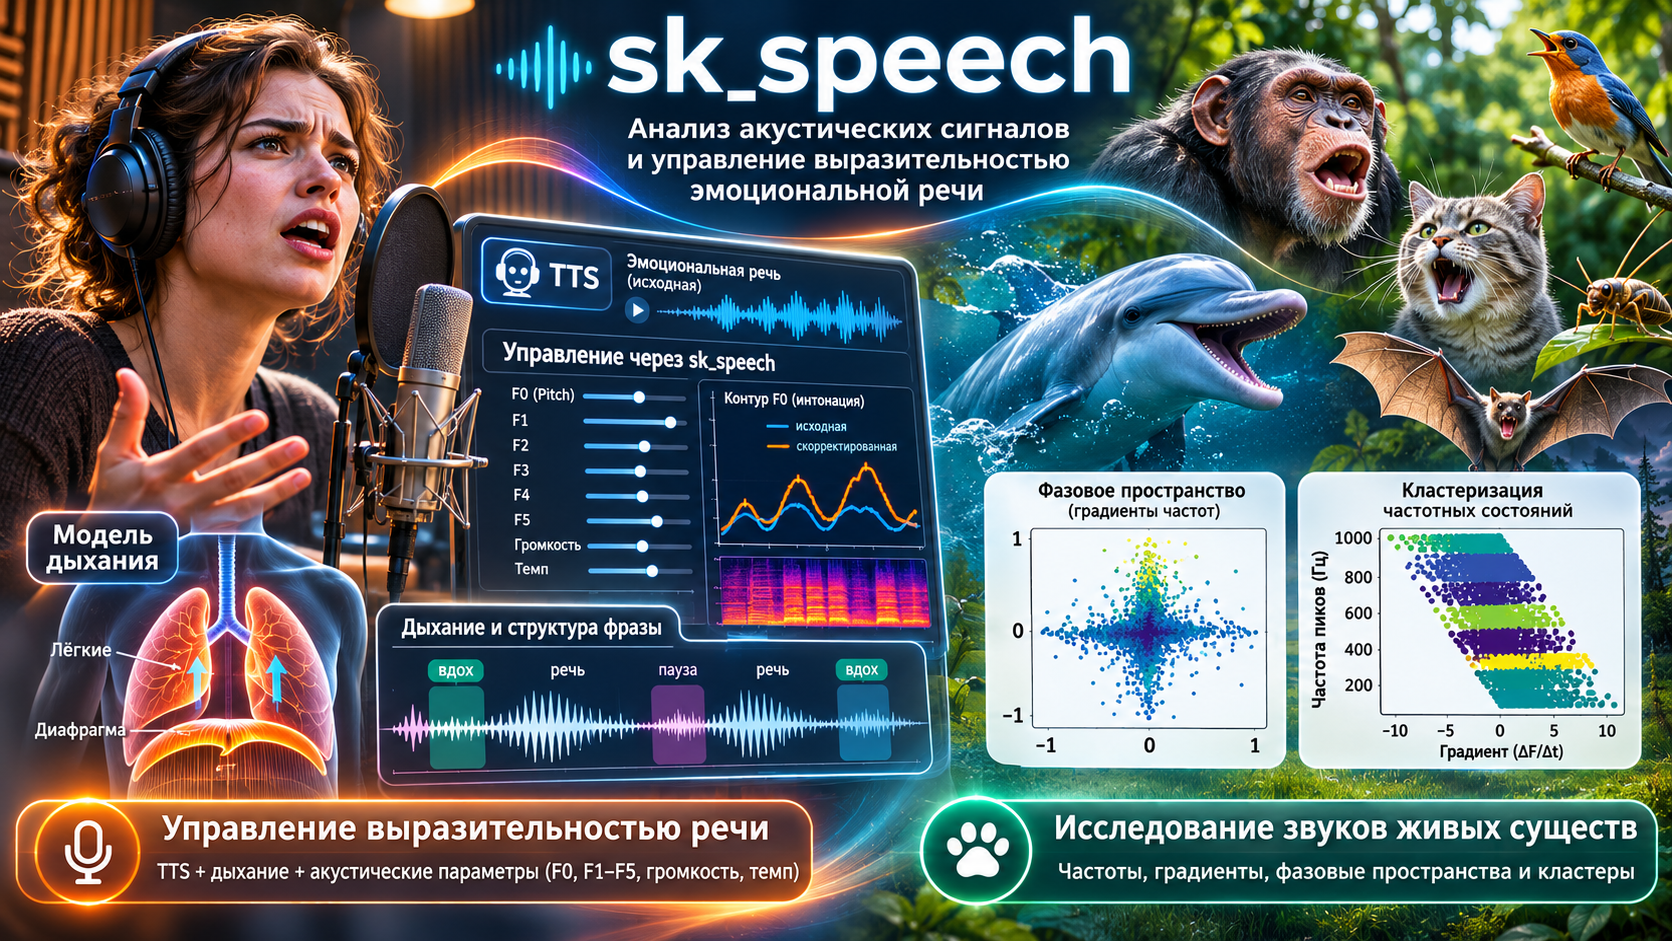
Обзор направлений пакета: анализ и преобразование речи, исследование акустической динамики и экспериментальные модели голосообразования.
Пакет предназначен для широкого спектра задач исследования и программного преобразования речи: от получения покадровых акустических рядов до комплексного профиля говорящего, анализа гласных, синтеза сигналов и моделирования голосового тракта.
Области применения
Акустический анализ
- основной тон F0: частота, диапазон, энергия, интенсивность, амплитуда, ширина полосы, длительность, наклон и периодические изменения;
- форманты F1–F5: частоты, полосы, энергия, интенсивность, амплитуда, длительность, траектории и взаимные расстояния;
- общая интенсивность и относительная амплитуда речи;
- спектральный наклон, спектральная плоскость, PSD и тембральные признаки;
- темп, ритм, паузы, длительность озвученных участков и скорость речи;
- длина голосового тракта и связанные резонансные оценки.
Покадровые последовательности и калибровка
- синхронизированные временные ряды F0, интенсивности и маски озвученных кадров;
- нейтральный калибровочный профиль говорящего;
- абсолютные и относительные отклонения от нейтрального профиля;
- экспорт последовательностей в CSV для статистического анализа и моделей ML.
Классификация режима речи
- тихая и громкая речь;
- шёпот и крик;
- доля тишины и границы речевых участков;
- ясность формант и комплексный диагностический отчёт.
Эти методы являются акустическими эвристиками. Их пороги необходимо калибровать под микрофон, помещение, говорящего и задачу.
Преобразование голоса
- сдвиг, выравнивание, масштабирование диапазона и изменение наклона F0;
- изменение энергии, амплитуды и ширины полосы основного тона;
- независимый сдвиг, усиление и изменение ширины F1–F5;
- изменение интенсивности и плавное изменение громкости;
- ускорение и замедление речи, периодическая модуляция скорости;
- комплексное преобразование речи по рассчитанному акустическому профилю.
Гласные и временная структура
- обнаружение границ и определение типов гласных;
- группировка и поиск пропущенных типов;
- статистика частот, амплитуд и энергии по гласным;
- локальное изменение формант, энергии и амплитуды гласных;
- изменение длительности гласных с сохранением высоты тона, включая WSOLA.
Шум и фильтрация
- RMS, спектральная плоскость и спектральная плотность мощности;
- оценка наличия и уровня шума несколькими методами;
- спектральное вычитание и шумовой профиль;
- ФНЧ, ФВЧ, полосовой, медианный и сглаживающие фильтры;
- адаптивный LMS-фильтр;
- ERB- и гамматонный банк фильтров с адаптацией к F0 и формантам.
Синтез и физическое моделирование
- генерация гармонических и формантных сигналов;
- синтез звука по динамике частоты, полосы и интенсивности;
- модели площади голосовой щели, воздушного потока и субглотического давления;
- оценки сопротивления дыхательных путей, числа Рейнольдса и SPL;
- экспериментальные модели дыхания, сердца, давления, гормонов и метаболизма.
Визуализация и пакетная обработка
- траектории F0 и формант;
- спектры, PSD, спектрограммы и спектральный наклон;
- границы гласных и сравнение сигналов до и после преобразования;
- обработка каталогов WAV-файлов и подготовка сериализуемых профилей.
Установка
Из PyPI:
python -m pip install sk-speech
Актуальная версия ветки main из GitHub:
python -m pip install "git+https://github.com/iproxy3d/sk_speech.git"
Для разработки и запуска примеров:
git clone https://github.com/iproxy3d/sk_speech.git
cd sk_speech
python -m pip install -e ".[dev,examples]"
Необязательные расширения устанавливаются только для использующих их задач:
# Нейросетевая оценка F0 методом PENN
python -m pip install "sk-speech[penn]"

# Сдвиг высоты тона через pyrubberband
python -m pip install "sk-speech[rubberband]"
Расширение rubberband дополнительно требует системную консольную программу
Rubber Band в PATH. Обычная установка sk-speech не загружает PENN, PyTorch
или pyrubberband, поэтому эти зависимости не влияют на базовую установку под
Windows и Linux.
Для чтения и записи форматов, которые soundfile не поддерживает напрямую,
pydub может дополнительно потребовать установленный ffmpeg. Интерактивные
примеры требуют аудиоустройства и оконной среды.
Быстрый старт
Комплексный акустический профиль
import librosa
from sk_speech import sk_volume

y, sr = librosa.load("speech.wav", sr=None, mono=True)
profile = sk_volume.get_speech_params(y, sr)

print(profile["f0"]["freq"])
print(profile["f1"]["freq"], profile["f2"]["freq"])
print(profile["duration"], profile["speed"])
print(profile["vowels"])
get_speech_params() объединяет признаки F0, F1–F5, длительность, скорость,
гласные, оценку пола и длину голосового тракта. Словарь options позволяет
отключать ненужные и более дорогие вычисления.
Временные ряды F0 и интенсивности
from sk_speech import PitchConfig, PitchExtractor

extractor = PitchExtractor(
    PitchConfig(
        sample_rate=16_000,
        frame_step_s=0.01,
        pitch_floor_hz=50.0,
        pitch_ceiling_hz=800.0,
    )
)

track = extractor.from_file("speech.wav")
track.to_csv("pitch_features.csv")

print(track.time_s)
print(track.f0_hz)
print(track.intensity_db)
print(track.voiced)
f0_hz содержит NaN на неозвученных кадрах. intensity_db —
широкополосная интенсивность Praat на той же временной сетке. Для обычной
цифровой записи это относительный уровень; физический dB SPL требует
калибровки всей измерительной цепочки.
Нейтральный профиль говорящего
from sk_speech import PitchExtractor, PitchProfile, calibrate_pitch, normalize_pitch

extractor = PitchExtractor()
profile = calibrate_pitch(extractor.from_file("neutral.wav"))
profile.save("pitch_profile.json")

normalized = normalize_pitch(
    extractor.from_file("current.wav"),
    PitchProfile.load("pitch_profile.json"),
)
normalized.to_csv("normalized_pitch.csv")
Нормализованный ряд содержит относительное отклонение F0, отклонение F0 в герцах, разность интенсивности в децибелах и маску озвученных кадров.
Форманты F1–F5
import librosa
from sk_speech import sk_formants

y, sr = librosa.load("speech.wav", sr=None, mono=True)
formants = sk_formants.get_formant_info(y, sr)

for index in range(1, 6):
    value = sk_formants.get_formant_frequency_by_index(
        y, sr, index, formants=formants
    )
    print(f"F{index}: {value:.1f} Hz")
Детектирование режима речи
import librosa
from sk_speech import sk_detection

y, sr = librosa.load("speech.wav", sr=None, mono=True)

result = {
    "soft": sk_detection.is_soft_speech(y, sr),
    "loud": sk_detection.is_loud_speech(y, sr),
    "whisper": sk_detection.is_whisper(y, sr),
    "scream": sk_detection.is_scream(y, sr),
}
print(result)
Оценка и подавление шума
import librosa
import soundfile as sf
from sk_speech import sk_noise

y, sr = librosa.load("noisy.wav", sr=None, mono=True)
report = sk_noise.analyze_noise_level(y, sr)
clean = sk_noise.noise_reduction_spectral_subtraction(y, sr)

print(report)
sf.write("clean.wav", clean, sr)
Преобразование F0, формант и скорости
import librosa
import soundfile as sf
from sk_speech import sk_formants, sk_pitch

y, sr = librosa.load("speech.wav", sr=None, mono=True)
y = sk_pitch.change_pitch_shift_hz(y, sr, pitch_shift_hz=20)
y = sk_formants.change_formant_frequencies(
    y, sr, frequency_factors=[1.04, 1.03, 1.02, 1.01, 1.0]
)
y = sk_pitch.change_audio_speed(y, sr, begin_speed=1.0, end_speed=1.1)

sf.write("transformed.wav", y, sr)
Модули пакета
| Модуль | Назначение |
|---|---|
sk_speech.pitch |
Высокоуровневые временные ряды F0 и интенсивности, калибровка и CSV |
sk_speech.sk_pitch |
Расширенный анализ и преобразование F0, просодии, ритма и тембра |
sk_speech.sk_formants |
Анализ, динамика, паттерны, синтез и преобразование F1–F5 |
sk_speech.sk_volume |
Комплексные профили речи, векторы и составные преобразования |
sk_speech.sk_vowels |
Границы, типы, статистика и преобразование гласных |
sk_speech.sk_detection |
Тихая/громкая речь, шёпот, крик, паузы и ясность |
sk_speech.sk_noise |
Метрики шума, PSD и шумоподавление |
sk_speech.sk_filters |
Временные, частотные, LMS-, ERB- и гамматонные фильтры |
sk_speech.sk_gammatone |
Адаптивная гамматонная обработка |
sk_speech.sk_plot |
Визуализация акустических признаков и преобразований |
sk_speech.sk_signal |
Гармонический и параметрический синтез сигналов |
sk_speech.sk_vocal_tract |
Расчёты длины голосового тракта и резонансов |
sk_speech.sk_vocal_cords |
Голосовая щель, поток, давление, сопротивление и SPL |
sk_speech.regulators |
Экспериментальные физиологические регуляторы речи |
Документация начинается с навигационной страницы. Отдельно доступны помодульный справочник API, руководство «С чего начать», руководство по экспериментальному моделированию дыхания и голосообразования и каталог готовых примеров.
Структура репозитория
sk_speech/
├── src/
│   └── sk_speech/       # импортируемый Python-пакет
│       ├── pitch/       # высокоуровневый API F0 и интенсивности
│       └── data/        # встроенные JSON- и WAV-ресурсы
├── examples/            # готовые сценарии анализа и преобразования
├── docs/                # руководства и помодульный справочник API
│   └── api/             # отдельные файлы API по модулям
├── tests/               # автоматические тесты
├── tools/               # инструменты сопровождения документации
└── pyproject.toml       # сборка, зависимости и метаданные пакета
Каталог src/ намеренно является корнем исходного кода, а
src/sk_speech/ — самим импортируемым пакетом. Это стандартная src layout
структура Python-проектов: она отделяет исходники от файлов репозитория и
не позволяет тестам случайно импортировать неустановленную локальную копию.
После установки путь src не появляется в имени импорта:
import sk_speech
Тесты
python -m pytest
GitHub Actions запускает тесты на Python 3.10, 3.11 и 3.12.
Лицензия
Пакет распространяется на условиях лицензии MIT.
1 maintainer

Metadata
1 maintainer
Release files for sk-speech 0.1.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | Provenance | Actions |
|---|---|---|---|---|
| sk_speech-0.1.0.tar.gz | 5.3 MB | With provenance | Details for sk_speech-0.1.0.tar.gz |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Actions Reset |
|---|---|---|---|---|
| sk_speech-0.1.0-py3-none-any.whl | Python 3 | none | any | Details for sk_speech-0.1.0-py3-none-any.whl |
Total release size: 10.4 MB
Release files / sk_speech-0.1.0.tar.gz
| Download URL | sk_speech-0.1.0.tar.gz |
|---|---|
| Size | 5.3 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
eee33bc737ce24353695acdac9dbc2a2508f6abbc3b325f546696d5096d93ea2
|
|
BLAKE2b-256 checksum How to use checksums |
1288f761608bbbd6e6d7f05b29bd34345b9acca06d637e270eca1b0136b5e539
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.16
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.


PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Nov 2, 2026.
Transparency logRelease files / sk_speech-0.1.0-py3-none-any.whl
| Download URL | sk_speech-0.1.0-py3-none-any.whl |
|---|---|
| Size | 5.2 MB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
32749e7c7f75c43feccdf25d93490b11a1db56efd1a8a415d33e2d71186f2f64
|
|
BLAKE2b-256 checksum How to use checksums |
ea848d69dfe555235927649569678a0d0e8bda966612b80d989b8184adb80a61
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.16
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Nov 2, 2026.
Transparency logSecurity for sk-speech 0.1.0
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
Full provenance
All 2 files in this release have been uploaded with provenance metadata.
Attestation for sk_speech-0.1.0.tar.gz
PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Nov 2, 2026.
Transparency logA note on package security
PyPI is a repository for distributing packages, not a service for auditing them. While third-party security researchers and our staff do their best to detect and remove malicious packages, PyPI cannot guarantee the quality, security or suitability of any given package.
To learn more about protecting yourself from malicious actors, visit our package security documentation.













