
Слой_AI
Python-библиотека для обучения небольших языковых моделей на MLX
Обучение по блокам. Контроль памяти. Python API и команда sloy.


Библиотека уже доступна на PyPI: sloy-ai.
python -m pip install sloy-ai
from sloy_AI import train
from sloy_AI.config import Config
Обучение с нуля одной командой (0.2.0):
sloy train --model auto --data dialogs.jsonl --memory-budget-gb 4 --run runs/first
sloy help all
TXT/JSONL → проверка и разделение данных → подбор архитектуры и микробатча → обучение →
полные веса в runs/first/model/ и отчёт report.md. В панели H / F1 открывает шпаргалки.
Руководство по новому сценарию.
Python 3.11+ · macOS на Apple Silicon · MLX / Metal. Пример обучения из Python · Установка и первый запуск
Слой_AI — Python-библиотека для обучения небольших causal Transformer на MLX. Она умеет обновлять отдельные группы слоёв, кэшировать неизменный префикс и подбирать микробатч по короткому замеру памяти. Обучением можно управлять из терминала или Python, останавливать его на безопасной границе и продолжать из сохранённого состояния.
Опубликовано: 0.2.0 на PyPI · Alpha. Сейчас поддерживается собственная модель float32 с байтовой токенизацией. Это инструмент для небольших экспериментов, а не обещание обучать произвольные большие модели на любом компьютере.
Быстрый старт · Консоль · Как это работает · Продолжение · Python API · Результаты · Документация
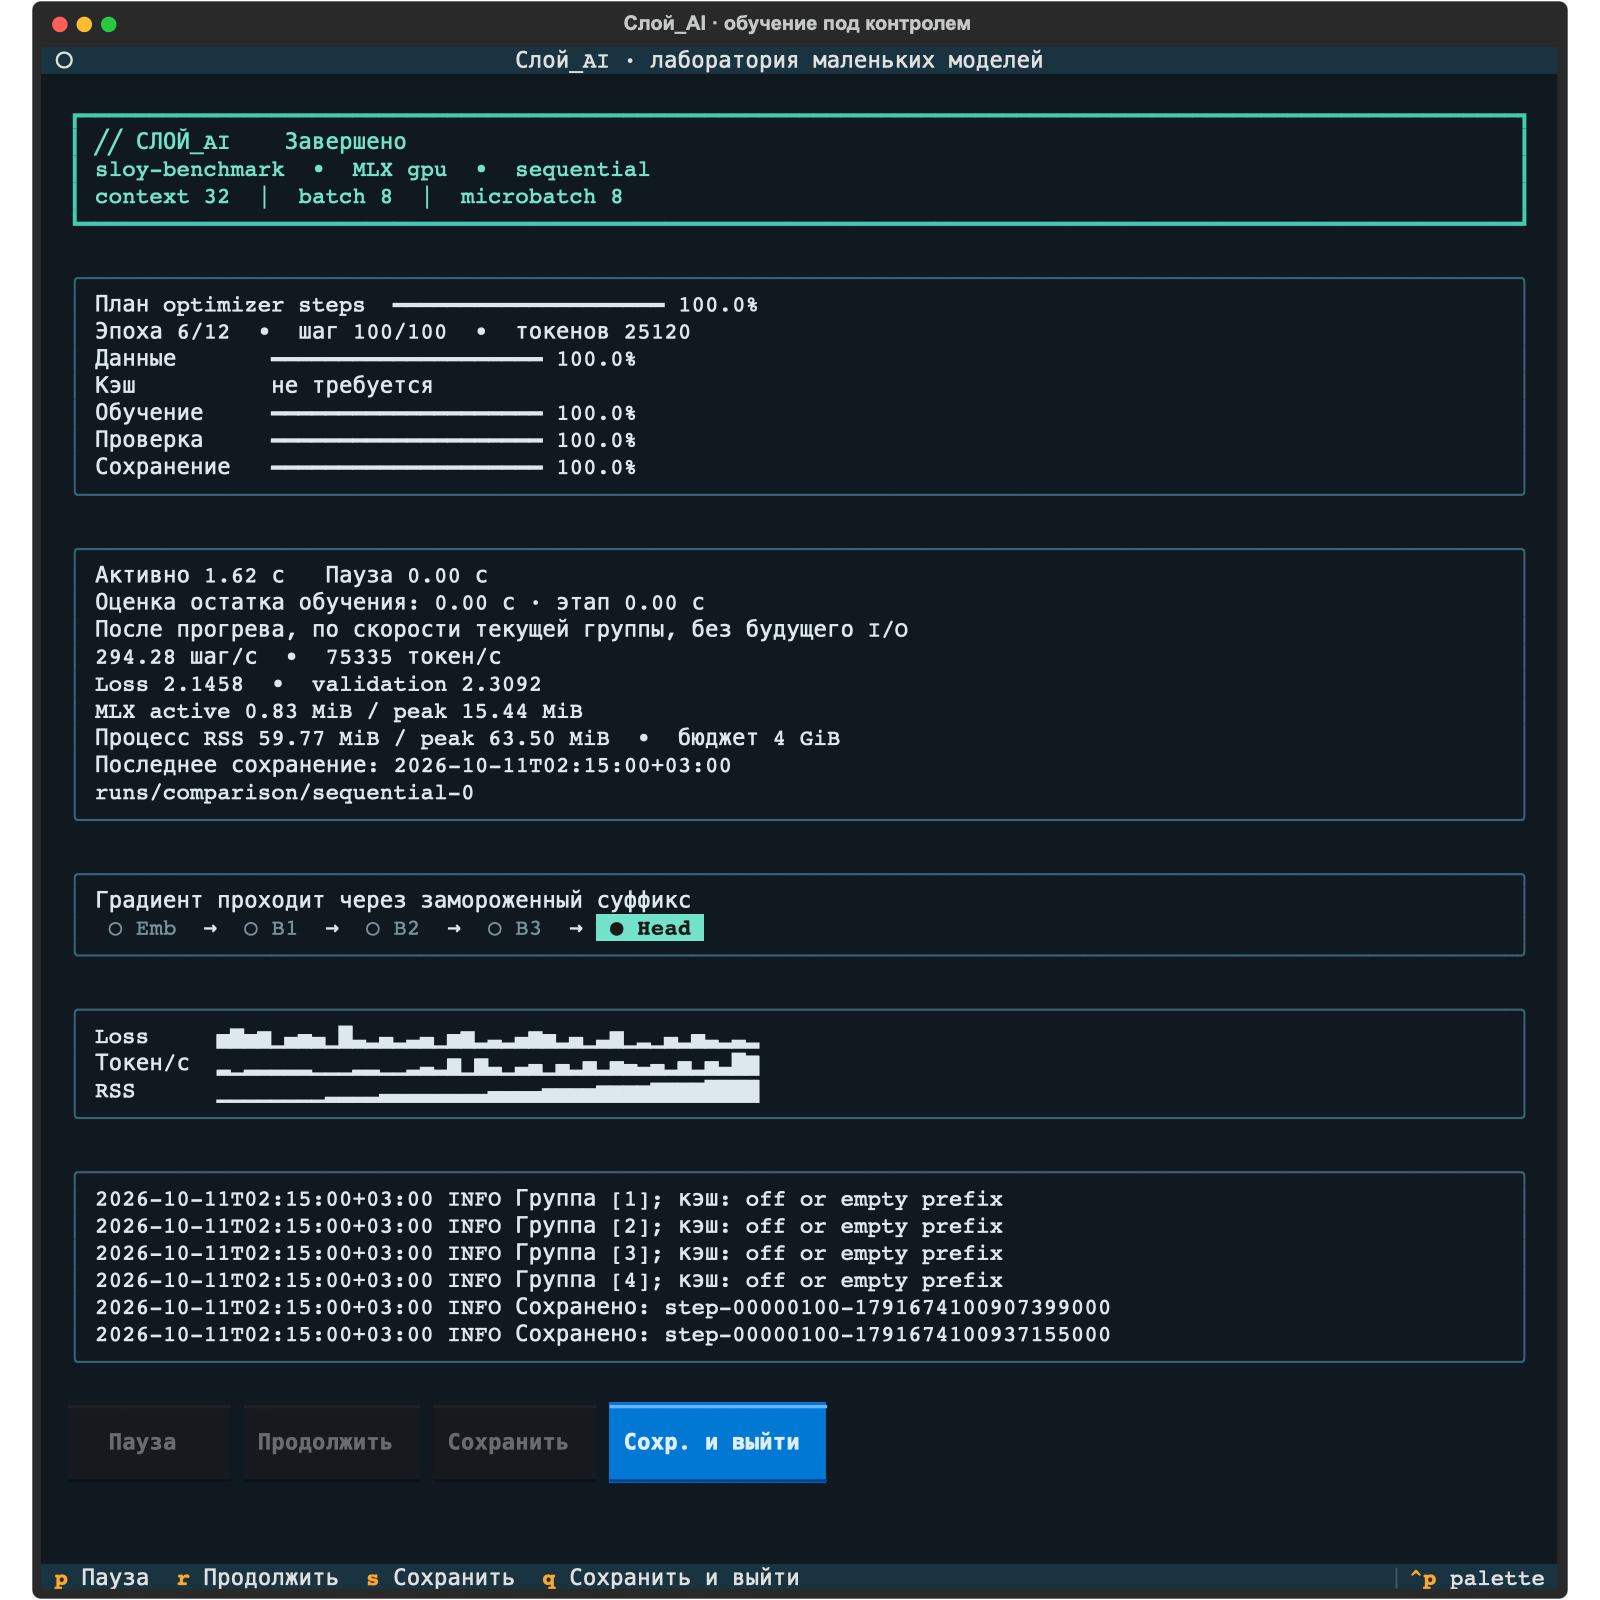
Панель на метриках реального короткого запуска. Для публикации скрыты только локальные пути.
Документация
| Начать | Использовать | Разрабатывать |
|---|---|---|
| Первый запуск до генерации | Все команды CLI | Участие в проекте |
| Требования и ошибки установки | Python API | Архитектура |
| Термины и единицы | Конфигурация | Выпуск на PyPI |
Что внутри
| Возможность | Поведение |
|---|---|
| Запуск с нуля одной командой | TXT/JSONL, архитектуры tiny/small/medium, автоматический экспорт и отчёт |
| Шпаргалки внутри консоли | sloy help, темы справки, H/F1 во время обучения |
| Три режима обучения | Все веса, группы по очереди, экспериментальный адаптивный выбор |
| Корректный backward | Замороженный суффикс пропускает градиент к обучаемой группе |
| Кэш префикса | Дисковый float32-кэш с проверкой весов, данных, токенизации и контекста |
| Подбор микробатча | Изолированные пробные процессы, резерв памяти, неизменный контекст |
| Продолжение | Веса, Adam, RNG, данные, scheduler, метрики и часы в одном checkpoint |
| Консоль | Textual, горячие клавиши, графики, логи; plain-режим для скриптов |
| Экспорт | Модель отдельно от полного состояния обучения; latest или best |
Быстрый старт
1. Установите пакет
Нужны Python 3.11+, macOS на Apple Silicon и совместимая версия MLX с Metal. Поддержка конкретной версии macOS определяется доступностью wheel MLX. Остальные платформы не входят в проверенный сценарий этого выпуска.
python3 -m venv .venv
source .venv/bin/activate
python -m pip install 'sloy-ai==0.2.0'
Название дистрибутива на PyPI нормализуется до sloy-ai, Python-import — sloy_AI,
команда терминала — sloy. Для установки исходников:
git clone https://gitlab.com/salyukov.gleb033/sloy_ai.git
cd sloy_ai
python -m pip install -e '.[test]'
2. Создайте пример
sloy init --directory my-first-model
Команда создаст tiny.yaml и небольшой corpus.txt из ресурсов пакета. Модели и
датасеты не скачиваются. Существующая папка не перезаписывается.
3. Запустите обучение
sloy train --config my-first-model/tiny.yaml --memory-budget-gb 4
Сначала выполняется короткий пробник. Затем открывается панель. Каждый запуск получает
свою папку в runs/. В комплектном примере план составляет 34 шага за 2 эпохи:
max_steps: 40 — верхняя граница, а не обещание выполнить лишние шаги.
Хотите выбрать путь сами или перенаправить вывод:
sloy train --config my-first-model/tiny.yaml --run runs/first --plain
После этого продолжение — sloy resume --run runs/first, экспорт —
sloy export --run runs/first --output exports/first.
Консоль, которая показывает работу
Панель выводит модель, устройство, параметры, общий план, эпоху, optimizer step, скорость, train loss, последний validation loss и схему активных блоков. Отдельные индикаторы показывают данные, кэш, обучение, проверку и сохранение.
╱╱ СЛОЙ_AI    Обучение
sloy-tiny  •  MLX gpu  •  sequential
context 32  |  batch 8  |  microbatch 8

План optimizer steps  ━━━━━━━━━━──────────  50.0%
Эпоха 1/2  •  шаг 17/34

○ Emb  →  ○ B1  →  ● B2  →  ○ B3  →  ○ Head
                  обучается

[P] Пауза   [R] Продолжить   [S] Сохранить   [Q] Сохранить и выйти
Схематический фрагмент интерфейса; фактические значения зависят от запуска.
| Действие | Клавиша | Когда выполняется |
|---|---|---|
| Пауза + checkpoint | P |
После завершения optimizer step со всеми микробатчами |
| Продолжить | R |
Из состояния «На паузе» |
| Сохранить без остановки | S |
На ближайшей безопасной границе |
| Сохранить и выйти | Q / Ctrl+C |
После завершения текущей работы на границе шага |
При узком терминале кнопки переходят в вертикальную компоновку, содержимое
прокручивается. Завершённая панель остаётся открытой до Q.
Во время записи конфликтующие действия блокируются. Запрошенный выход не разрывает
запись посередине. Вызов MLX и целиком идущая подготовка кэша/validation не прерываются
внутри вычисления: интерфейс принимает запрос, а движок обрабатывает его на границе.
Как читать показатели:
- Общий процент считается из реального числа запланированных optimizer steps.
- Неизвестный объём этапа обозначается
⋯, недоступное измерение —н/д. - ETA появляется после трёх шагов текущей группы, исключает паузу и сбрасывается при смене этапа. Это экстраполяция скорости, без будущего cache/validation/save I/O.
- MLX active/peak и RSS/peak процесса показаны отдельно. Их нельзя складывать: в общей памяти измерения могут пересекаться.
- Время последнего успешного checkpoint и папка запуска доступны прямо в панели.
Без TTY автоматически используется plain-режим. Полная история шагов остаётся в
metrics.jsonl, даже если консоль выводит только часть обновлений.
Как это работает
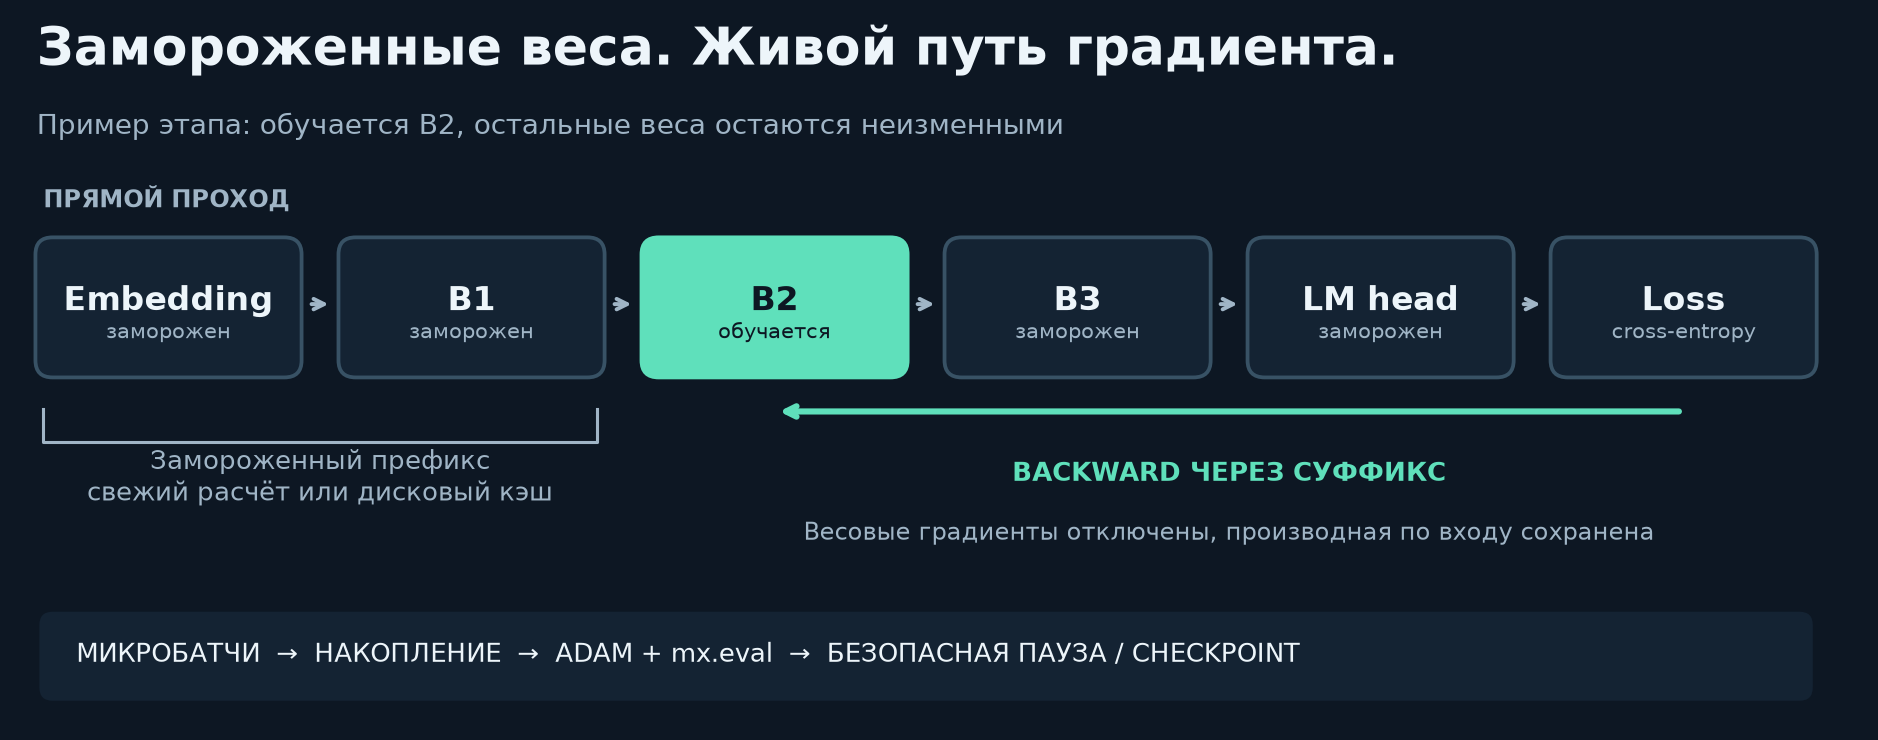
Модель разбивается на последовательные единицы: embedding + позиции → Transformer блоки → normalization + LM head. Голова и embedding тоже участвуют в расписании, чтобы обучение с нуля не оставляло их случайными.
- Планировщик выбирает непрерывную группу. Её веса размораживаются, остальные — нет.
- Замороженный префикс вычисляет представления. Их можно сохранить и повторно читать.
- Обучаемая группа и замороженный суффикс вычисляют logits и cross-entropy.
- Градиент проходит через суффикс к группе. Замораживание весов суффикса не отменяет backward по его входам и память промежуточных вычислений.
- Микробатчи накапливают взвешенные градиенты. После единого Adam update и
mx.evalможно безопасно сохранять, останавливаться или менять группу.
Состояния Adam неактивных групп выгружаются на диск. stop_gradient применяется
только к замороженному префиксу. Кэш при смене группы проверяется по SHA256 весов
префикса, данных, версии tokenizer и контекста, затем при необходимости перестраивается.
mode |
Что обучается | Для чего |
|---|---|---|
baseline |
Все веса каждый шаг | Контроль качества и стоимости |
sequential |
Соседние группы по очереди | Простой воспроизводимый порядок |
adaptive |
Группы по эвристике loss/time с исследованием | Эксперимент; преимущество не гарантировано |
cache: auto включает кэш только при положительной оценке амортизации.
cache: on принудительно строит его для сравнения, off отключает.
Переиспользование может оказаться дороже свежего вычисления — особенно на маленькой модели.
Подробнее: архитектура и инварианты.
Настройка обучения
Полный пример находится в созданном tiny.yaml. Путь data разрешается относительно
этого YAML, а не текущей рабочей папки.
name: my-small-lm
data: corpus.txt
seed: 42
context: 32
dim: 48
heads: 4
layers: 3

epochs: 2
max_steps: 40
batch_size: 8
microbatch: 2
learning_rate: 0.003

mode: sequential
group_size: 1
stage_steps: 8
cache: auto
memory_budget_gb: 4
auto_microbatch: true

validation_every: 8
best_metric: validation_loss
save_every: 16
save_seconds: 300
keep_checkpoints: 3
device: gpu
batch_size — число окон на обновление оптимизатора; microbatch — сколько окон
считается одновременно. Уменьшение микробатча увеличивает число накоплений, сохраняя
эффективный batch. context измеряется в байтах, не в словах.
Пробник проверяет 1, 2, 4… окна до batch_size в отдельных процессах. Выбирает
наибольший прошедший вариант с запасом 25%, резервом 2 GiB общей RAM для ОС и
512 MiB текущей available memory. Контекст автоматически не уменьшается.
Бюджет — ориентир, не системный лимит и не гарантия отсутствия OOM или swap.
Сохранить сейчас, продолжить позже
# Последняя исправная версия; повреждение latest явно пишется в лог.
sloy resume --run runs/first

# Строго указанная версия; подмена другим checkpoint не выполняется.
sloy resume --checkpoint runs/first/checkpoints/step-00000016-<id>

# Последняя модель или лучшая по выбранной метрике.
sloy export --run runs/first --output exports/latest
sloy export --run runs/first --output exports/best --best
Checkpoint включает веса, Adam, состояние постоянного LR, шаги/токены/эпоху, позицию и перемешивание данных, NumPy/Python/MLX RNG, выбранную группу, scheduler, конфигурацию, tokenizer, hash данных, метрики и накопленные часы. Кэш можно построить заново.
Запись идёт во временную папку: файлы → checksums → проверка → rename → latest. Минимум две исправные версии сохраняются, best закрепляется отдельно. Нехватка места не удаляет предыдущую исправную копию. Изменённые данные или несовместимая конфигурация вызывают ошибку, а не скрытое начало нового обучения.
runs/first/
├── config.json             # зафиксированные параметры
├── provenance.json         # tokenizer, данные, версия MLX
├── probe.json              # замер и выбранный microbatch, если пробник включён
├── run.log                 # сообщения с временем и уровнем
├── metrics.jsonl           # метрики законченных шагов
├── summary.json            # итог при нормальном завершении
├── checkpoints/
│   ├── latest.json
│   ├── best.json
│   └── step-00000016-<id>/  # веса + optimizer + RNG + manifest + state
├── optimizer-bank/         # рабочие состояния неактивных групп
└── cache/                  # восстанавливаемые представления префикса
При внезапном отключении питания или SIGKILL восстановление ограничено последней
исправной записью. Экспорт модели — не checkpoint для resume.
Руководство по сохранению и восстановлению
Python API
Обучение без терминального интерфейса
from sloy_AI import train
from sloy_AI.config import Config
from sloy_AI.probe import tune

config = Config.load("my-first-model/tiny.yaml")
config, probe_report = tune(config)  # явный подбор для Python API
engine = train(config, run="runs/python-example")
print(engine.run)
Прямой Engine использует уже заданный microbatch; auto_microbatch автоматически
обрабатывает CLI. Для управления из другого потока используйте Controller.
Загрузка и генерация
from sloy_AI.inference import load_export, generate

model, config = load_export("exports/best")
text = generate(model, config, "The ", max_bytes=80)
print(text)
Генерация greedy и байтовая: маленькая модель после короткого примера ещё не обязана создавать связный текст. Некорректные UTF-8 последовательности декодируются с заменой.
API и интеграция с приложением
Что показывают измерения
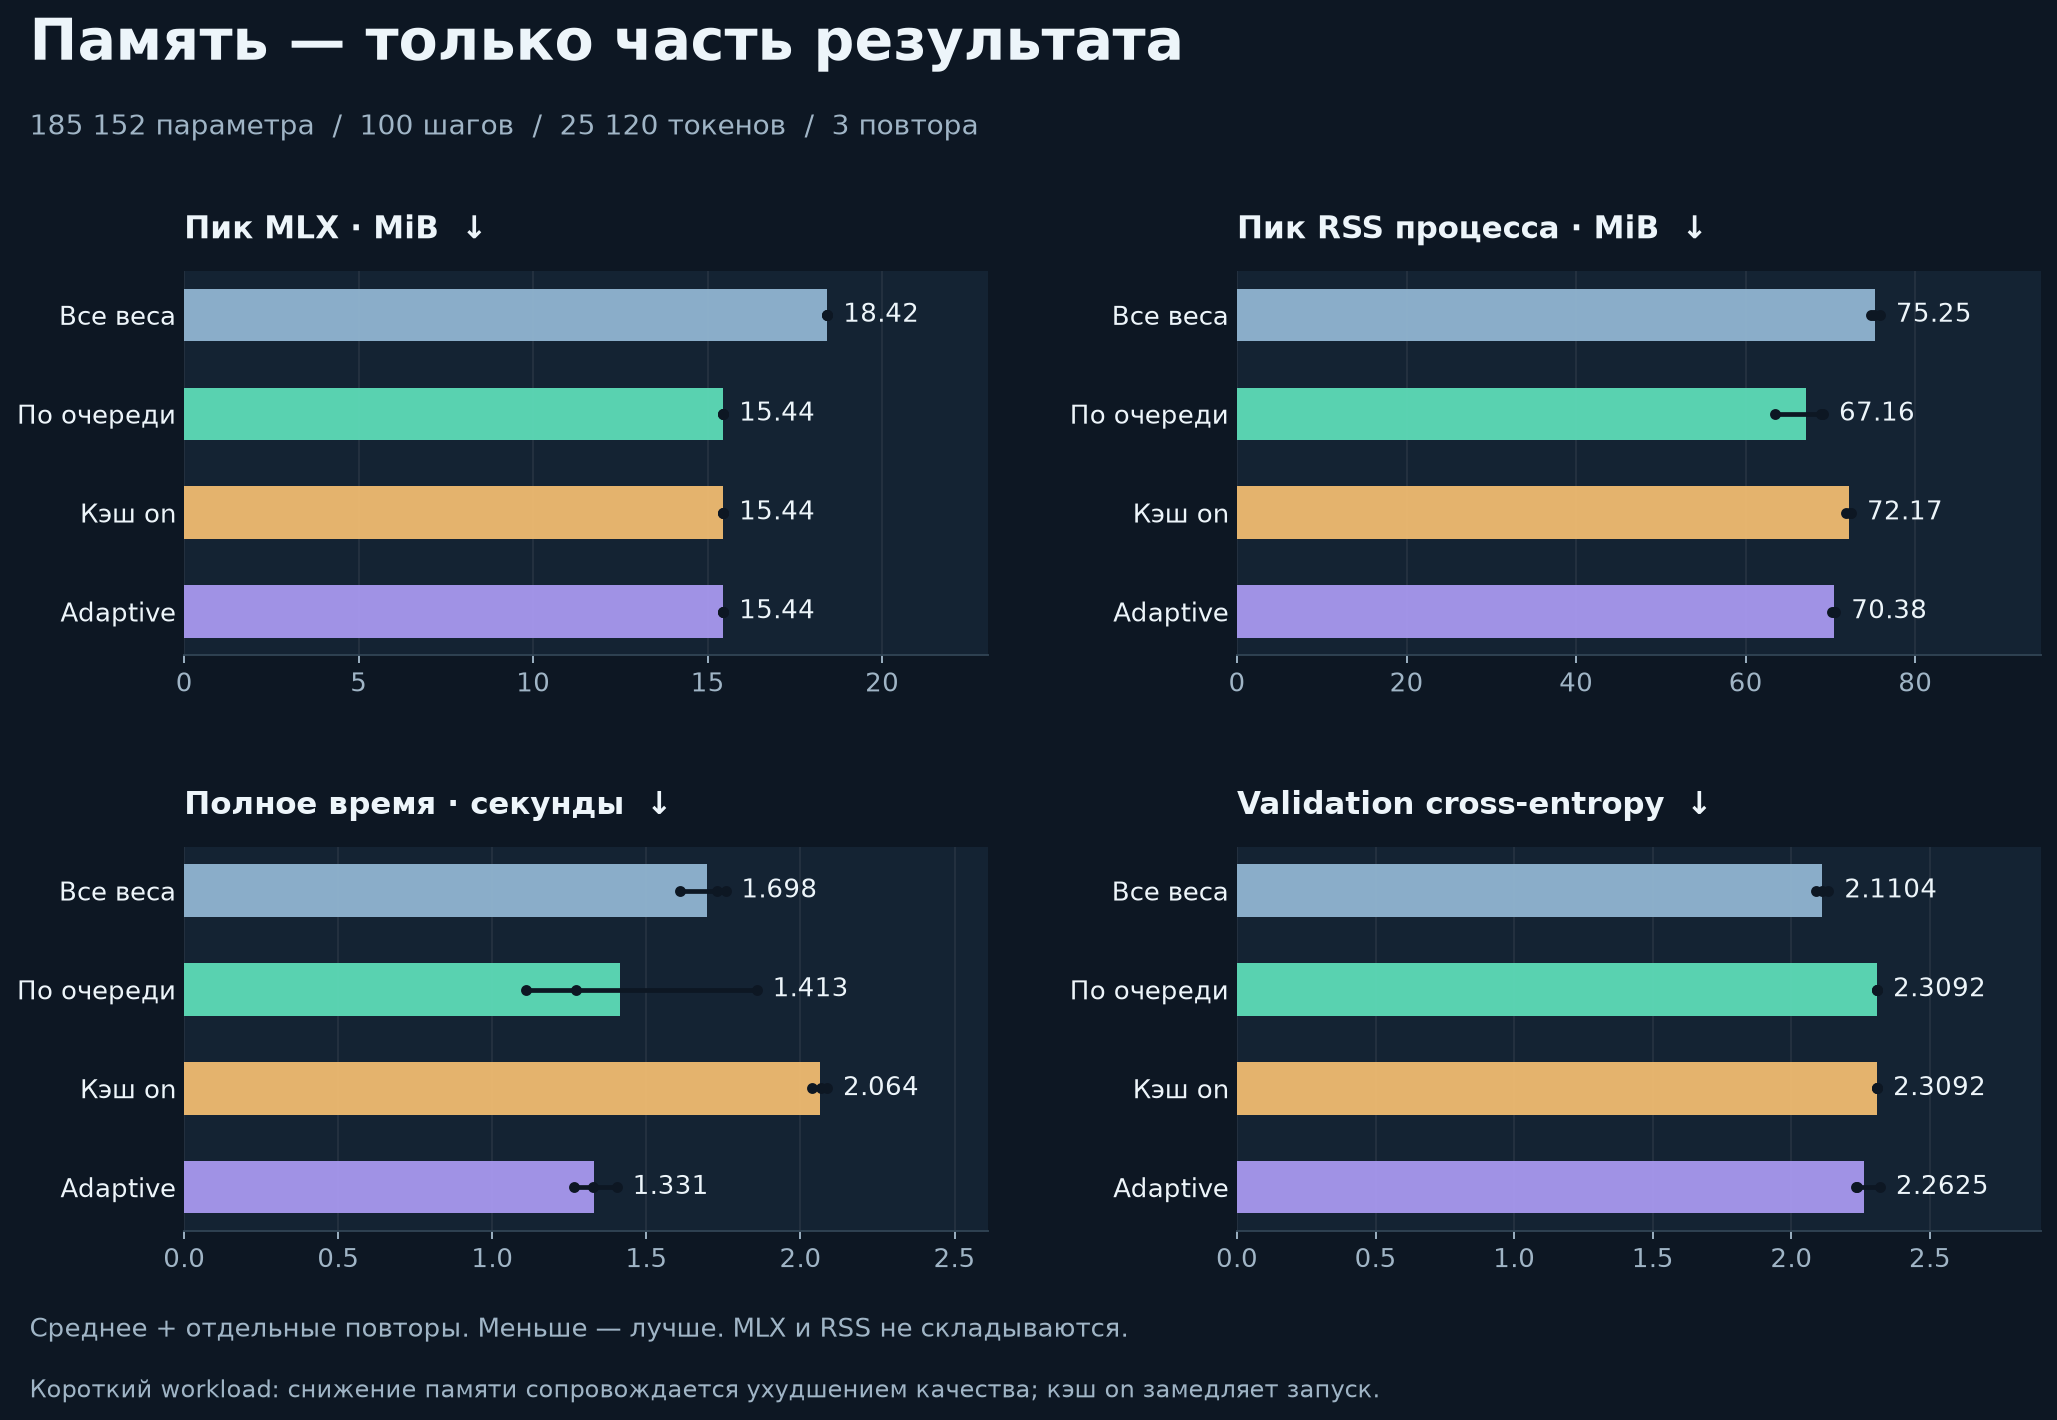
Короткое сравнение: 185 152 параметра · 100 шагов · 25 120 токенов · context 32 · effective batch 8 · 3 повтора на метод. Ниже средние; меньше — лучше.
| Метод | MLX peak, MiB | RSS peak, MiB | Wall, с | Validation CE |
|---|---|---|---|---|
| Все веса | 18.42 | 75.25 | 1.698 | 2.1104 |
| По очереди, без кэша | 15.44 | 67.16 | 1.413 | 2.3092 |
| По очереди, кэш on | 15.44 | 72.17 | 2.064 | 2.3092 |
| Adaptive, кэш auto | 15.44 | 70.38 | 1.331 | 2.2625 |
В этом workload блочные методы уменьшили измеренный пик MLX примерно на 16.2%, но уступили baseline по качеству. Принудительный кэш замедлил запуск; auto его не включил. Wall включает процесс, кэш, validation и сохранения. Из-за короткой длительности и разброса это не доказательство устойчивого ускорения.
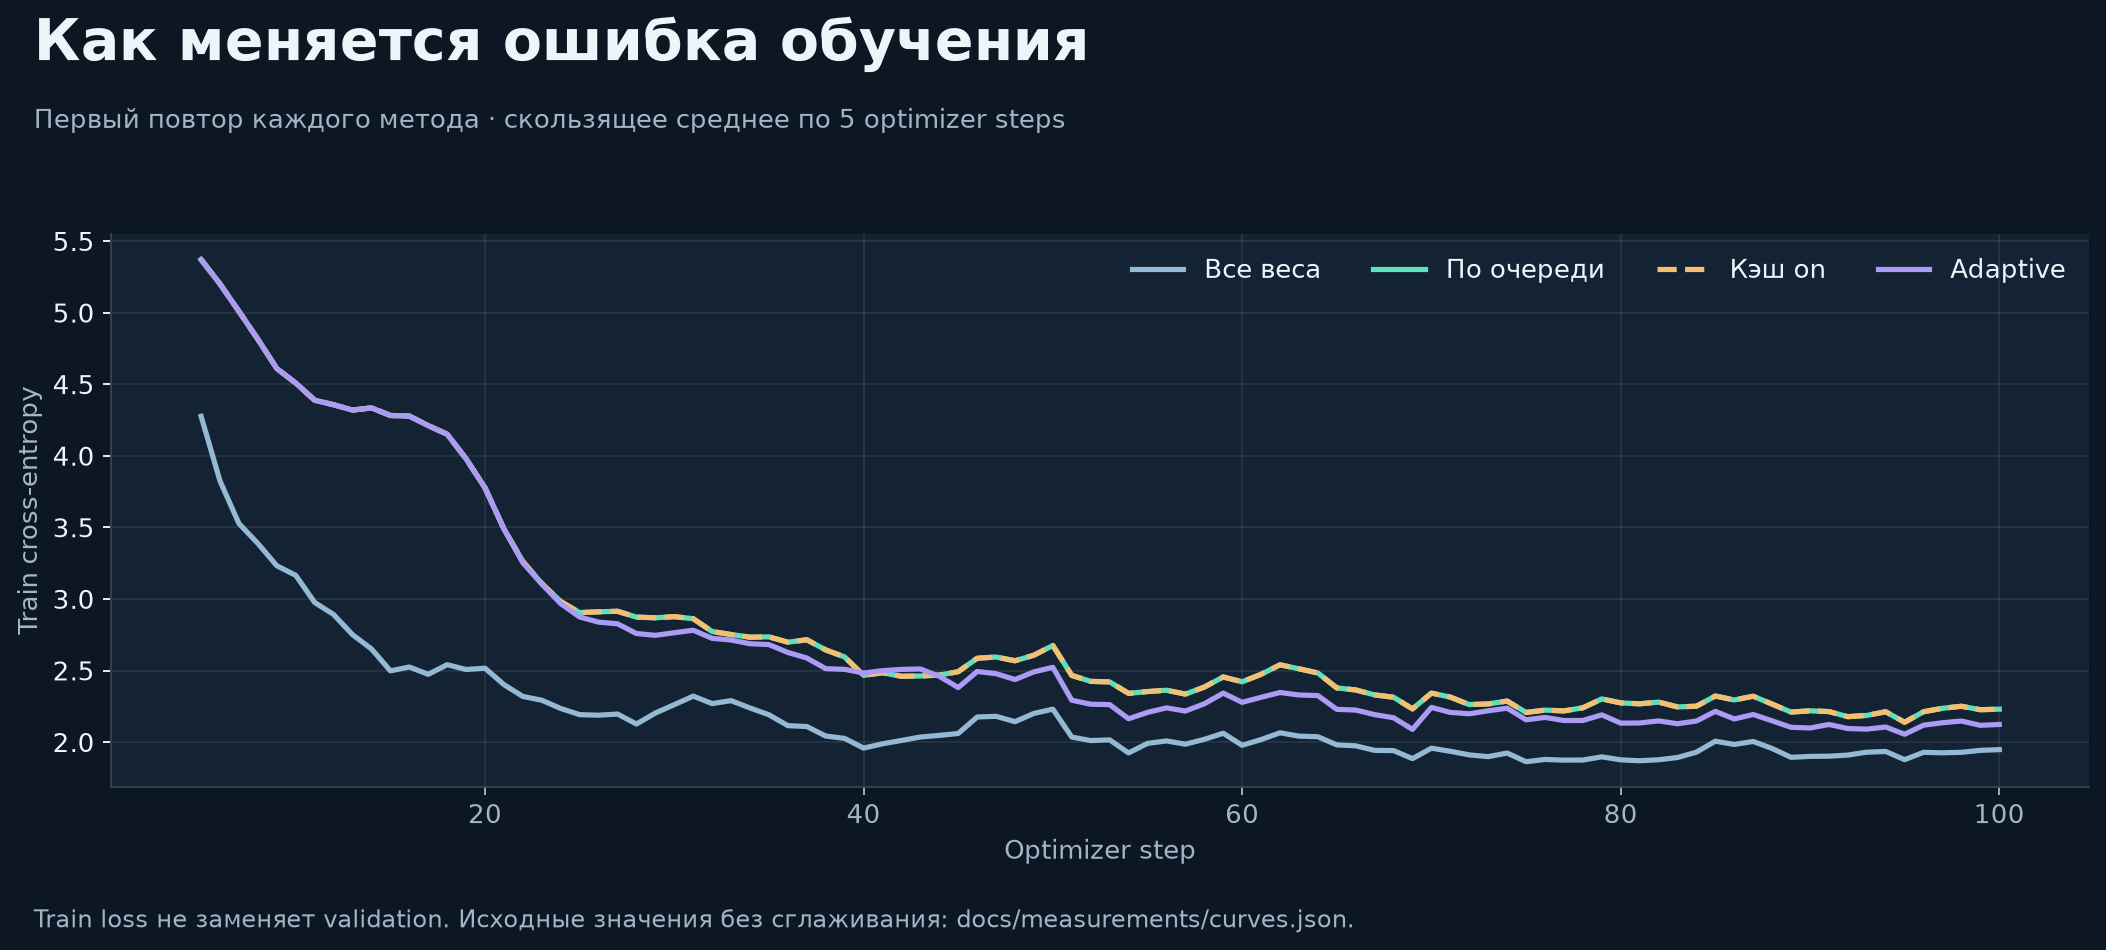
Команда из корня клонированного репозитория:
sloy benchmark --config examples/benchmark.yaml --output runs/comparison --repeats 3
Методика и ограничения замера · Исходные числа
Ограничения и частые вопросы
Можно ли загрузить любую внешнюю модель? Нет. В 0.2 поддерживается только собственный Transformer, float32, фиксированные окна и UTF-8 byte tokenizer. LoRA, quantization, dropout и распределённое обучение пока не реализованы.
Почему маленький microbatch не гарантирует отсутствие OOM? В памяти остаются веса, активные состояния, градиенты и вычисления суффикса. Корпус и окна также загружаются в RAM. ОС и другие программы делят доступную память.
Можно изменить YAML перед resume? Для продолжения с тем же состоянием нужна совместимая конфигурация. Изменение архитектуры, данных и формата tokenizer — новый эксперимент. Ошибки совместимости описаны в журнале.
Будут ли результаты побитово одинаковыми? Не гарантируется. Короткий тест
сравнивает resume с непрерывным запуском при atol=rtol=2e-5. Долгие GPU-запуски
могут расходиться; adaptive дополнительно зависит от измеренного времени.
Почему не открылась панель? Проверьте TTY. Перенаправление вывода, неинтерактивный
stdin или --plain включают простой режим. При недоступном GPU движок сообщает ошибку;
скрытого перехода на CPU нет.
Разработка и лицензия
python -m pip install -e '.[test,docs,release]'
pytest -q
python scripts/render_docs.py
python -m build
python -m twine check --strict dist/*
Как внести вклад · История версий · Сообщить о проблеме
Код распространяется по MIT. MLX, Textual и другие зависимости сохраняют свои лицензии и copyright notices: LICENSE, THIRD_PARTY_NOTICES.
1 maintainer

Metadata
1 maintainer
Release files for sloy-AI 0.2.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| sloy_ai-0.2.0.tar.gz | 938.8 kB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| sloy_ai-0.2.0-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 987.0 kB
Release files / sloy_ai-0.2.0.tar.gz
| Download URL | sloy_ai-0.2.0.tar.gz |
|---|---|
| Size | 938.8 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
ecc71f9dba7978849106389b16eb8425179db834e6ba1188eaaac4bb3e3458c8
|
|
BLAKE2b-256 checksum How to use checksums |
5cb844173b4a864b08c939672a15b2b0f09cdfb4c3176a5519d243ca62e7e113
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.13.5
|
Release files / sloy_ai-0.2.0-py3-none-any.whl
| Download URL | sloy_ai-0.2.0-py3-none-any.whl |
|---|---|
| Size | 48.2 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
c0665150503852d47cd4d27e8a966ed819921082cd58f562d64d690d3f8dedda
|
|
BLAKE2b-256 checksum How to use checksums |
78b23d6cc64e1d92db9d49a90b23048bf9444aad13281c2293674fd1c1e25708
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.13.5
|














