
Transformer Encoder

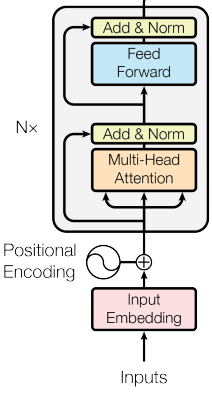
Examples
Quickstart
import torch
from transformer_encoder import TransformerEncoder
from transformer_encoder.utils import PositionalEncoding

# Model
encoder = TransformerEncoder(d_model=512, d_ff=2048, n_heads=8, n_layers=6, dropout=0.1)

# Input embeds
input_embeds = torch.nn.Embedding(num_embeddings=6, embedding_dim=512)
pe_embeds = PositionalEncoding(d_model=512, dropout=0.1, max_len=5)
encoder_input = torch.nn.Sequential(input_embeds, pe_embeds)

# Input data (zero-padding)
batch_seqs = torch.tensor([[1,2,3,4,5], [1,2,3,0,0]], dtype=torch.long)
mask = batch_seqs.ne(0)

# Run model
out = encoder(encoder_input(batch_seqs), mask)
Using the built-in warming up optimizer
import torch.optim as optim
from transformer_encoder.utils import WarmupOptimizer

model = ...

base_optimizer = optim.Adam(model.parameters(), lr=1e-3)
optimizer = WarmupOptimizer(base_optimizer, d_model=512, scale_factor=1, warmup_steps=100)

optimizer.zero_grad()
loss = ...
loss.backward()
optimizer.step()
Install from PyPI
Requires python 3.5+, pytorch 1.0.0+
pip install transformer_encoder
API
transformer_encoder.TransformerEncoder(d_model, d_ff, n_heads=1, n_layers=1, dropout=0.1)
d_model: dimension of each word vectord_ff: hidden dimension of feed forward layern_heads: number of heads in self-attention (defaults to 1)n_layers: number of stacked layers of encoder (defaults to 1)dropout: dropout rate (defaults to 0.1)
transformer_encoder.TransformerEncoder.forward(x, mask)
x (~torch.FloatTensor): shape (batch_size, max_seq_len, d_model)mask (~torch.ByteTensor): shape (batch_size, max_seq_len)
transformer_encoder.utils.PositionalEncoding(d_model, dropout=0.1, max_len=5000)
d_model: same as TransformerEncoderdropout: dropout rate (defaults to 0.1)max_len: max sequence length (defaults to 5000)
transformer_encoder.utils.PositionalEncoding.forward(x)
x (~torch.FloatTensor): shape (batch_size, max_seq_len, d_model)
transformer_encoder.utils.WarmupOptimizer(base_optimizer, d_model, scale_factor, warmup_steps)
base_optimizer (~torch.optim.Optimzier): e.g. adam optimzierd_model: equals d_model in TransformerEncoderscale_factor: scale factor of learning ratewarmup_steps: warming up steps
Contribution
Any contributions are welcome!
1 maintainer

Metadata
1 maintainer
Release files for transformer-encoder 0.0.3
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| transformer_encoder-0.0.3.tar.gz | 6.8 kB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| transformer_encoder-0.0.3-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 15.7 kB
Release files / transformer_encoder-0.0.3.tar.gz
| Download URL | transformer_encoder-0.0.3.tar.gz |
|---|---|
| Size | 6.8 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
df6151470817f153849043bee241b920163345364e3d621ab7d92087a071c55a
|
|
BLAKE2b-256 checksum How to use checksums |
68deaa92453adf1b2a4a94dc0c0fa4df70bdaecd3f0cfc0cb85814de287ef9c8
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/2.0.0 pkginfo/1.5.0.1 requests/2.24.0 setuptools/49.2.0.post20200714 requests-toolbelt/0.9.1 tqdm/4.47.0 CPython/3.8.3
|
Release files / transformer_encoder-0.0.3-py3-none-any.whl
| Download URL | transformer_encoder-0.0.3-py3-none-any.whl |
|---|---|
| Size | 9.0 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
8da07f3c35aab23c271b1f7e13dd6596cee4b32277b0bd0d3136293b2891d08c
|
|
BLAKE2b-256 checksum How to use checksums |
c739e957723b095616a72e974bf27d2365a5d7f17ee0254f6ec0b9e9c8bc1781
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/2.0.0 pkginfo/1.5.0.1 requests/2.24.0 setuptools/49.2.0.post20200714 requests-toolbelt/0.9.1 tqdm/4.47.0 CPython/3.8.3
|













