
local-delegate
Delega tareas mecánicas texto→texto a un LLM local para conservar la cuota de tu suscripción de Claude.
Un servidor MCP (stdio o daemon HTTP compartido) que es cliente genérico de cualquier
endpoint OpenAI-compatible — llama-swap, Ollama, LM Studio, vLLM.


zahirinatzuke.github.io/local-delegate — qué
hace y por qué, en una página (es/en). Su fuente está en site/.
Demo
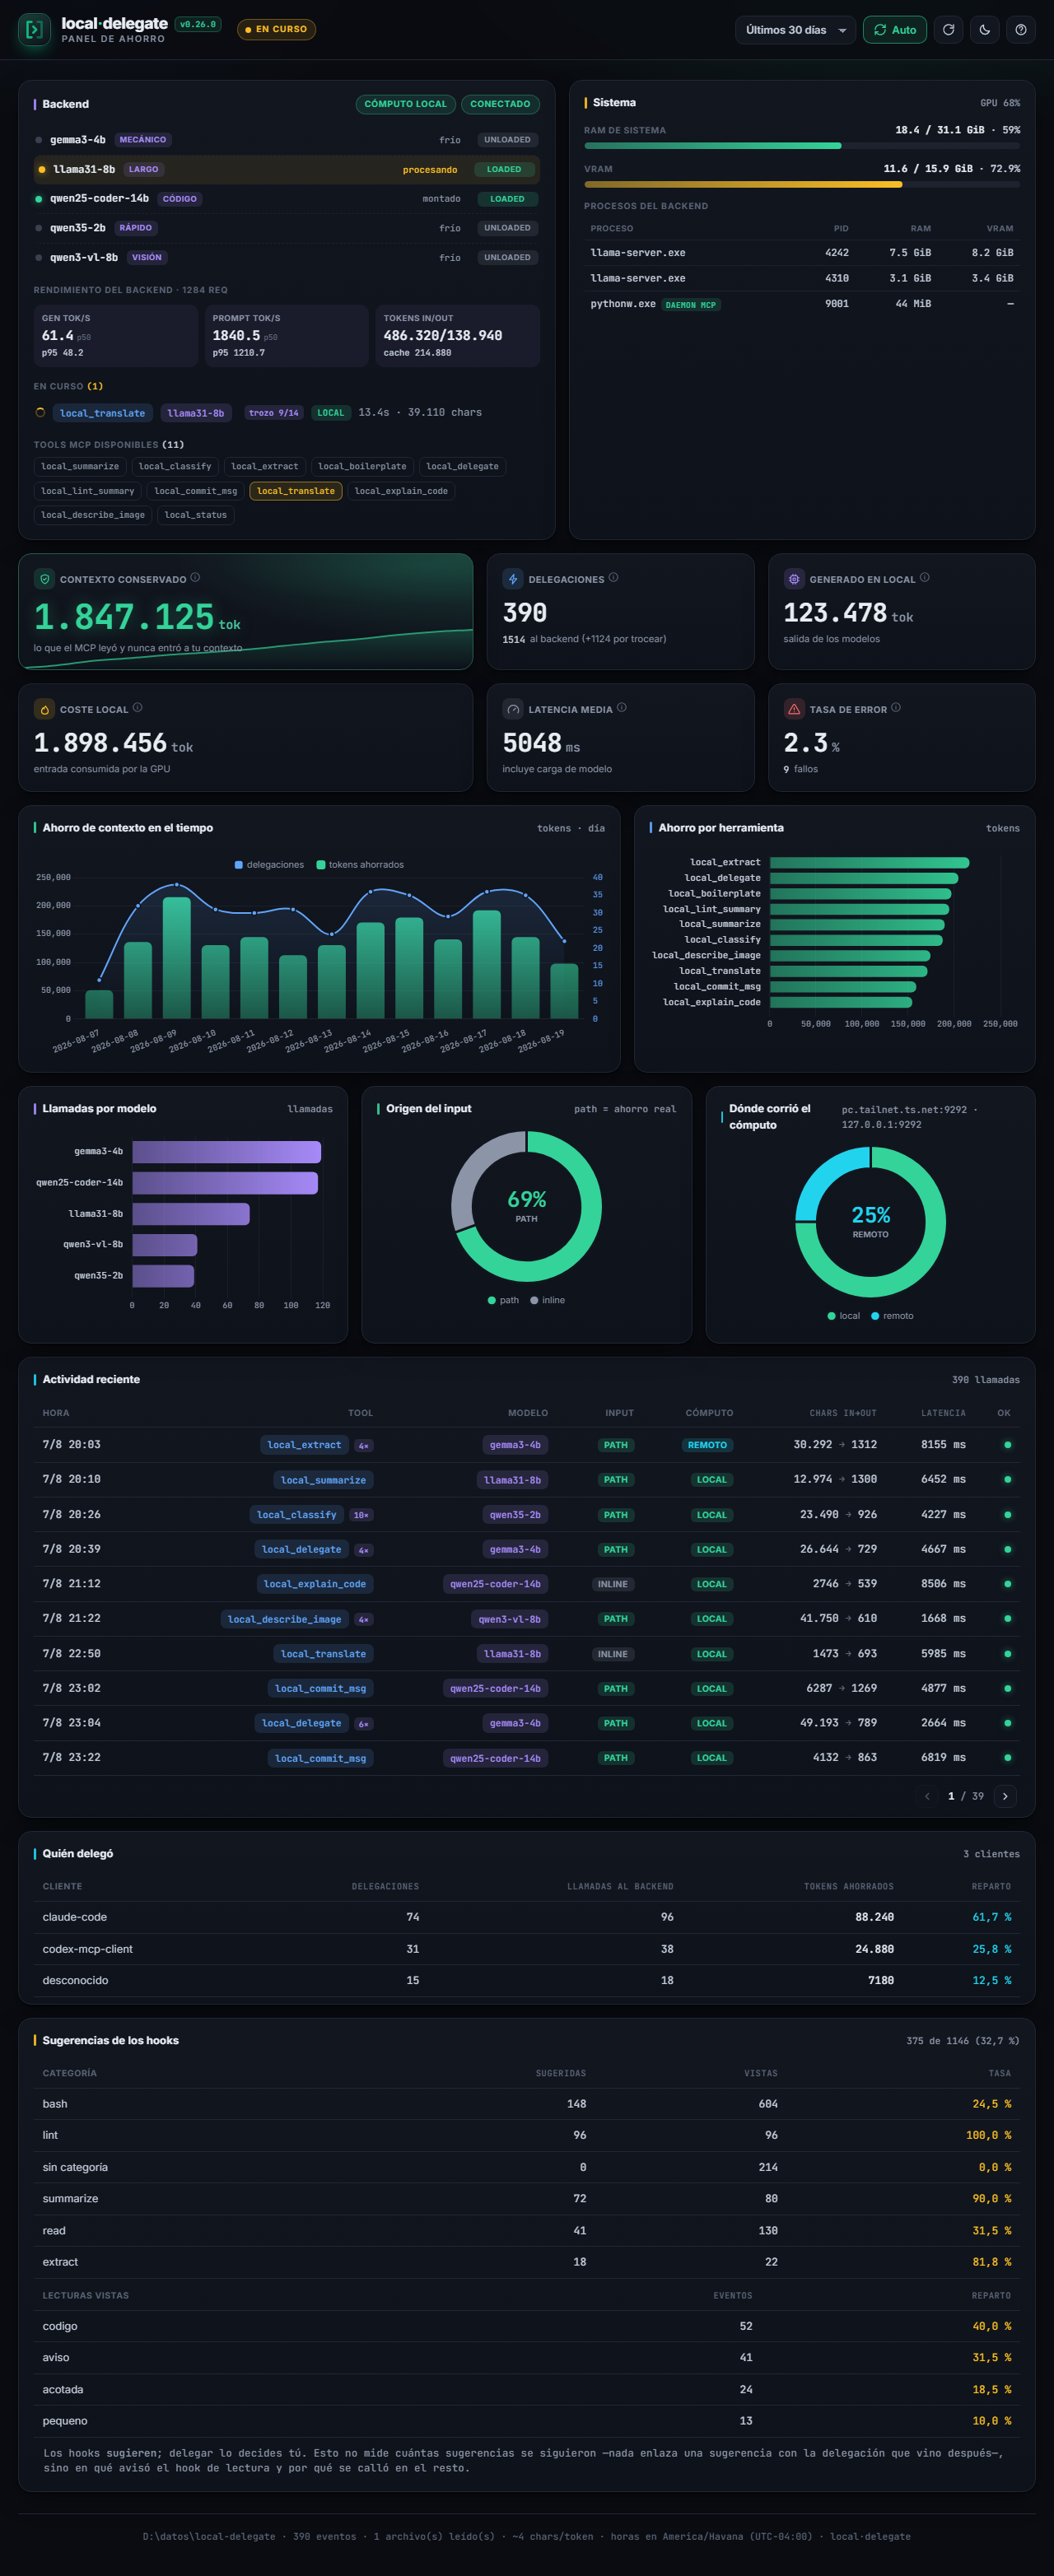
Dashboard embebido (datos de ejemplo): estado del backend local (modelos montados, delegación en curso con su progreso por trozos, tools MCP), RAM/VRAM del sistema con consumo por proceso, tokens de contexto conservados, ahorro por herramienta y modelo, dónde corrió el cómputo —esta máquina o un backend remoto— y actividad reciente paginada en tu hora local. Se sirve en http://127.0.0.1:9393.
¿Por qué?
Cuando Claude tiene que resumir un log enorme, clasificar, extraer campos o generar boilerplate,
gasta cuota de tu suscripción en trabajo mecánico. local-delegate expone esas tareas como
tools MCP que corren en un LLM local: pasas path en vez de text y el archivo se lee
del lado del servidor, así el contenido grande nunca entra al contexto de Claude. Solo
vuelve el resultado corto: el documento no ocupa tu ventana de contexto ni lo procesa Claude.
Instalación rápida
Con uv no hay nada que instalar: uvx baja y ejecuta el paquete aislado.
Añádelo a tu config de MCP (Claude Desktop / Claude Code) en modo compatible stdio:
{
  "mcpServers": {
    "local-delegate": {
      "command": "uvx",
      "args": ["local-delegate-mcp"]
    }
  }
}
Ver plantillas completas en examples/.
O deja que el paquete lo configure todo por ti —entrada MCP, hooks, skill y la regla de
delegación en tu CLAUDE.md/AGENTS.md global— con un solo comando:
uv tool install local-delegate-mcp          # deja `local-delegate` en el PATH
local-delegate install --dry-run            # muestra exactamente qué tocaría
local-delegate install                      # aplica
También sirve uvx local-delegate-mcp install para probarlo sin instalar nada, pero ten en cuenta
que uvx no deja el comando disponible: monta un entorno efímero y lo borra al terminar, así
que después local-delegate doctor responderá «command not found». El propio install te lo avisa
si detecta ese caso.
Es idempotente, deja .bak de lo que edita, no toca configuración ajena y se revierte con
local-delegate uninstall. Detalle y opciones en Instalación de la integración.
Si usas varias sesiones o varios clientes en la misma máquina, se recomienda un solo daemon:
uvx local-delegate-mcp serve
El daemon sirve MCP en http://127.0.0.1:9393/mcp y el dashboard en
http://127.0.0.1:9393/. Codex, Claude Code, opencode y cualquier cliente compatible con Streamable HTTP
pueden compartir esa URL sin levantar procesos MCP duplicados. Con un llama-swap local, el extra
[llamaswap] y LLAMASWAP_CONFIG apuntando a su config.yaml, el daemon además reparte el backend por turno:
dos delegaciones cuyos modelos se desalojarían entre sí no se pisan, y la segunda espera (el panel
lo enseña como espera local). Guía completa: Daemon compartido.
Una delegación puede sumar espera de turno e inferencia, y algunos clientes cortan antes: Codex
corta toda llamada a una tool MCP a los 60 s (tool_timeout_sec en [mcp_servers.local-delegate]
de config.toml lo sube, y hay que reponerlo tras cada install/update, que reescriben ese
bloque) y Claude Code corta una llamada HTTP tras 5 min sin respuesta (la variable
CLAUDE_CODE_MCP_TOOL_IDLE_TIMEOUT, en ms, lo sube y sobrevive a install). Detalle en
Instalación de la integración.
Para usar la GPU de otra máquina manteniendo los paths locales del cliente, usa un MCP local que apunte al backend remoto: guía Mac → PC y recipe técnica completa.
No fijes una versión vieja «por estabilidad». Un pin (
==X.Y.Z) congela también los rangos de dependencias que declaraba aquel wheel, y eso envejece mal: las versiones anteriores a la 0.12.2 pedíanmcpsin techo, así que hoy resuelven al SDK 2.x y mueren en el import. Si necesitas fijar, fija la actual, y súbela cuando salga una nueva.
En Windows, si lo registras como tarea al iniciar sesión, ejecuta el pythonw.exe del entorno
donde instalaste el paquete con -m local_delegate serve --log-level warning. pythonw no crea
consola ni botón en la barra de tareas. La tarea pertenece al usuario de Windows, no a Codex
ni a Claude: cualquier cliente local comparte el mismo daemon. El dashboard identifica ese único
proceso con la insignia DAEMON MCP; las sesiones conectadas son clientes HTTP, no procesos MCP
adicionales.
Requisitos
Python 3.11+ — con uvx no tienes que instalarlo tú, lo resuelve él; solo importa si instalas
con pip en un entorno propio.
Y un endpoint OpenAI-compatible ya corriendo, accesible en LOCAL_DELEGATE_BASE_URL
(default http://127.0.0.1:9292/v1). Cualquiera sirve:
- llama-swap — ver recipe con GPU Blackwell.
- Ollama —
http://127.0.0.1:11434/v1. - LM Studio, vLLM, o cualquier servidor que hable la API de OpenAI.
El paquete no arranca ningún backend por defecto (LOCAL_DELEGATE_AUTOSTART=0). El
auto-arranque de llama-swap es opt-in (ver tabla de configuración).
¿Qué versiones de llama-server/llama-swap usar y cómo disponer el workspace? Ver
Versiones del backend y workspace de referencia (sugerencia
probada, no requisito). local-delegate doctor compara tu instalación contra esas versiones y, de
paso, comprueba el resto del andamiaje —hooks, skill, memoria, entradas MCP y el daemon— sin
escribir nada (qué mira cada check).
Tools
Pasar path (en vez de text) hace que el MCP lea el archivo server-side: el contenido no entra
al contexto de Claude, y de ahí sale el ahorro.
| Tool | Qué hace | Rol de modelo (default) |
|---|---|---|
local_summarize |
Resume texto o archivo; focus opcional para decir qué conservar (p. ej. «cifras de configuración») |
mecánico / largo (auto) |
local_classify |
Devuelve UNA etiqueta de una lista | mecánico |
local_extract |
Extrae campos → objeto validado, no una cadena que haya que parsear | mecánico / largo (auto) |
local_boilerplate |
Genera código desde una spec y lo escribe en target; devuelve solo un recibo |
código |
local_delegate |
Escape genérico texto→texto | mecánico (o el que pases) |
local_lint_summary |
Resume logs de lint/tests/CI | mecánico / largo (auto) |
local_commit_msg |
Mensaje de commit desde un diff | código |
local_translate |
Traduce texto o archivo | mecánico / largo (auto) |
local_explain_code |
Explica código en prosa | código |
local_describe_image |
Describe una imagen o responde una pregunta sobre ella (imagen→texto) | visión |
local_status |
Diagnóstico de solo lectura: backend, catálogo, log, VRAM, RAM de sistema | — (no llama al backend de chat) |
Los modelos locales no usan tool-calling: el server arma el prompt + guardrails, hace POST al endpoint y devuelve solo texto.
Documentos largos. local_translate (y local_delegate con entradas largas) parten el texto
por límites naturales —headers Markdown, párrafos, líneas— y procesan un trozo por llamada
respetando el techo de max_tokens, concatenando las salidas en orden y conservando el formato en
las costuras. Un documento de 20 000+ caracteres vuelve completo en vez de cortado a mitad. El log
registra chunks: N y el dashboard muestra el progreso (trozo 3/7) mientras corre.
Resúmenes de documentos enormes. local_summarize y local_lint_summary hacen map-reduce
cuando la entrada no cabe en el modelo: resumen cada parte y luego resumen los resúmenes, por
niveles si hace falta. Antes truncaban —de un log de CI enorme se resumía el principio y el resto
se descartaba en silencio, que es justo donde suelen estar los errores— y ahora se lee entero. Si
algún trozo se corta por max_tokens, el resultado lo avisa y el log registra finish_reason: length.
local_extract sigue truncando a propósito: fusionar el JSON de varios trozos no tiene una
respuesta única y adivinarla sería peor que avisar.
Configuración
Todo por variables de entorno; nada hardcodeado. Los ids de modelo default son solo eso — cámbialos por los de tu backend.
| Variable | Default | Descripción |
|---|---|---|
LOCAL_DELEGATE_BASE_URL |
http://127.0.0.1:9292/v1 |
Endpoint OpenAI-compatible |
LOCAL_DELEGATE_API_KEY |
(vacío) | Bearer token, si tu endpoint lo exige |
LOCAL_DELEGATE_BACKEND_ORIGIN |
auto |
local/remote fuerzan el origen del cómputo; auto lo deduce del host. Ponlo si llegas al backend por un túnel (ssh -L, port-forward): en loopback se vería como local |
LOCAL_DELEGATE_TIMEOUT |
180 |
Timeout HTTP (segundos) |
LOCAL_DELEGATE_MAX_CONCURRENT_REQUESTS |
2 |
Backpressure máximo por proceso; compartido por todos los clientes del daemon |
LOCAL_DELEGATE_ASK |
1 |
Preguntar al usuario (vía elicitation) en vez de fallar seco: backend caído, modelo fuera del catálogo, output_format vacío. 0 lo desactiva |
LOCAL_DELEGATE_ASK_TIMEOUT |
30 |
Segundos de espera por una respuesta; agotados, la tool sigue como si no hubiera preguntado |
LOCAL_DELEGATE_LOG_DIR |
(dir de datos de usuario) | Directorio de los usage-YYYYMM.jsonl rotados por mes y del clients.jsonl |
LOCAL_DELEGATE_LOG |
(vacío = rotación activa) | Si se fija, ruta de un usage.jsonl explícito sin rotar (compatibilidad) |
LOCAL_DELEGATE_MODEL_MECHANICAL |
gemma3-4b |
Modelo para clasificar/extraer/resumen corto |
LOCAL_DELEGATE_MODEL_LONG |
gemma4-26b-a4b |
Modelo para documentos largos |
LOCAL_DELEGATE_MODEL_CODE |
qwen36-35b-a3b |
Modelo para código |
LOCAL_DELEGATE_MODEL_VISION |
gemma4-12b |
Modelo de visión para local_describe_image |
LOCAL_DELEGATE_MAX_IMAGE_MB |
8 |
Tope de tamaño de imagen para local_describe_image |
LOCAL_DELEGATE_LONG_INPUT_CHARS |
6000 |
Umbral mecánico↔largo |
LOCAL_DELEGATE_CHUNK_CHARS |
3500 |
Tamaño de trozo al partir documentos largos (local_translate, local_delegate) |
LOCAL_DELEGATE_CHUNK_MAX_TOKENS |
2048 |
Techo de max_tokens por trozo |
LOCAL_DELEGATE_CHUNK_MIN_CHARS |
400 |
Trozo mínimo: por debajo ya no se vuelve a partir |
LOCAL_DELEGATE_JSON_SCHEMA |
auto |
response_format con schema en local_extract: auto/on/off |
LOCAL_DELEGATE_FEEDBACK |
1 |
Línea de ahorro anexada al resultado cuando source=path (0 la apaga). En local_extract no se anexa al texto —rompería el JSON—: va dentro de _local_delegate |
LOCAL_DELEGATE_ALLOWED_DIRS |
(vacío = sin restricción) | Raíces permitidas para path, separadas por ; |
LOCAL_DELEGATE_WEB |
1 |
Web embebida del modo stdio (0 para desactivarla) |
LOCAL_DELEGATE_WEB_HOST / _PORT |
127.0.0.1 / 9393 |
Host/puerto de la web o del daemon |
LOCAL_DELEGATE_WEB_FONTS |
1 |
Tipografía de marca desde Google Fonts (0 = cero peticiones a terceros) |
LOCAL_DELEGATE_AUTOSTART |
0 |
Auto-arranque de llama-swap (opt-in) |
LLAMASWAP_EXE / LLAMASWAP_CONFIG / LLAMASWAP_LISTEN |
— | Solo si AUTOSTART=1; LLAMASWAP_CONFIG además activa el turno y la afinidad del daemon (con el extra [llamaswap]) |
LLAMASWAP_WATCH_CONFIG |
0 |
1 añade -watch-config al backend autoarrancado |
LOCAL_DELEGATE_FALLBACK |
1 |
Respaldo entre modelos: si el modelo de un rol falla por su culpa, responde el siguiente de su cadena (_MAX_HOPS=2; cadenas con _<ROL>, ver la wiki). 0 lo apaga |
LOCAL_DELEGATE_COOLDOWN |
1 |
Enfriamiento por modelo: 3 fallos seguidos (_FAILURES) lo paran 120 s (_S), doblando hasta 900 s (_MAX_S). 0 lo apaga |
LOCAL_DELEGATE_COSTE_RESPALDO |
(vacío = claude-opus-5-5 en subagente) |
Con qué modelo e hilo se valora una delegación sin modelo atribuido: modelo o modelo:main|subagent. Un valor inválido no rompe nada: el panel usa el declarado y lo dice |
LOCAL_DELEGATE_COMMIT_LANGUAGE |
(vacío = el idioma del diff) | Idioma del mensaje de local_commit_msg: es, en, fr, pt, de, it o un nombre libre. Vacío: el idioma predominante de los textos del diff |
LOCAL_DELEGATE_TURN_MAX_S |
600 |
Turno del daemon entre modelos que chocan en llama-swap: si la primera de la cola lleva estos segundos esperando y el daemon lleva otros tantos sin que empiece ni termine ninguna llamada al backend, se le concede el turno igual (turn: "forced" en el log) |
LOCAL_DELEGATE_SLOW_THRESHOLD |
0.5 |
Una llamada es «lenta» (slow en el log, «lento ×0,37» en el panel) si genera a menos de esta fracción de la velocidad normal de su modelo |
LOCAL_DELEGATE_AFFINITY_MARGIN_S |
5 |
Afinidad: un modelo ya cargado solo se aprovecha si le quedan al menos estos segundos de TTL |
La métrica de ahorro
El MCP registra cada llamada en un log rotado por mes y sirve un dashboard en
http://127.0.0.1:9393, con selector de rango y visibilidad de delegaciones en curso.
El contexto conservado = la entrada leída server-side (llamadas con source=path que salieron
bien) menos lo que la tool te devolvió, contada una vez por delegación aunque el MCP la trocee.
Se mide en caracteres y se pasa a tokens de Claude con una tabla de densidad medida por familia
de tokenizador y tipo de contenido (prosa, código, log, datos estructurados, diff): un .md no
cuenta lo mismo que un .json, y Haiku 4.5 no cuenta como Opus 5.5. Las imágenes salen de esa
cifra —sin sus dimensiones no hay forma de saber cuántos tokens le costarían a Claude— y se enseñan
aparte. Enfrente, el coste local = los tokens que consumió de verdad tu GPU sumando todas las
llamadas: una delegación troceada repite el prompt de sistema en cada trozo, y esa diferencia es lo
que costó trocear. Ahí se usa el token real que reporta el backend; chars ÷ 4 es solo el respaldo
del modelo local cuando no lo da. Detalle en la wiki.
El panel enseña además un equivalente estimado a precio de API: lo que costaría ese mismo
contexto leído por Claude a precio de lista, entre una cota baja y una estimación que cuenta las
peticiones en las que ese contenido se habría vuelto a leer de la caché. No es dinero que hayas
ahorrado: tu suscripción es de tarifa plana. Es una estimación con supuestos a la vista (con qué
modelo se atribuye cada delegación, cuántas peticiones siguieron, qué densidad se usó) y no
descuenta las relecturas del mismo fichero. Junto a ella, un bloque de cuota que sale «sin
calibrar» hasta que hay al menos tres medidas del statusline de ventanas distintas, y nunca enseña
un porcentaje sin esa calibración. Para atribuir el histórico y alimentar esos dos bloques, lanza
de vez en cuando local-delegate recalcular-coste (lee tus transcripts en local y escribe solo
agregados); doctor avisa si hay delegaciones a punto de quedarse sin transcript.
Las pruebas no cuentan: las delegaciones del cliente mcp de los scripts, las de bancos y
las que caen en una ventana de prueba se apartan del panel y de local_status. Antes de probar
en vivo contra el MCP o el daemon, marca el intervalo y guarda el id que imprime:
local-delegate test-window start --label "prueba del lunes"   # imprime el id
local-delegate test-window stop <id>
local-delegate test-window list                               # ventanas y filas en cada una
El botón Pruebas de la barra del panel las vuelve a enseñar; su ⓘ dice cuántas quedaron fuera.
Los rangos, los días del gráfico y las horas de la tabla usan tu zona horaria (el log se
escribe en UTC, que es un instante sin ambigüedad; la conversión es de presentación). El
dashboard también separa dónde corrió el cómputo: local si el backend escucha en loopback,
remote si la inferencia se fue a otra máquina —por ejemplo esta Mac usando la GPU de la PC—.
Los eventos anteriores a la v0.11.0 no traen el campo y aparecen como n/d.
Alcance / no-objetivos
local-delegate es deliberadamente texto/imagen→texto: arma el prompt (o el payload
multimodal), hace POST a /chat/completions y devuelve solo texto. Cosas que no hace
a propósito:
- Tool-calling local. Los modelos locales no invocan herramientas ni ejecutan código; eso lo sigue haciendo Claude. Añadirlo convertiría este paquete en un orquestador paralelo, que no es el objetivo.
- Generación o edición de imágenes.
local_describe_imagees solo imagen→texto (describir, leer texto visible, responder una pregunta puntual); nada de generar ni editar imágenes. - Audio. Para transcripción usa el companion
whisper-transcribe-mcpen vez de intentar meter audio aquí. - Sustituir la suscripción. El objetivo es conservar cuota delegando pasos mecánicos acotados, no enrutar todo el trabajo a modelos locales.
Integración con el cliente: hooks, skill y memoria
local-delegate install deja lista la integración completa en tu HOME:
| Componente | Dónde | Qué hace |
|---|---|---|
| Entrada MCP | config de Claude Code / ~/.codex/config.toml / ~/.config/opencode/opencode.json[c] |
registra el servidor (stdio con uvx o HTTP contra el daemon) |
| Hooks | ~/.claude/hooks/local-delegate/ + settings.json |
sugieren delegar; los de lectura además pueden rechazar una lectura completa de documentación, si se enciende; uno anota qué agente pidió cada delegación |
| Skill | ~/.claude/skills/delegacion-local/ y ~/.config/opencode/skill/delegacion-local/ |
regla de oro y catálogo de tools |
| Memoria | bloque gestionado en ~/.claude/CLAUDE.md, ~/.codex/AGENTS.md y ~/.config/opencode/AGENTS.md |
la regla en una nota corta siempre cargada |
Por defecto se configuran solo los clientes que tengas instalados; se elige a mano con
--clients claude|codex|opencode. Los hooks son solo de Claude Code: opencode extiende con
plugins en TypeScript, que es otra superficie, y Claude Desktop no tiene hooks en absoluto. Cada
pieza se puede excluir (--no-hooks, --no-skill, --no-memory, --no-mcp).
Se instalan solos dos hooks: UserPromptSubmit (intenciones mecánicas) y anotar_llamada.py
(PreToolUse sobre las tools de local-delegate), que no avisa ni bloquea: anota qué agente pidió
cada delegación y con qué esfuerzo, para atribuir el coste equivalente a su modelo. Los dos de
lectura —PreToolUse/Read y PreToolUse/Bash|PowerShell— quedan apagados salvo
--enable-read-hook, que los registra y los enciende juntos (uninstall los apaga). Van juntos
porque son una regla sola sobre dos caminos: cerrar la tool Read y dejar cat informe.md
abierto no cambia la conducta, la muda de sitio.
Esos dos avisan; rechazar una lectura es otra cosa y viene aparte y apagada
(LD_HOOK_READ_BLOQUEAR). Solo alcanza a la lectura completa de un .md o un .txt grande, con
el backend local respondiendo, y el mensaje del rechazo nombra la tool que sirve y la salida de
emergencia: leer por franjas nunca se bloquea. El motivo de que exista es que está medido —cuatro
veces— que sugerir no cambia la conducta.
Ver Instalación de la integración y
docs/recipes/claude-code-hooks.md.
Groups de llama-swap (opcional)
Con pip install "local-delegate-mcp[llamaswap]" quedan disponibles los CLIs para gestionar
groups de llama-swap (un pool que se turna y, solo si lo pides, un modelo que se queda
cargado) con guardrail de VRAM y RAM de sistema incorporado (--ram-gb es opcional: llama-server
mapea el GGUF también en RAM aunque el cómputo sea 100% GPU, así que un catálogo que cabe en
VRAM puede igual agotar la RAM en máquinas con menos de 32 GB):
local-delegate check-llamaswap --config config.yaml --vram-gb 16 --ram-gb 32
local-delegate init-llamaswap --config config.yaml --swap gemma3-4b,gemma4-26b-a4b,qwen36-35b-a3b --vram-gb 16 --ram-gb 32
local-delegate llamaswap residency            # qué se queda cargado y con qué TTL; no escribe
local-delegate llamaswap residency --none --ttl gemma3-4b=120   # volver a «ningún residente»
Lo recomendado es ningún residente: con el turno del daemon, los modelos que chocan se
reparten el backend sin pelearse, y un modelo ya cargado se aprovecha cuando hay una celda
aprobada para esa tool (ver Tools). La residencia es opt-in:
init-llamaswap --resident ID o llamaswap residency --pin ID dejan ese modelo en un grupo
persistent con ttl: 0, y retiene su VRAM de forma permanente (--pin pide la VRAM medida de
cada modelo con --vram-model ID=GiB y se niega si no cabe junto al peor caso del resto). --ttl-resident vale 0 por defecto: con persistent y un TTL
mayor que 0 el modelo se descarga igual y no hay residencia de verdad.
El paquete nunca toca tu config.yaml por su cuenta — estos comandos solo corren si vos
los invocás. init-llamaswap corre el/los guardrail(es) antes de escribir (no escribe nada si
no cabe en VRAM o, si pasaste --ram-gb, en RAM) y nunca sobreescribe sin --force (dejando
una copia <config>.<AAAAMMDD-HHMMSS>.bak). llamaswap residency edita solo las líneas que
cambian, deja la misma copia con fecha, no escribe con delegaciones en curso (salvo --now) y
dice qué hizo llama-swap con la recarga. Detalle completo, semántica de groups verificada contra el código de llama-swap, y
ritual de aplicación en docs/recipes/llama-swap-groups.md.
Enlaces
1 maintainer

Metadata
1 maintainer
Release files for local-delegate-mcp 0.34.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| local_delegate_mcp-0.34.0.tar.gz | 4.9 MB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| local_delegate_mcp-0.34.0-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 5.4 MB
Release files / local_delegate_mcp-0.34.0.tar.gz
| Download URL | local_delegate_mcp-0.34.0.tar.gz |
|---|---|
| Size | 4.9 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
7cf8aaea964407082afd6456a06e33ffbdaff6d0954ffb44285745885281fd9b
|
|
BLAKE2b-256 checksum How to use checksums |
3ff1f0c8b7b81609418c434a0cc1fd0687bb7429cb390a3a3cc746e0eacbcaf3
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
uv/0.12.23 {"installer":{"name":"uv","version":"0.12.23","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
|
Release files / local_delegate_mcp-0.34.0-py3-none-any.whl
| Download URL | local_delegate_mcp-0.34.0-py3-none-any.whl |
|---|---|
| Size | 491.2 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
8a65f3135107407f8fbbed8ba069d3f74a4e88dcad7f7f2891c56b8fd4f1d243
|
|
BLAKE2b-256 checksum How to use checksums |
8a2e5f1e799f4135792145ba74b790d84e4410727042638023cd180aa303fdbc
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
uv/0.12.23 {"installer":{"name":"uv","version":"0.12.23","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
|














