



OneCDC is a Python library and Docker image for loading 1C:Enterprise data into PostgreSQL using Change Data Capture (CDC).
It uses the standard OData interface and exchange plans to read changes and update the target database.
OneCDC — Python-библиотека и Docker-образ для загрузки данных из 1С в PostgreSQL по принципу CDC (Change Data Capture — получение изменений данных).
Для чтения изменений используются стандартный интерфейс OData и механизм планов обмена 1С.
Общий принцип действия
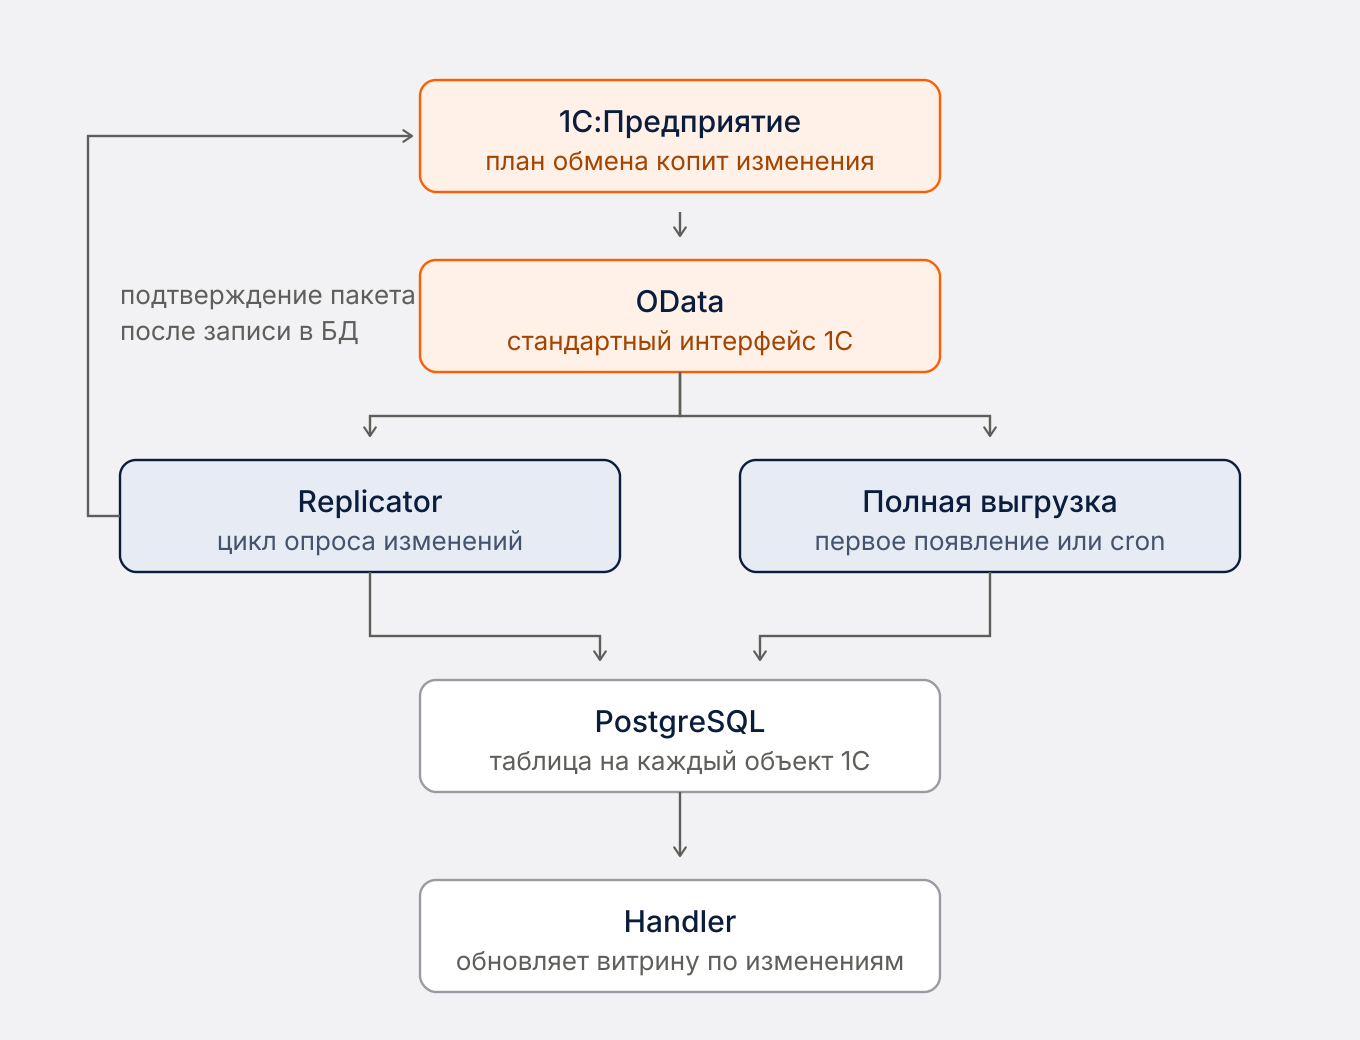
- Основной класс библиотеки —
Replicator. Он циклически читает изменения из 1С через OData и план обмена, записывает их в PostgreSQL и подтверждает приём пакета после сохранения поддерживаемых объектов. - Для каждого регистра, справочника, документа и каждой табличной части создаётся отдельная таблица. Структура следует метаданным OData, а имена таблиц и колонок транслитерируются.
- К загруженным таблицам можно обращаться напрямую или строить над ними витрины. Обработчики (handlers) запускают ваш Python-код при изменении данных. Например, обработчик может обновлять витрину по представлению (view), пересчитывая только затронутые записи. Готовые примеры приведены ниже.
Что нужно для работы
- Опубликовать базу 1С на веб-сервере и открыть стандартный интерфейс OData.
- Настроить план обмена в конфигураторе и включить в него нужные поддерживаемые объекты.
- Создать пользователя OData с правами чтения загружаемых объектов, чтения и изменения плана обмена.
- Дать пользователям, записывающим объекты, право чтения плана обмена, чтобы регистрация изменений не приводила к ошибкам.
- Создать узел обмена с помощью внешней обработки onecdc.epf и включить план и его объекты в состав OData.
- Запустить загрузку Docker-образом
sobolevp/onecdcили Python-библиотекойonecdc— оба варианта описаны ниже.
Использование библиотеки Python
Установка
pip install "onecdc[postgres]"
Целевая СУБД — PostgreSQL. Для записи используется библиотека dbmerge. OneCDC создаёт схемы, таблицы и колонки автоматически; пользователю БД нужны соответствующие права. Требуется Python 3.10 или новее.
Требования к ресурсам
Ориентир для начала — 4 ГБ оперативной памяти на процесс.
Потребление памяти зависит от размера пакета изменений. 1С формирует ответ SelectChanges
целиком в памяти рабочего процесса, игнорируя параметры $top/$filter. При обработке ответа
OneCDC одновременно хранит его тело, текст, дерево разбора и данные для записи. В одном из замеров 28 МБ ответа дали 102 МБ пиковых выделений памяти.
Учитывайте также параллельные полные выгрузки и обработчики: 4 ГБ не гарантируют достаточный запас.
Размер принимаемого ответа ограничен: по умолчанию 512 МиБ, параметр
Replicator(max_response_bytes=...). Ответ крупнее не принимается — соединение обрывается, пакет
не подтверждается. В журнал записывается ERROR с размером из заголовка или числом уже принятых байт.
Пакет остаётся в очереди 1С, поэтому повторный запрос даст тот же результат. Перед повтором цикл
увеличивает паузу; фоновые выгрузки и обработчики могут продолжать работу.
Чтобы уменьшить будущие пакеты, настройте дроссель на стороне 1С: он ограничивает число объектов, регистрируемых в очереди за раз (см. Большие объёмы изменений и
распределение нагрузки).
max_response_bytes=None отключает ограничение размера ответа. Выбирайте это значение с учётом
доступной памяти и размера пакетов.
from sqlalchemy import create_engine
from onecdc import Replicator

# Максимум соединений основного пула — pool_size + max_overflow. Задавайте оба параметра:
# неявный max_overflow=10 увеличит выбранный предел на десять соединений.
# См. README_DB.md, «Сколько нужно соединений к БД».
engine = create_engine("postgresql+psycopg2://user:pass@localhost:5432/onecdc",
                       pool_size=3,
                       max_overflow=2,          # запас для двух потоков полной выгрузки
                       pool_pre_ping=True)      # проверять соединение перед использованием

rep = Replicator(
    odata_url="http://host/base/odata/standard.odata",
    odata_auth=("odata", "secret"),        # (user, password); None — 1С без авторизации
    engine=engine,
    exchange_name="ВашПланОбмена",         # имя плана обмена в 1С
    queue_guid="aaaaaaaa-aaaa-aaaa-aaaa-aaaaaaaaaaaa",  # Ref_Key узла обмена
    db_schema="onecdc",                    # None → схема БД по умолчанию (public у Postgres)
    request_timeout=60,                    # таймаут HTTP-запросов к 1С, сек (по умолчанию 60 на коннект, 900 на ответ)
    full_load_workers=2,                   # число фоновых потоков полной выгрузки
    automatic_full_load=True,              # ставить новые объекты на полную выгрузку самому
    log_retention_days=30,                 # срок хранения журнала загрузок; 0 — хранить всё
)

rep.run_forever(interval=60)               # пауза 60 секунд между успешными циклами
План обмена и узел нужны только для чтения изменений. Если репликатор используется только для полной
выгрузки (разовой или по расписанию), эти параметры можно не задавать — full_load читает объект
прямо из OData; run_forever/run_once у такого репликатора откажутся стартовать.
Примеры целиком
| файл | о чём |
|---|---|
| examples/replicate_forever.py | непрерывная репликация: один процесс, один цикл, без Docker и собственного пула потоков — то же, что выше, но готовое к запуску |
| examples/full_load_once.py | разовая полная выгрузка одного объекта: первая загрузка, добор истории, пересборка после нового реквизита |
| config/runner.py | многопоточный запуск: несколько обработчиков витрин, полные выгрузки по расписанию, несколько планов обмена в одном процессе |
Запуск в Docker
docker run --rm --network host \
  -e ONECDC_ODATA_URL="http://server/base/odata/standard.odata" \
  -e ONECDC_ODATA_USER=odata -e ONECDC_ODATA_PASSWORD=secret \
  -e ONECDC_EXCHANGE_NAME="ВашПланОбмена" \
  -e ONECDC_QUEUE_GUID="aaaaaaaa-aaaa-aaaa-aaaa-aaaaaaaaaaaa" \
  -e ONECDC_DB_URL="postgresql+psycopg2://user:pass@database_host:5432/cdc" \
  -e ONECDC_DB_SCHEMA=onecdc -e ONECDC_DB_TEMP_SCHEMA=onecdc_tmp \
  -v "$PWD/config:/config:ro" \
  sobolevp/onecdc:latest
-v "$PWD/config:/config:ro" — монтирует папку config из текущего каталога. В ней лежит файл runner.py, а также подпапка с примерами обработчиков (config/handlers).
docker compose. Пример — docker-compose.yml в репозитории.
Запуск из окружения
Для запуска из окружения Python используйте python -m onecdc или команду
onecdc. Параметры читаются из переменных окружения, описанных в README_ENV.md
Как узнать GUID узла обмена
queue_guid — это Ref_Key узла плана обмена, того самого, на который 1С регистрирует изменения
(ЭтотУзел не подходит: он описывает саму базу-источник).
Создать узел обмена и узнать его Ref_Key можно во внешней обработке
onecdc.epf.
Ещё один вариант: оставьте параметр пустым (queue_guid="", или просто не задавайте
ONECDC_QUEUE_GUID) и запустите — чтение изменений выведет в лог список узлов плана обмена и
завершит цикл с ошибкой. В режиме run_forever попытки повторяются; после получения GUID остановите процесс и задайте узел.
ERROR onecdc.change_reader: queue_guid is not set. Available nodes of exchange plan ДляODATA:
    a9bc23c5-3689-11f1-926c-0800270bc6cb  CDC  Витрина
GUID из первой колонки и есть искомый queue_guid.
Режимы: run_once и run_forever
rep.run_once()                 # один цикл: read → save → notify (подтверждение только после save)
rep.run_forever(interval=60)   # основной режим: непрерывный цикл run_once с паузой; фоном — полные выгрузки
run_once(notify_changes=False)— не подтверждать приём (пакет останется в очереди 1С; сделано для отладки).run_forever(interval, max_iterations=0)—max_iterations>0ограничивает число итераций.
Полная (первоначальная) выгрузка
При работе run_forever объекты, впервые встреченные в пакете изменений, автоматически ставятся в
очередь на полную выгрузку и грузятся фоновыми потоками. Управляет этим параметр
automatic_full_load (по умолчанию True).
- Чтобы назначить выгрузку вручную, установите
full_load_is_required=trueв таблицеonecdc_metadata_objects. Фоновые потоки подхватят объект на следующем цикле — в том числе приautomatic_full_load=False. - Полная выгрузка спроектирована так, чтобы работать параллельно с получением изменений объекта и не затирать свежие изменения объекта. При наличии подходящего поля даты большой объект разбивается на периоды и выгружается порциями, размер которых подбирается автоматически (batch_size).
- Есть возможность инициировать полную выгрузку и на стороне 1С — обработкой
onecdc.epfзарегистрировать все изменения объекта в узле обмена. Но тогда объект поступит одним пакетомSelectChanges, а его платформа целиком держит в памяти рабочего процесса, поэтому так рекомендуется делать только вместе с «дросселем» (см. Большие объёмы изменений и распределение нагрузки). В этом случае поставьтеautomatic_full_load=False, иначе репликатор запросит ту же выгрузку второй раз.
Какие объекты 1С поддерживаются
В план обмена можно включать:
| Класс объекта 1С | |
|---|---|
| справочники | вместе с табличными частями |
| документы | вместе с табличными частями |
| регистры сведений | подчинённые регистратору |
| регистры накопления | |
| регистры бухгалтерии | без субконто, см. ниже |
Всё остальное не поддерживается — константы, регистры расчёта, планы видов характеристик,
планы счетов, планы видов расчёта, бизнес-процессы, задачи. Не включайте их в план обмена: их
изменения будут потеряны безвозвратно, потому что пакет подтверждается целиком и 1С их больше не
пришлёт. В логе это видно как ERROR со словами CHANGES LOST.
Независимые регистры сведений (без регистратора) SelectChanges не возвращает. Для них
доступна только полная выгрузка, в том числе по расписанию.
Субконто регистра бухгалтерии не выгружаются. Движения регистра приезжают полностью, но без
аналитики: в описании движения субконто нет, а единственный их источник — виртуальная таблица
RecordsWithExtDimensions, которую нельзя листать. Её нельзя адресовать ни по регистратору
(проверено на живой 1С: guid'ом — ошибка 500, строкой — пустой ответ при существующем
регистраторе), ни страницами ($skip отвергается, Top отдаёт произвольное подмножество).
Остаётся перечисление периодов, а это не масштабируется: один плотный период — один неразрывный
запрос на все его строки во всей базе.
Те же аналитические разрезы обычно проще взять из документа-регистратора. Если субконто нужны именно из регистра — их придётся добирать своими силами на стороне 1С.
Если вы грузили субконто прежними версиями, колонки ExtDimensionsDr и ExtDimensionsCr
останутся в таблице со старыми значениями: библиотека колонки не удаляет и больше их не обновляет.
Удалять или нет — решать вам.
Что появляется в целевой БД
На каждый объект 1С заводится своя таблица: имя транслитерируется, к полям добавляются служебные
(merged_on, inserted_on, is_deleted_or_empty, exchange_message_no). Схемы, таблицы и новые
колонки библиотека создаёт сама. Рядом появляются служебные таблицы, по которым видно состояние
загрузки: журнал onecdc_replicator_log, реестр объектов onecdc_metadata_objects, состояние обработчиков
onecdc_handlers, реестр незавершённых записей onecdc_writes_in_process, реестр имён
таблиц и колонок onecdc_name_claims и реестр читателей узлов обмена onecdc_exchange_nodes.
Журнал загрузок растёт быстро — строка на объект на пакет, то есть миллионы строк в год, — поэтому
у него есть срок хранения: log_retention_days (по умолчанию 30 суток, 0 — хранить всё). Уборка
идёт сама, раз в сутки на процесс.
Подробно — README_DB.md: состав полей, что означает is_deleted_or_empty и что лежит в каждой служебной таблице.
Если в 1С поменяли тип поля
При смене типа поля в 1С библиотека сохраняет прежние данные под другим именем и создаёт новую колонку или таблицу. Это позволяет избежать неоднозначного преобразования, например из произвольной строки в ссылку.
| что поменялось | что произойдёт |
|---|---|
| обычное поле | колонка переименуется в Поле_Old_<хэш>, рядом появится новая, нужного типа |
| поле, входящее в ключ | переименуется вся таблица — в Таблица_Old_<хэш>, рядом появится новая |
Затем объекту назначается полная выгрузка, чтобы загрузить исторические данные в новую колонку или таблицу. Если автоматические
выгрузки выключены (automatic_full_load=False), выгрузка не назначается — новая колонка или таблица
будет наполняться только текущими изменениями, без истории; запустите full_load сами, когда
удобно.
Если тип колонки задали вы сами (например сузили varchar до varchar(50) или указали точность
numeric), это сменой типа не считается и колонку библиотека не тронет.
Классы библиотеки
Replicator читает изменения и записывает их в БД. Handler и HandlerLoop запускают ваш код
при изменении данных, а FullLoadCron выполняет полную выгрузку по расписанию.
Параметры и методы этих классов описаны в README_API.md.
Логирование
Библиотека использует стандартный модуль logging. Если приложение ещё не настроило вывод,
OneCDC добавляет обработчик к логгеру onecdc с уровнем INFO.
Шум со стороны 1С
1С регистрирует изменения при каждой записи объекта, даже если его реквизиты остались прежними. Изменение только DataVersion и номера пакета обычно не вызывает обновления строки: merged_on остаётся прежним, и обработчики не пересчитывают те же данные. Исключение — объект под полной выгрузкой: в это время отметка обновляется при каждом пакете, чтобы защитить свежие данные от записи устаревшей страницы.
Большие объёмы изменений и распределение нагрузки
Если изменений много и один репликатор не справляется, нагрузку можно распределить тремя способами:
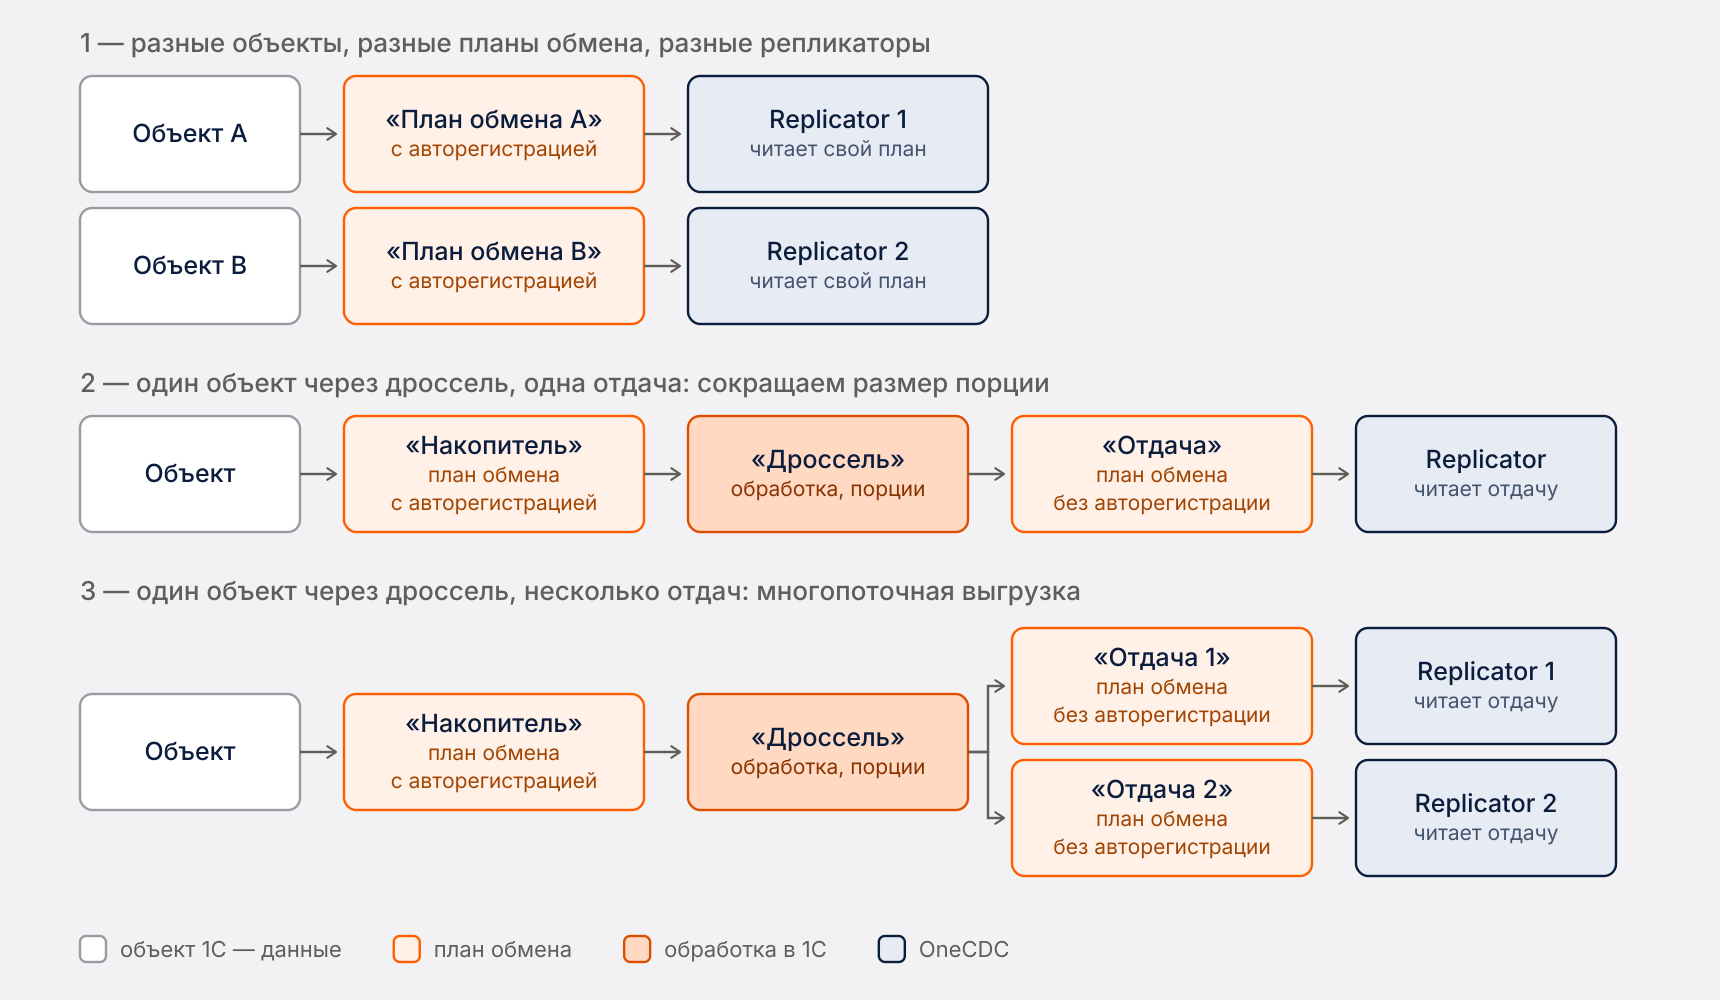
- Разные объекты 1С — в разные планы обмена. Каждый план читает свой репликатор; репликаторы можно развести по машинам или запустить в одном многопоточном скрипте.
- Один объект — через «дроссель»: он дозирует изменения, чтобы пакет в SelectChanges не разрастался (см. ниже).
- Тот же дроссель, но с несколькими планами-отдачами: один объект читают несколько репликаторов параллельно.
Метод SelectChanges в OData, к сожалению, не умеет отдавать изменения постранично: платформа
формирует весь пакет в памяти рабочего процесса, а $top / $select / $filter игнорирует.
Ограничить размер пакета со стороны клиента нечем — это делается на стороне 1С, регистрацией
изменений. Готовый общий модуль («дроссель») лежит в репозитории:
onecdc-throttle-module.bsl
Репликатор читает SelectChanges из отдачи, поэтому число регистраций в пакете ограничивается настройками дросселя. Размер в байтах зависит от самих объектов.
Планов-отдач может быть несколько: они наполняются по порядку. Следующий план получает изменения,
когда предыдущий достиг своего лимита. На каждую отдачу поднимается свой Replicator — так получение
изменений идёт в несколько потоков.
Настройка модуля «Дроссель»:
- Настроить план обмена «Накопитель» — с авторегистрацией изменений ваших объектов.
- Настроить один или несколько планов обмена «Отдача» — с отключённой авторегистрацией: единственный, кто в них регистрирует, — дроссель.
- Создать в конфигураторе общий модуль (раздел «Общие модули») и вставить в него код onecdc-throttle-module.bsl.
- В процедуре
ЗапуститьПеренос1()указать имя плана-накопителя и имена одного или нескольких планов-отдач. Саму процедуру можно назвать по своему усмотрению. - Создать регламентное задание, которое её вызывает: оно и будет периодически переносить изменения из накопителя в отдачи.
Разбор устройства дросселя — в DESIGN.md.
Сколько процессов запускать
Один узел обмена читает один репликатор, один обработчик исполняет один процесс. Это и есть схема запуска: параллельное чтение одного узла удваивает нагрузку на 1С и может привести к потере изменений, а параллельный расчёт одной витрины — к замене актуального результата устаревшим.
Это правило поддерживается арендой в БД. Перед работой процесс захватывает узел обмена и имя обработчика, а пока жив, подтверждает захват отметкой живости. Поэтому:
- второй контейнер с той же целевой схемой ожидает освобождения узла и имён обработчиков;
- после аварийной остановки первого процесса второй сможет продолжить работу после истечения 15 минут с последней отметки (отметка живости перестала
обновляться). При штатной остановке (
SIGTERM) захват освобождается при завершении работы; - полные выгрузки при этом делятся: объекты захватываются поштучно, так что «лишний» процесс может обрабатывать очередь полных выгрузок вместе с первым. Ограничения аренды описаны в DESIGN.md.
Дальнейшая обработка и материализация
1С хранит данные нормализованно: чтобы получить код товара по записи регистра, нужен JOIN со
справочником по GUID. Для корпоративного хранилища данных (КХД) обычно удобнее менее строгая нормализация — витрины, собранные
заранее.
Витрины можно обновлять по мере изменения данных: репликатор передаёт сигнал, по которому
цикл обработчика вызывает ваш код. Такой код называется обработчиком — это класс с подпиской на таблицы и методом handle:
from onecdc import Handler, HandlerContext

class ZakazyKlientov(Handler):
    ON = ["AccumulationRegister_ZakazyKlientov"]   # имена ТАБЛИЦ в БД, не объектов 1С

    def handle(self, context: HandlerContext) -> None:
        self.execute(context, "insert into ... where merged_on > :last_run_at",
                     last_run_at=context.last_run_at)
Тем же способом изменения отправляют во внешнюю систему — очередь, вебхук, другую БД. Обработчик-отправщик сделайте устойчивым к повторной отправке: передавайте ключ и пропускайте на приёмнике то, что уже приходило — после сбоя одно и то же окно изменений может быть обработано повторно.
Оптимально начать с представления (view): в нём собран SELECT со всеми JOIN по GUID-ключам.
DDL можно прописать прямо в обработчике (setup) или завести отдельно. Дальше обработчик работает так:
- библиотека вызывает его, передавая отметку
last_run_at— нижнюю границу окна изменений; - обработчик пишет
SELECT, который находит по представлению изменившиеся ключи условиемmerged_on > last_run_at(merged_onесть и у таблиц, подключённых черезJOIN, — см. пример); - этот
SELECTуходит в условия обновления dbmerge:source_conditionговорит, какие ключи взять из источника,delete_condition— в каком множестве ключей чистить строки, если что-то удалилось.delete_conditionнужен не всегда: строки, выпавшие из набора движений или табличной части, репликатор не удаляет, а помечает флагомis_deleted_or_empty(см. README_DB.md), поэтому витрине с тем же ключом, что у источника, достаточно обычного обновления. Удаление нужно там, где ключ витрины свой, — например, у агрегата поGROUP BY.
В примерах разобраны два варианта — с кодом и подробными пояснениями:
- ключ витрины совпадает с первичным ключом объекта 1С (GUID или составной ключ набора записей). Годится для таблицы фактов: config/handlers/zakazy_klientov.py;
- ключ витрины заменён на бизнес-ключ — например, номер документа вместо guid. Связь с «сырыми»
данными хранится в колонках-массивах (
ARRAY) с индексами GIN: по ним обработчик быстро находит, какие группы затронуло изменение в источнике. config/handlers/zakazy_klientov_grouped.py.
Ссылки
| файл | описание |
|---|---|
| README.md | этот файл: обзор, установка, запуск |
| README_ENV.md | запуск из окружения: все переменные ONECDC_*, значения по умолчанию, ошибки конфигурации |
| README_API.md | классы, которые собирает пользователь: Replicator, Handler, HandlerLoop, FullLoadCron; обработчики — окно изменений, когда их вызывают, пересборка витрины |
| README_DB.md | что появляется в целевой БД: таблицы, служебные поля, служебные таблицы |
| DESIGN.md | внутреннее устройство для тех, кто правит код: интерфейс OData, цикл изменений, пагинация полной выгрузки, гонки со снимком, механика обработчиков |
| CHANGELOG.md | что менялось от версии к версии |
| config/runner.py | шаблон точки входа: репликатор, обработчики и расписания в одном файле |
| config/handlers | примеры обработчиков |
Неофициальный проект, не связан с фирмой «1С». «1С» и «1С:Предприятие» — товарные знаки ООО «1С», используются для указания совместимости.
1 maintainer

Metadata
1 maintainer
Release files for onecdc 1.1.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | Provenance | |
|---|---|---|---|---|
| onecdc-1.1.0.tar.gz | 1.4 MB | Without provenance | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| onecdc-1.1.0-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 1.6 MB
Release files / onecdc-1.1.0.tar.gz
| Download URL | onecdc-1.1.0.tar.gz |
|---|---|
| Size | 1.4 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
d223f7de062591e18fe1161878146e39d4a8d26468e3b50e20e24ff7f1352900
|
|
BLAKE2b-256 checksum How to use checksums |
026d12149b9dcdc827cc8f9cf95189727e063efaa98c724c6f6cbbde6f3b96dc
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.14.3
|
Release files / onecdc-1.1.0-py3-none-any.whl
| Download URL | onecdc-1.1.0-py3-none-any.whl |
|---|---|
| Size | 208.6 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
b13f094b4220b0a280a482477177867ff961c8b45df156a19a437f748db4e2e0
|
|
BLAKE2b-256 checksum How to use checksums |
ef9ac22169fd5527397e07f31e4206b173674499262ef6067c36e4d756d61c1e
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.14.3
|
Security for onecdc 1.1.0
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
No provenance found
None of the files in this release were uploaded with provenance metadata.
A note on package security
PyPI is a repository for distributing packages, not a service for auditing them. While third-party security researchers and our staff do their best to detect and remove malicious packages, PyPI cannot guarantee the quality, security or suitability of any given package.
To learn more about protecting yourself from malicious actors, visit our package security documentation.














