



OneCDC is a docker container and a Python library, that provides 1C system data loading to data warehouse using Change Data Capture approach.
It engages standard ODATA mechanism and standard 1C exchange plan mechanism to extract data from 1C system and upsert changes to the target DB.
OneCDC — это докер контейнер и python-библиотека, предназначенные для получения данных из 1С подходом CDC (загрузка изменений данных).
Продукт использует стандартный интерфейс ODATA и механизм планов обмена для выгрузки изменений данных из системы 1С и обновления данных в целевой БД.
Общий принцип действия
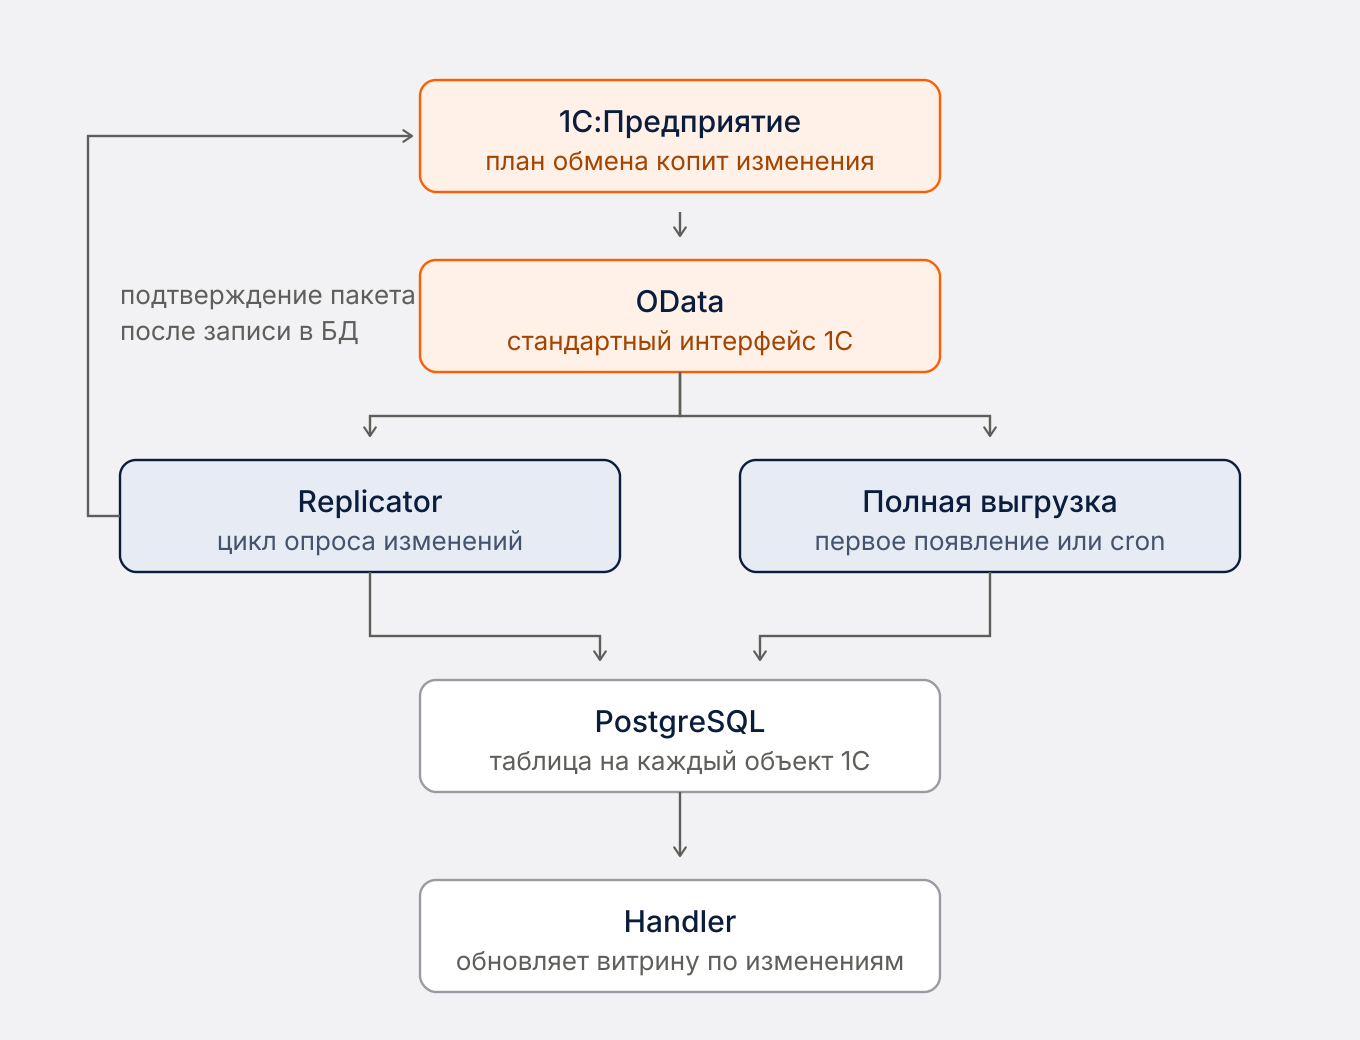
- Основной объект библиотеки это оркестратор
Replicator, который циклично читает изменения из 1С (через OData + план обмена) и пишет их в целевую БД Postgres, подтверждая приём пакета только после успешного сохранения. - В Postgres объекты сохраняются в виде отдельных таблиц на каждый регистр, справочник, документ, табличные части документа или справочника. Структура соответствует структуре хранения в 1С, но имена таблиц и полей автоматически переводятся в транслит.
- Полученные таблицы вы можете сами использовать для построения запросов, но библиотека предлагает также механизм обработчиков (handlers). Когда из 1С приходят новые данные, обработчик обновляет соответствующую часть в витрине данных. Витрину вы описываете сами — представлением (view) в базе данных. В примере показано как сделать обновление витрины быстрым, только по изменениям. Также механизм обработчиков это по сути ваш код на python, в который вы можете вставить что нужно.
Что нужно для работы
- опубликовать базу 1с на web
- настроить план обмена в конфигураторе и включить в его состав нужные объекты 1с
- создать пользователя для доступа к odata и дать ему необходимые права (
чтениеиизменениек плану обмена,чтениек загружаемым объектам). - дать роль
чтениевсем пользователям к плану обмена (иначе будут ошибки при сохранении объектов) - создать узел обмена с использованием внешней обработки
onecdc.epf - запустить загрузку: докер-образом
sobolevp/onecdc(см. «Запуск в docker») либо python-библиотекойonecdc(см. ниже)
Использование библиотеки python
Установка
pip install onecdc
Для записи изменений необходим PostgreSQL (Другие СУБД не тестировались, хотя в теории возможны). Для записи используется библиотека dbmerge. Все необходимые схемы, таблицы и поля модуль создает сам.
Требования к ресурсам
4 ГБ оперативной памяти на процесс.
Столько нужно потому, что размер пакета изменений задаёт 1С, а не мы: SelectChanges она формирует
в памяти рабочего процесса целиком и параметры $top/$filter игнорирует. Принятый пакет живёт в
памяти в нескольких видах сразу — тело, текст, дерево разбора, колонки — и на пике это примерно
вчетверо больше размера ответа (измерено: 28 МБ ответа → 102 МБ пика).
Чтобы слишком большой ответ не убивал процесс молча, есть потолок: 512 МБ, параметр
Replicator(max_response_bytes=...). Ответ крупнее не принимается — соединение обрывается, пакет
не подтверждается, а в лог идёт ERROR с фактическим размером. Это не чинит причину: пакет
остаётся в очереди 1С, и следующий цикл упрётся в тот же ответ. Зато процесс остаётся жив, полные
выгрузки и обработчики продолжают работать, и видно, что делать — настроить дроссель на стороне
1С, чтобы он регистрировал в очередь меньше объектов за раз (см. Большие объёмы изменений и
распределение нагрузки).
max_response_bytes=None снимает потолок совсем — если памяти заведомо хватает и вы предпочитаете
рискнуть, а не отказаться от пакета.
from sqlalchemy import create_engine
from onecdc import Replicator

# Потолок соединений — это СУММА pool_size и max_overflow, и задавать надо обе части: по
# умолчанию max_overflow=10, то есть один pool_size=5 на деле удерживает 15 соединений.
# В pool_size — то, что работает непрерывно (цикл изменений); страницы полной выгрузки,
# обработчики и расписания идут через overflow — такое соединение закрывается сразу, как
# отработало. См. README_DB.md, «Сколько нужно соединений к БД».
engine = create_engine("postgresql+psycopg2://user:pass@localhost:5432/onecdc",
                       pool_size=3,
                       max_overflow=2,          # + по одному на обработчика и на расписание
                       pool_pre_ping=True)      # соединение после ночного простоя сервер уже закрыл

rep = Replicator(
    odata_url="http://host/base/odata/standard.odata",
    odata_auth=("odata", "secret"),        # (user, password); None — 1С без авторизации
    engine=engine,
    exchange_name="ВашПланОбмена",         # имя плана обмена в 1С
    queue_guid="aaaaaaaa-aaaa-aaaa-aaaa-aaaaaaaaaaaa",  # Ref_Key узла обмена
    db_schema="onecdc",                    # None → схема БД по умолчанию (public у Postgres)
    request_timeout=60,                    # таймаут HTTP-запросов к 1С, сек (по умолчанию 60 на коннект, 900 на ответ)
    full_load_workers=2,                   # число фоновых потоков полной выгрузки
    automatic_full_load=True,              # ставить новые объекты на полную выгрузку самому
    log_retention_days=30,                 # срок хранения журнала загрузок; 0 — хранить всё
)

rep.run_forever(interval=60)               # цикл опроса раз в 60 секунд
План обмена и узел нужны только для чтения изменений. Репликатору, который собран ради полной
выгрузки (разовой или по расписанию), их можно не задавать вовсе — full_load читает объект
прямо из OData; run_forever/run_once у такого репликатора откажутся стартовать.
Примеры целиком
| файл | о чём |
|---|---|
| examples/replicate_forever.py | непрерывная репликация: один процесс, один цикл, без докера и потоков — то же, что выше, но готовое к запуску |
| examples/full_load_once.py | разовая полная выгрузка одного объекта: первая загрузка, добор истории, пересборка после нового реквизита |
| config/runner.py | многопоточный запуск: несколько обработчиков витрин, полные выгрузки по расписанию, несколько планов обмена в одном процессе |
Запуск в docker
docker run --rm --network host \
  -e ONECDC_ODATA_URL="http://server/base/odata/standard.odata" \
  -e ONECDC_ODATA_USER=odata -e ONECDC_ODATA_PASSWORD=secret \
  -e ONECDC_EXCHANGE_NAME="ВашПланОбмена" \
  -e ONECDC_QUEUE_GUID="aaaaaaaa-aaaa-aaaa-aaaa-aaaaaaaaaaaa" \
  -e ONECDC_DB_URL="postgresql+psycopg2://user:pass@database_host:5432/cdc" \
  -e ONECDC_DB_SCHEMA=onecdc -e ONECDC_DB_TEMP_SCHEMA=onecdc_tmp \
  -v "$PWD/config:/config:ro" \
  sobolevp/onecdc:latest
-v "$PWD/config:/config:ro" — монтирует папку config из текущего каталога. В ней лежит файл runner.py, а также подпапка с примерами обработчиков (config/handlers).
docker compose. Пример — docker-compose.yml в репозитории.
Запуск из окружения
Если хочется не писать код вовсе, есть готовый entrypoint — python -m onecdc (он же команда
onecdc). Он читает те же параметры из переменных окружения, см. описание: README_ENV.md
Как узнать guid узла обмена
queue_guid — это Ref_Key узла плана обмена, того самого, на который 1С регистрирует изменения
(ЭтотУзел не подходит: он описывает саму базу-источник). Если guid неизвестен, оставьте параметр
пустым (queue_guid="", или просто не задавайте ONECDC_QUEUE_GUID) и запустите: чтение изменений
выведет в лог список узлов плана обмена и остановится.
ERROR onecdc.change_reader: queue_guid is not set. Available nodes of exchange plan ДляODATA:
    a9bc23c5-3689-11f1-926c-0800270bc6cb  CDC  Витрина
Guid из первой колонки и есть искомый queue_guid.
Режимы: run_once и run_forever
rep.run_once()                 # один цикл: read → save → notify (подтверждение только после save)
rep.run_forever(interval=60)   # основной режим работы. бесконечный цикл run_once с паузой; фоном — полные выгрузки
run_once(notify_changes=False)— не подтверждать приём (пакет останется в очереди 1С; сделано для отладки).run_forever(interval, max_iterations=0)—max_iterations>0ограничивает число итераций.
Полная (первоначальная) выгрузка
При работе run_forever объекты, впервые встреченные в пакете изменений, автоматически ставятся в
очередь на полную выгрузку и грузятся фоновыми потоками. Управляет этим параметр
automatic_full_load (по умолчанию True).
- Можно запустить выгрузку и вручную, поставив флаг в таблице onecdc_metadata_objects - full_load_is_required=
True. Фоновые потоки подхватят объект на следующем цикле — в том числе приautomatic_full_load=False. - Полная выгрузка спроектирована так, чтобы работать параллельно с получением изменений объекта и не затирать свежие изменения объекта. Также она автоматически разбивает объект на отрезки по времени и выгружает его порциями с автоматическим подбором размера (batch_size).
- Есть возможность инициировать полную выгрузку и на стороне 1С — обработкой
onecdc.epfзарегистрировать все изменения объекта в узле обмена. Но тогда объект приедет одним пакетомSelectChanges, а его платформа целиком держит в памяти рабочего процесса, поэтому так делают только вместе с «дросселем» (см. Большие объёмы изменений и распределение нагрузки). В этом случае поставьтеautomatic_full_load=False, иначе репликатор закажет ту же выгрузку второй раз.
Какие объекты 1С поддерживаются
В план обмена можно включать:
| Класс объекта 1С | |
|---|---|
| справочники | вместе с табличными частями |
| документы | вместе с табличными частями |
| регистры сведений | подчинённые регистратору |
| регистры накопления | |
| регистры бухгалтерии | субконто — по запросу, см. ниже |
Всё остальное не поддерживается — константы, регистры расчёта, планы видов характеристик,
планы счетов, планы видов расчёта, бизнес-процессы, задачи. Не включайте их в план обмена: их
изменения будут потеряны безвозвратно, потому что пакет подтверждается целиком и 1С их больше не
пришлёт. В логе это видно как ERROR со словами CHANGES LOST.
Независимые регистры сведений (без регистратора) 1С в план обмена не отдаёт вовсе — для них возможна только периодическая полная выгрузка.
Субконто регистра бухгалтерии по умолчанию не выгружаются. Нужны — включите
Replicator(read_subconto=True); у full_load есть такой же параметр на один прогон. Учтите цену:
аналитику 1С отдаёт только через отдельную виртуальную таблицу, которую нельзя листать
страницами, — на большом регистре это много запросов, и время растёт вместе с объёмом. Чаще всего
те же аналитические разрезы проще взять из документа-регистратора, чем разбирать JSON-колонку
субконто. Если вы раньше выгружали субконто, а потом выключили параметр, колонки ExtDimensionsDr
и ExtDimensionsCr останутся в таблице со старыми значениями: колонки библиотека не удаляет.
Что появляется в целевой БД
На каждый объект 1С заводится своя таблица: имя транслитерируется, к полям добавляются служебные
(merged_on, inserted_on, is_deleted_or_empty, exchange_message_no). Схемы, таблицы и новые
колонки библиотека создаёт сама. Рядом появляются служебные таблицы, по которым видно состояние
загрузки: журнал onecdc_replicator_log, реестр объектов onecdc_metadata_objects, состояние обработчиков
onecdc_handlers, реестр незавершённых записей onecdc_writes_in_process, закреплённые имена
таблиц и колонок onecdc_name_claims и читателей узлов обмена onecdc_exchange_nodes.
Журнал загрузок растёт быстро — строка на объект на пакет, то есть миллионы строк в год, — поэтому
у него есть срок хранения: log_retention_days (по умолчанию 30 суток, 0 — хранить всё). Уборка
идёт сама, раз в сутки на процесс.
Подробно — README_DB.md: состав полей, что означает is_deleted_or_empty, зачем
отдельная схема под таблицы ключей полной выгрузки и что лежит в каждой служебной таблице.
Если в 1С поменяли тип поля
Тип колонки в БД библиотека не меняет: в ней лежат данные, и привести их к новому типу может быть некому — из строки не получится ссылка. Поэтому старое отставляется в сторону, а новое заводится пустым.
| что поменялось | что произойдёт |
|---|---|
| обычное поле | колонка переименуется в Поле_Old_<хэш>, рядом появится новая, нужного типа |
| поле, входящее в ключ | переименуется вся таблица — в Таблица_Old_<хэш>, рядом появится новая |
Дальше объекту заказывается полная выгрузка, чтобы наполнить новое историей. Если автоматические
выгрузки выключены (automatic_full_load=False), заказ не ставится — новая колонка или таблица
будет наполняться только текущими изменениями, без истории; запустите full_load сами, когда
удобно.
Если тип колонки задали вы сами (например сузили varchar до varchar(50) или указали точность
numeric), это сменой типа не считается и колонку библиотека не тронет.
Классы библиотеки
Replicator читает изменения и пишет их в БД, Handler + HandlerLoop дают возможность запуска своего кода
по событию изменения, FullLoadCron — полную выгрузку по расписанию. Что каждый из них принимает и
что у него можно вызвать — README_API.md.
Логирование
Из коробки библиотека вешает вывод на логгер onecdc (INFO), если приложение не настроило логирование
само. Настроили своё — библиотека молчит и пишет через стандартный logging.
Шум со стороны 1С
1С регистрирует изменение объекта на любую перезапись, поэтому в пакет приезжает масса записей, у которых поменялись только DataVersion и номер пакета. Такие записи библиотека изменением не считает: строка не обновляется, merged_on остаётся прежним — и обработчик, который выбирает данные по merged_on, впустую не запускается.
Большие объёмы изменений и распределение нагрузки
Если изменений много и один репликатор не справляется, нагрузку распределяют тремя способами:
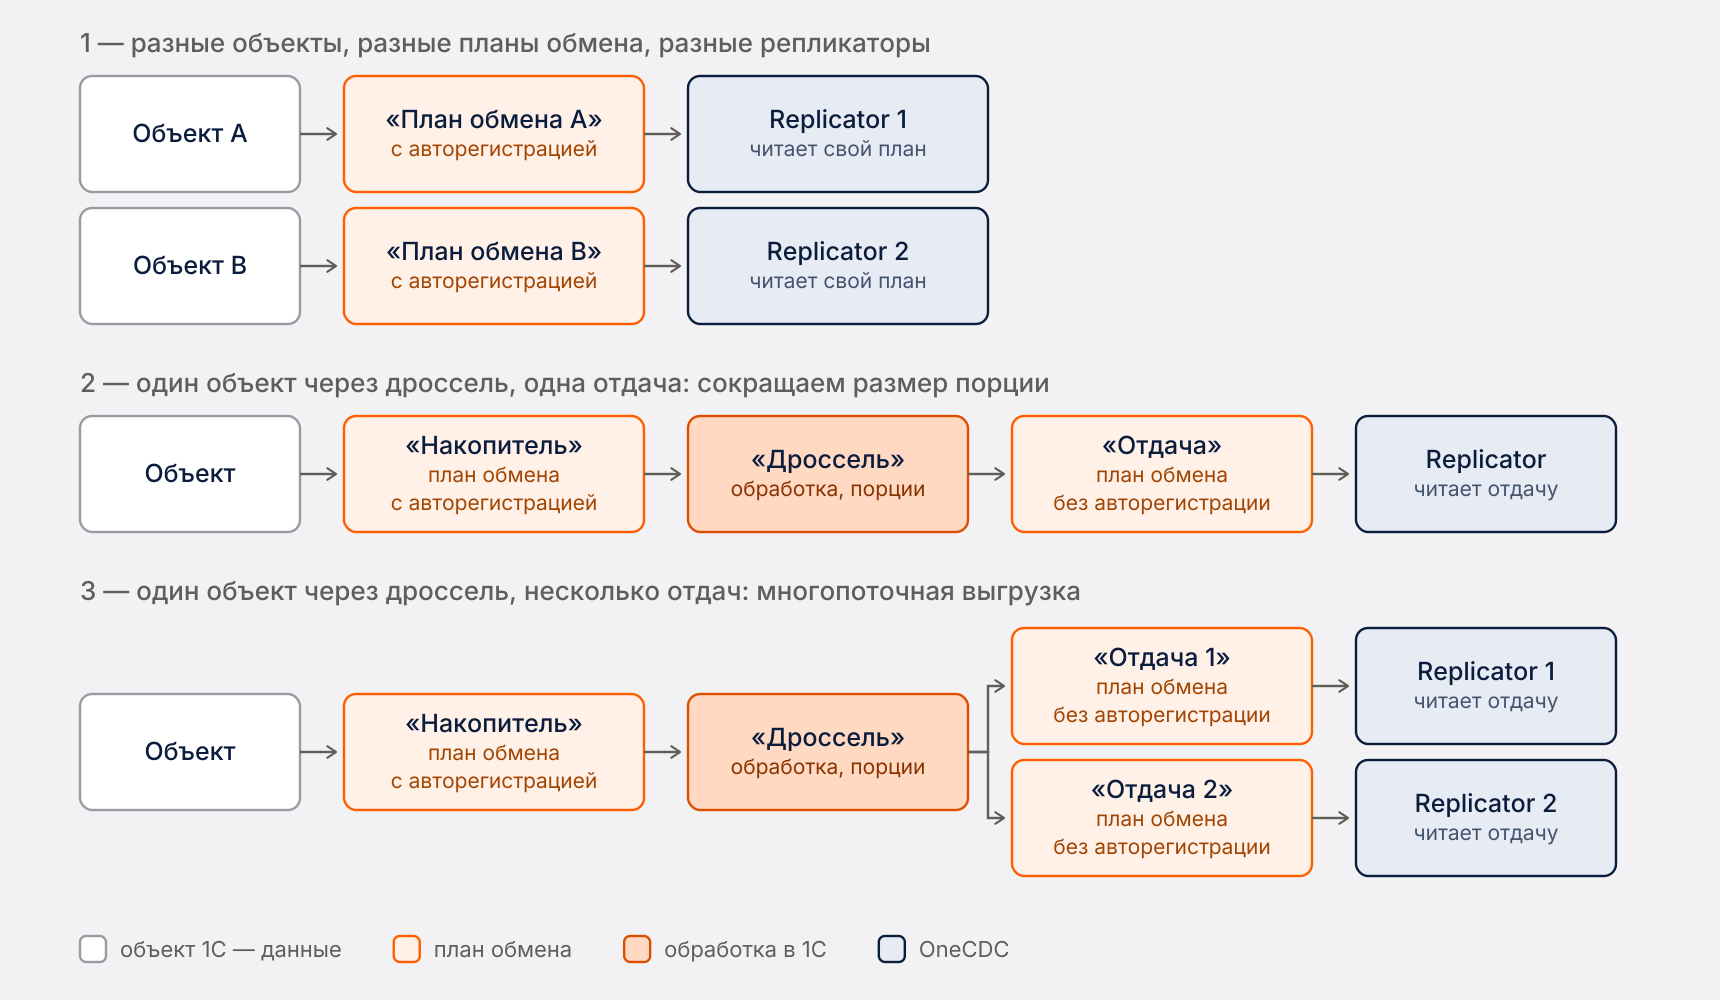
- Разные объекты 1С — в разные планы обмена. Каждый план читает свой репликатор; репликаторы можно развести по машинам или запустить в одном многопоточном скрипте.
- Один объект — через «дроссель»: он дозирует изменения, чтобы пакет не разрастался (см. ниже).
- Тот же дроссель, но с несколькими планами-отдачами: один объект читают несколько репликаторов параллельно.
Метод SelectChanges в OData, к сожалению, не умеет отдавать изменения постранично: платформа
формирует весь пакет в памяти рабочего процесса, а $top / $select / $filter игнорирует.
Ограничить размер пакета со стороны клиента нечем — это делается на стороне 1С, регистрацией
изменений. Готовый общий модуль («дроссель») лежит в репозитории:
onecdc-throttle-module.txt
— инструкция по установке в шапке файла, разбор устройства — в
DESIGN.md.
Схема такая:
- план обмена «Накопитель» — с авторегистрацией изменений ваших объектов;
- один или несколько планов обмена «Отдача» — с ЗАПРЕЩЁННОЙ авторегистрацией. Единственный, кто в них регистрирует, — дроссель;
- регламентное задание вызывает
onecdcДроссель.ЗапуститьПеренос1и добивает каждую отдачу порциями из накопителя, до лимита в единицах регистрации.
Репликатор читает SelectChanges из отдачи, поэтому размер пакета задаёте вы, а не платформа.
Планов-отдач может быть несколько: они наполняются по порядку, и вторая получает изменения, только
когда первая набрала свой лимит. На каждую отдачу поднимается свой Replicator — так получение
изменений идёт в несколько потоков.
Сколько процессов запускать
Один узел обмена читает один репликатор, один обработчик исполняет один процесс. Это и есть рабочая раскладка: параллельное чтение одного узла удваивает нагрузку на 1С и может стоить изменений, а параллельный расчёт одной витрины — переписать её результат устаревшим.
Держать это настройкой не нужно — есть страховка. Перед работой процесс захватывает узел обмена и имя обработчика, а пока жив, подтверждает захват отметкой живости. Поэтому:
- второй такой же контейнер безопасен: он ничего не задублирует, а просто подождёт;
- упал первый — второй подхватит примерно через 15 минут (отметка живости перестала
обновляться). При штатной остановке (
SIGTERM) захват отпускается сразу и ждать не нужно — это разница между незаметным обновлением и четвертью часа тишины; - полные выгрузки при этом делятся: объекты захватываются поштучно, так что «лишний» процесс не простаивает, а разбирает очередь выгрузок вместе с первым.
Дальнейшая обработка и материализация
1С хранит данные нормализованно: чтобы дотянуться из регистра до кода товара, нужен JOIN со
справочником по guid. Для КХД обычно удобнее менее строгая нормализация — витрины, собранные
заранее.
Считать их вхолостую по расписанию не нужно: репликатор знает, когда данные изменились, и сам вызывает ваш код. Такой код называется обработчиком — это класс с двумя строчками объявления:
from onecdc import Handler, HandlerContext

class ZakazyKlientov(Handler):
    ON = ["AccumulationRegister_ZakazyKlientov"]   # имена ТАБЛИЦ в БД, не объектов 1С

    def handle(self, context: HandlerContext) -> None:
        self.execute(context, "insert into ... where merged_on > :last_run_at",
                     last_run_at=context.last_run_at)
Тем же способом изменения отправляют во внешнюю систему — очередь, вебхук, другую БД. Обработчик-отправщик пишите так, чтобы повторная отправка ничего не ломала: передавайте ключ и пропускайте на приёмнике то, что уже приходило — одна и та же порция изредка может уйти дважды.
Начинают обычно с представления (view): в нём собран SELECT со всеми JOIN по guid-ключам.
DDL можно прописать прямо в обработчике (setup) или завести отдельно. Дальше обработчик работает так:
- библиотека вызывает его, передавая дату и время
last_run_at— с них и нужно обновлять; - обработчик пишет
SELECT, который находит по представлению изменившиеся ключи условиемmerged_on > last_run_at(merged_onесть и у таблиц, подключённых черезJOIN, — см. пример); - этот
SELECTуходит в условия обновления dbmerge:source_conditionговорит, какие ключи взять из источника,delete_condition— в каком множестве ключей чистить строки, если что-то удалилось.delete_conditionнужен не всегда: строки, выпавшие из набора движений или табличной части, репликатор не удаляет, а помечает флагомis_deleted_or_empty(см. README_DB.md), поэтому витрине с тем же ключом, что у источника, достаточно обычного обновления. Удаление нужно там, где ключ витрины свой, — например, у агрегата поGROUP BY.
В примерах разобраны два варианта — с кодом и подробными пояснениями:
- ключ витрины совпадает с первичным ключом объекта 1С (суррогатный guid). Годится для таблицы фактов: config/handlers/zakazy_klientov.py;
- ключ витрины заменён на бизнес-ключ — например, номер документа вместо guid. Связь с «сырыми»
данными хранится в колонках-массивах (
ARRAY) с индексами GIN: по ним обработчик быстро находит, какие агрегированные ключи задело изменение в источнике. config/handlers/zakazy_klientov_grouped.py.
Ссылки
| файл | описание |
|---|---|
| README.md | этот файл: обзор, установка, запуск |
| README_ENV.md | запуск из окружения: все переменные ONECDC_*, значения по умолчанию, ошибки конфигурации |
| README_API.md | классы, которые собирает пользователь: Replicator, Handler, HandlerLoop, FullLoadCron; обработчики — окно изменений, когда их вызывают, пересборка витрины |
| README_DB.md | что появляется в целевой БД: таблицы, служебные поля, служебные таблицы |
| DESIGN.md | внутреннее устройство для тех, кто правит код: интерфейс OData, цикл изменений, пагинация полной выгрузки, гонки со снимком, механика обработчиков |
| CHANGELOG.md | что менялось от версии к версии |
| config/runner.py | шаблон точки входа: репликатор, обработчики и расписания в одном файле |
| config/handlers | примеры обработчиков |
Неофициальный проект, не связан с фирмой «1С». «1С» и «1С:Предприятие» — товарные знаки ООО «1С», используются для указания совместимости.
1 maintainer

Metadata
1 maintainer
Release files for onecdc 1.0.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| onecdc-1.0.0.tar.gz | 1.4 MB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| onecdc-1.0.0-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 1.7 MB
Release files / onecdc-1.0.0.tar.gz
| Download URL | onecdc-1.0.0.tar.gz |
|---|---|
| Size | 1.4 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
f207fb20e2c8e2abecdda8baf385f91944f55ee9b587ef24843a4189d2da4c95
|
|
BLAKE2b-256 checksum How to use checksums |
a4a4d2ee605566d83977422ac9844c4843576838fa2da6d1ad0cee1d54d7ed38
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.14.3
|
Release files / onecdc-1.0.0-py3-none-any.whl
| Download URL | onecdc-1.0.0-py3-none-any.whl |
|---|---|
| Size | 230.3 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
a1efc5a90d8bf57ad9b1d2642d2c31e388478f75866275ea06bcfee509a527bd
|
|
BLAKE2b-256 checksum How to use checksums |
55a4c56505f8e8f0085f3043d8b296df17a809b973555dbb7d99d233d6c53a49
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.14.3
|














