
pyettj


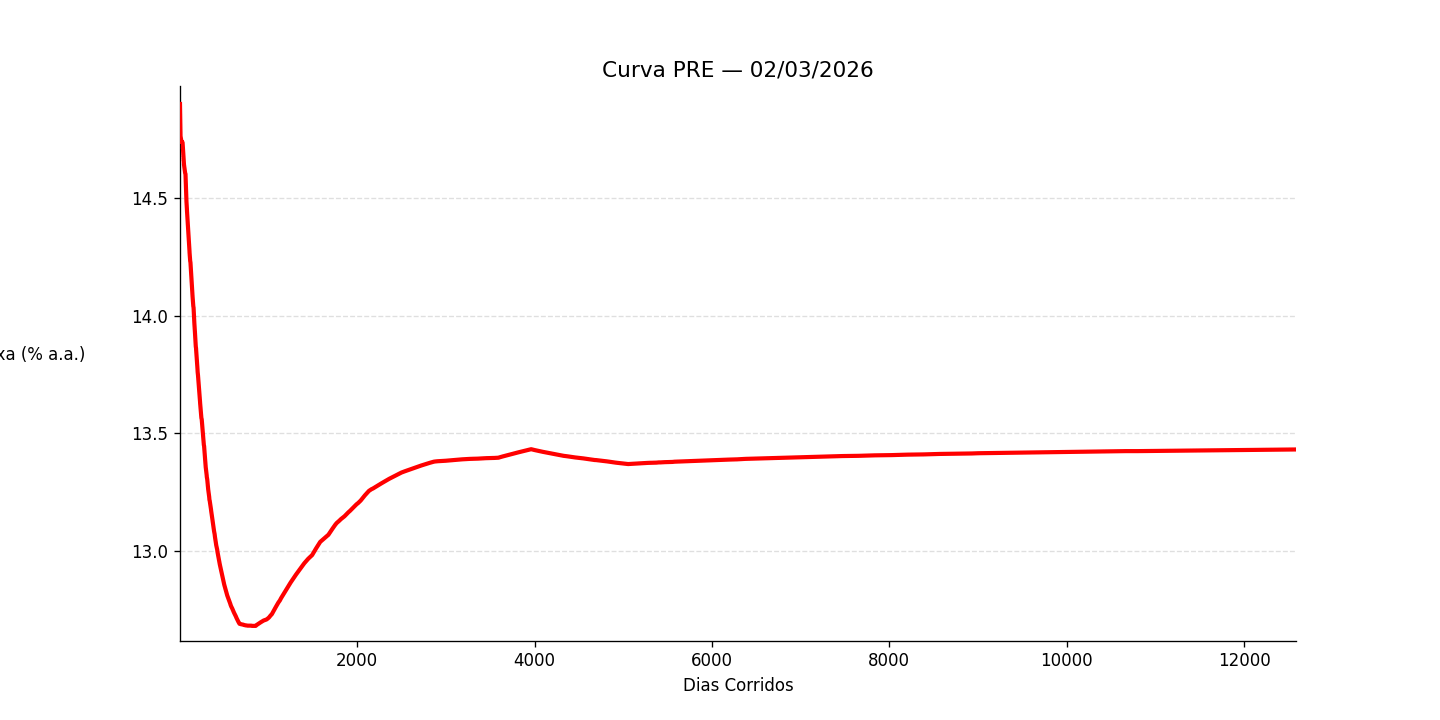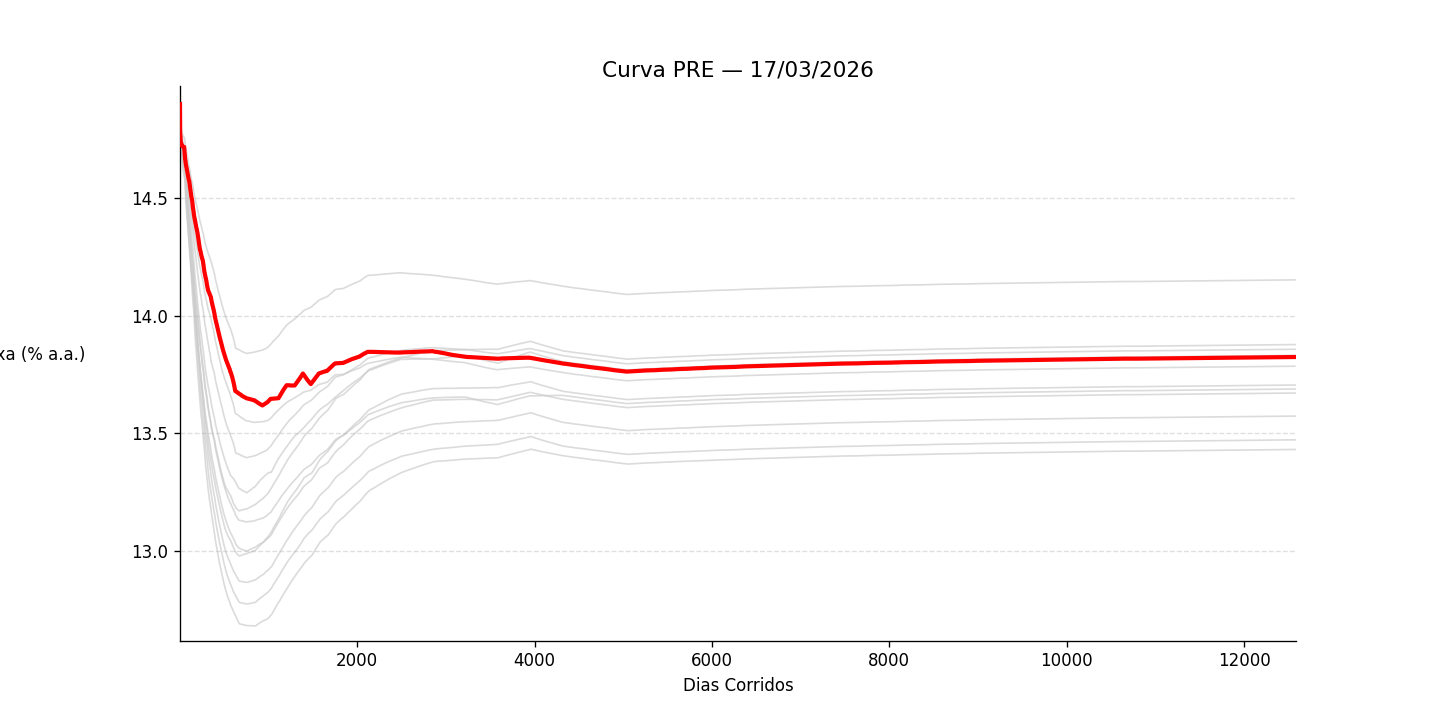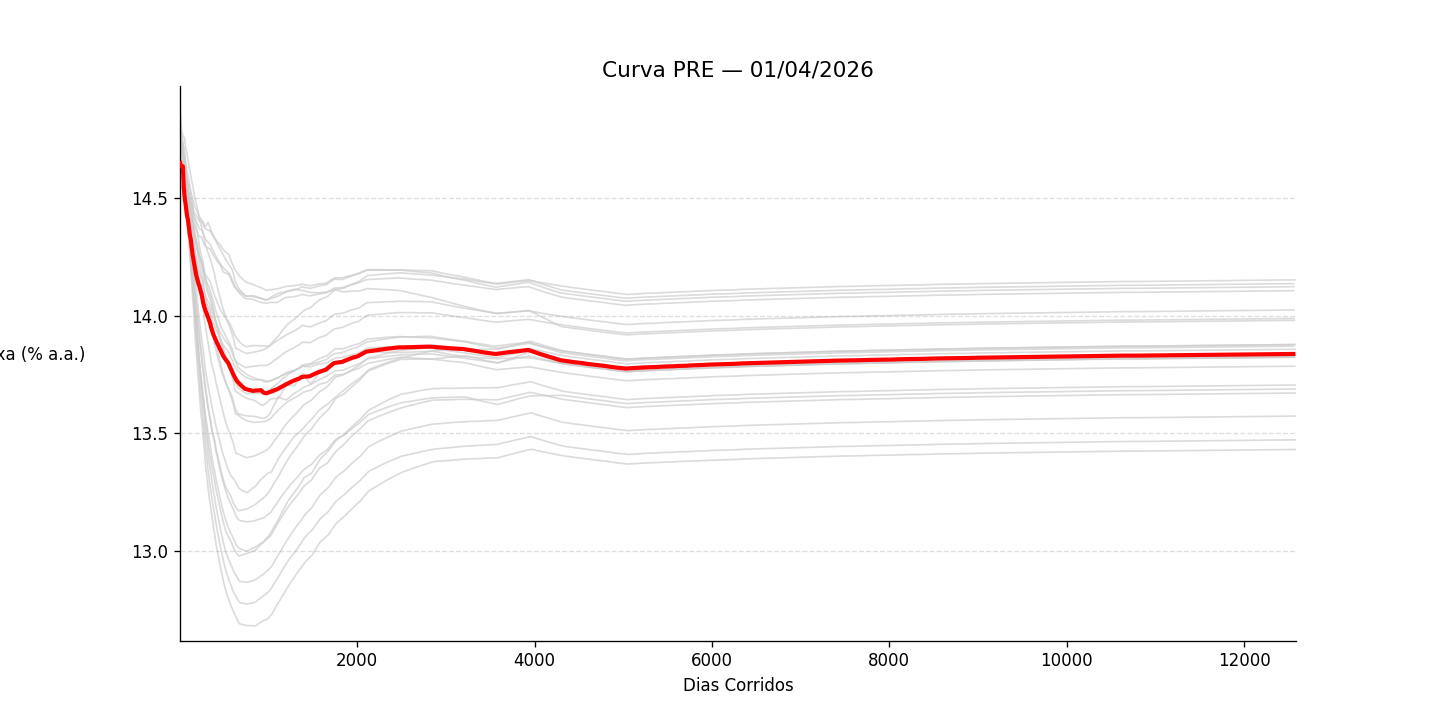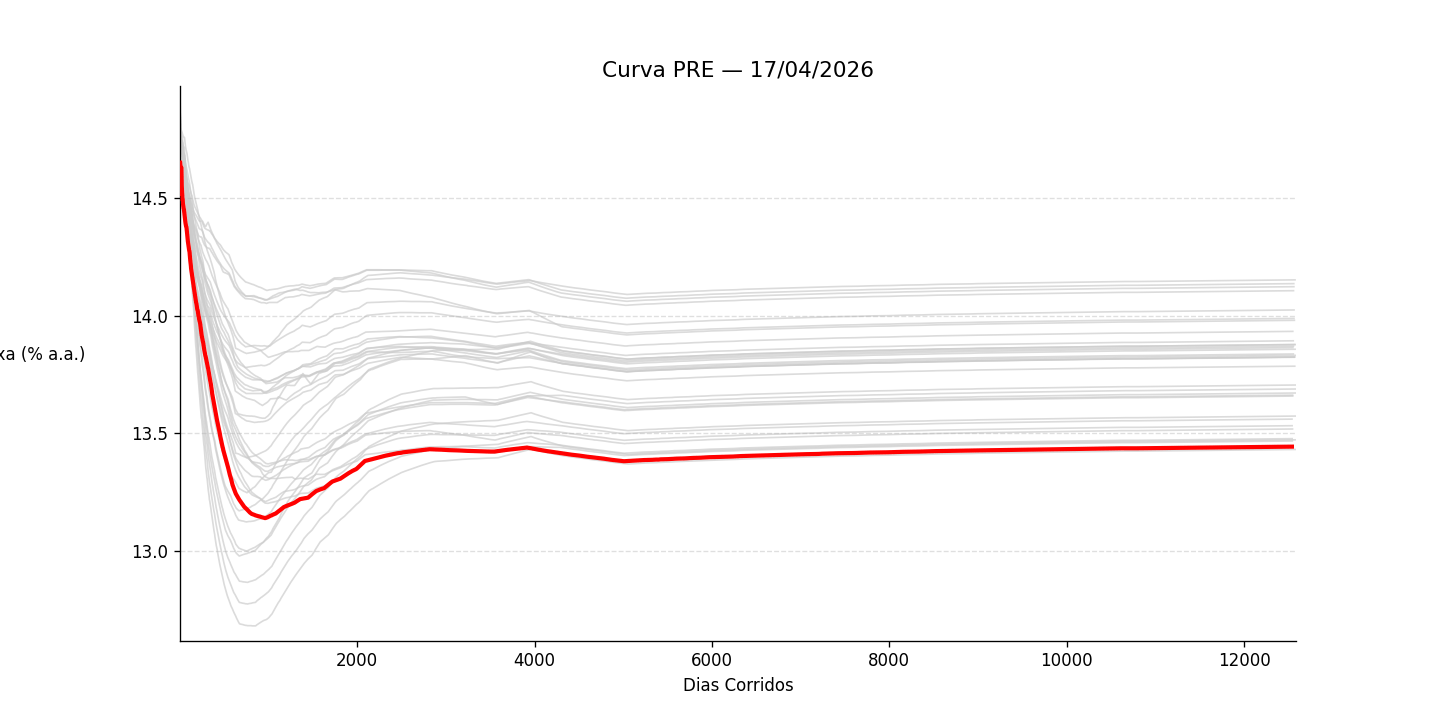
pyettj é uma biblioteca Python para capturar dados públicos das curvas de juros ou estrutura a termo da taxa de juros (ETTJ) com dados da B3 (Brasil, Bolsa e Balcão) e ANBIMA. Também é possível modelar curvas usando os modelos Heath-Jarrow-Morton (HJM) e Nelson-Siegel-Svensson (NSS).
Instalação
pip install pyettj
Ou:
python -m pip install git+https://github.com/rafa-rod/pyettj.git
Exemplo de Uso
Listar curvas disponíveis
import pyettj as ettj

ettj.listar_curvas()
Capturar uma curva em uma data
import pyettj as ettj

data = '09/04/2026'
df = ettj.get_ettj(data)
O DataFrame retornado tem a seguinte estrutura:
| refdate    | curva | descricao | dias_corridos | dias_uteis | taxa   | vertice |
|------------|-------|-----------|---------------|------------|--------|---------|
| 2026-04-09 | PRE   | DIxPRE    | 1             | 1          | 0.1465 | F       |
| 2026-04-09 | PRE   | DIxPRE    | 4             | 2          | 0.1464 | M       |
| ...        | ...   | ...       | ...           | ...        | ...    | ...     |
A taxa está em decimal: 0.1465 = 14,65% a.a.
Capturar curva específica
df = ettj.get_ettj(data, curva="PRE")
df = ettj.get_ettj(data, curva="DIC")   # DI x IPCA
df = ettj.get_ettj(data, curva="DCL")   # Cupom Limpo Dólar
Capturar múltiplas curvas
df = ettj.get_ettj(data, curva=["PRE", "DIC"])
Usando proxy (ambiente corporativo)
import pyettj as ettj
import getpass

USER  = getpass.getuser()
PWD   = getpass.getpass("Senha de rede: ")
PROXY = "servidor"
PORTA = 4300

proxies = {
    "http":  f"http://{USER}:{PWD}@{PROXY}:{PORTA}",
    "https": f"http://{USER}:{PWD}@{PROXY}:{PORTA}",
}

df = ettj.get_ettj(data, curva="PRE", proxies=proxies)
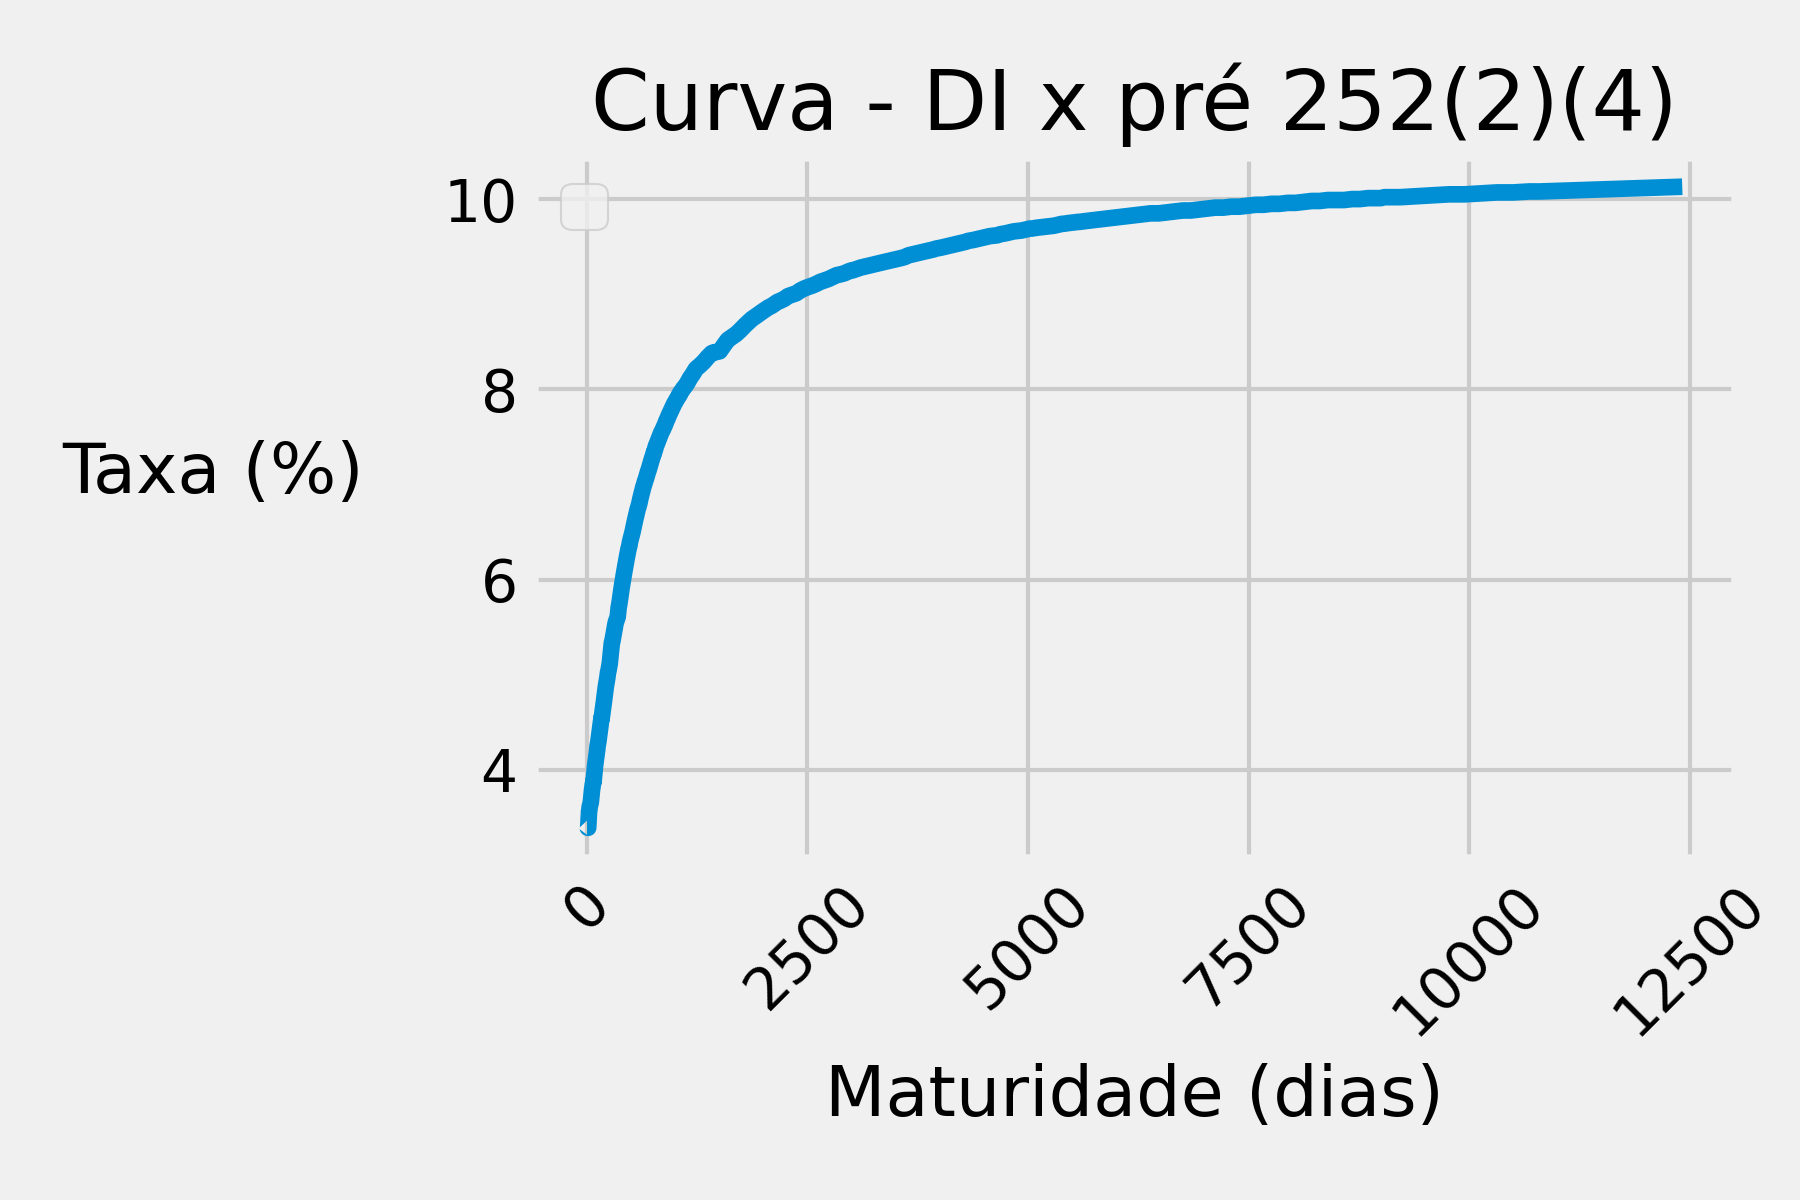
Plotar a curva
import pyettj as ettj
import pyettj.plot_ettj as plot

df = ettj.get_ettj(data, curva="PRE")
plot.plot_ettj(df)
Coletar várias datas
Use listar_dias_uteis para obter os dias úteis entre duas datas e get_ettj_historico para coletar o intervalo completo automaticamente:
import pyettj as ettj

# Listar dias úteis do intervalo
datas = ettj.listar_dias_uteis("01/04/2026", "09/04/2026")

# Coletar todas as datas de uma vez (com cache automático)
df_historico = ettj.get_ettj_historico(
    "01/04/2026", "09/04/2026",
    curva="PRE",
    proxies=proxies,
)

# Identificar as datas retornadas
df_historico["refdate"].unique()
Cache local
Por padrão, o pyettj salva os dados em cache local (~/.pyettj/cache/) para evitar downloads repetidos. Isso é especialmente útil para séries históricas longas.
# Cache habilitado por padrão
df = ettj.get_ettj(data, proxies=proxies)

# Desabilitar cache
df = ettj.get_ettj(data, proxies=proxies, cache=False)

# Ver informações do cache
ettj.cache_info()

# Limpar cache
ettj.cache_clear()                       # tudo
ettj.cache_clear(antes_de="01/01/2026")  # só dados antigos
O diretório padrão pode ser alterado via Python:
# Definir uma vez por sessão — todas as chamadas subsequentes usam este diretório
ettj.set_cache_dir(r"C:\dados\mercado\pyettj")   # Windows
ettj.set_cache_dir("/dados/mercado/pyettj")          # Linux/Mac
Tratamento de Exceções
from pyettj import HolidayError, NoDataError, CurvaInvalidaError, PyETTJError

try:
    df = ettj.get_ettj("11/04/2026", proxies=proxies)  # sábado
except HolidayError as e:
    print(f"Feriado: {e}. Sugestão: {e.sugestao}")

try:
    df = ettj.get_ettj(data, curva="XYZ", proxies=proxies)
except CurvaInvalidaError as e:
    print(f"Curva inválida: {e.curva}")

try:
    df = ettj.get_ettj(data, proxies=proxies)
except PyETTJError as e:
    print(f"Erro: {e}")
ANBIMA — Estrutura a Termo das Taxas de Juros Estimada
Você pode obter os dados da ANBIMA disponíveis em: https://www.anbima.com.br/informacoes/est-termo/CZ.asp
import pyettj as ettj

parametros_curva, ettj_df, taxa, erros = ettj.get_ettj_anbima("15/09/2022")
A partir dos parâmetros estimados pela ANBIMA, você pode usar a equação de Svensson:
curva = parametros_curva.loc["PREFIXADOS", :].str.replace(",", ".").astype(float)

beta1, beta2, beta3, beta4 = curva[:4]
lambda1, lambda2 = curva[4:]
t = 21/252  # em anos

taxa = ettj.svensson(beta1, beta2, beta3, beta4, lambda1, lambda2, t)
print(taxa)
Para coletar as taxas em diversas maturidades:
maturidades = [1, 21, 42, 63, 126, 252, 504, 1008, 1260, 1890, 2520]
taxas = []

for x in maturidades:
    taxa = ettj.svensson(beta1, beta2, beta3, beta4, lambda1, lambda2, x/252)
    taxas.append(taxa)

pd.DataFrame(taxas, index=[x/252 for x in maturidades]).multiply(100).plot()
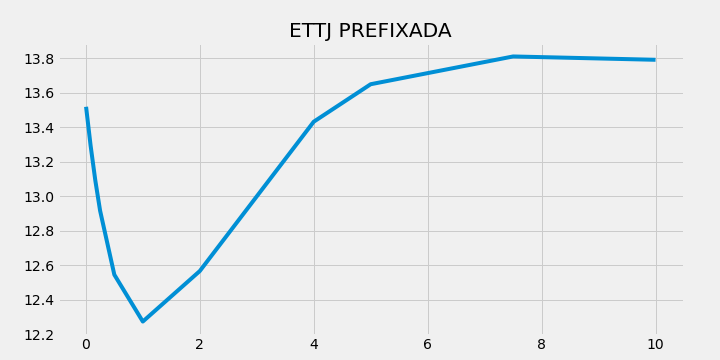
Caso você não possua os parâmetros da curva Svensson, pode-se estimá-los:
import matplotlib.pyplot as plt
import pyettj as ettj

data = '20/03/2023'
df = ettj.get_ettj(data, curva="PRE")

# t em anos, y em decimal
t = df["dias_corridos"].divide(252).values
y = df["taxa"].values

beta1, beta2, beta3, beta4, lambda1, lambda2 = ettj.calibrar_curva_svensson(t, y)

maturidades = [1, 21, 42, 63, 126, 252, 504, 1008, 1260, 1890, 2520]
taxas = [ettj.svensson(beta1, beta2, beta3, beta4, lambda1, lambda2, x/252)
         for x in maturidades]

ettj_pre = pd.DataFrame(taxas, index=[x/252 for x in maturidades]).multiply(100)

plt.figure(figsize=(10, 5))
plt.plot(ettj_pre)
plt.title("ETTJ PREFIXADA")
plt.show()
Geração de Cenários de Estresse para Curva de Juros usando Heath-Jarrow-Morton (HJM)
Baseado no artigo de: Dario, A.D.G. and Fernández, M., 2011. Geraçao de Cenarios de Estresse para Curva de Juros. Brazilian Review of Finance, 9(3), pp.413-436.
O modelo HJM facilita a incorporação de opinião de especialistas na construção de cenários de estresse das curvas de juros. Além disso, segundo o estudo, o modelo HJM se mostra superior ao modelo de Nelson-Siegel-Svensson (NSS).
Ele modela a estrutura de volatilidade do processo das taxas e pode ser descrito usando apenas 3 componentes (3 fatores) que explicam mais de 95% da variação das taxas de juros: 1- nível, 2- inclinação e 3- curvatura.
Uma vez determinadas as funções de volatilidades $\sigma_j$ e os valores para cada fator $\xi_j$, $j = 1, 2, 3$, a curva de estresse para um holding period de $HP$ dias úteis pode ser construída como segue para cada maturidade $T_i$:
$$ r_{0+HP}(T_i) = r_0(T_i) + \frac{HP}{252} \mu(T_i) + \sqrt{\frac{HP}{252}} \sum_{j=1}^{3} \sigma_j(T_i)\xi_j $$
onde:
- $HP$ é o holding period em dias úteis
- $\mu(T_i)$ é o drift oriundo da equação diferencial estocástica multivariada
- $\sigma_j(T_i)$ são as volatilidades dos fatores
- $\xi_j$ são os choques dos fatores
O uso de três fatores é suficiente para descrever mais de 95% da variação da taxa de juros, segundo o referido estudo. Em termos de PCA (análise de componentes principais), são usados os três maiores autovalores, identificados como a representação dos movimentos de deslocamento paralelo, inclinação e curvatura.
Contudo, conforme minhas experiências, o uso de 3 fatores depende dos dados de calibração e forma de otimização. Aqui o algoritmo já possui ajustes de otimização para facilitar encontrar resposta ótima mais adequada, mas qualquer método que use PCA (análise de componentes principais) depende fortemente da qualidade dos dados (missing values e outliers influenciam muito).
Mais detalhes podem ser vistos no referido artigo, vamos para um exemplo de implementação.
import pyettj as ettj
import pyettj.HJM as HJM
import pandas as pd
import numpy as np

import seaborn as sns; sns.set_style("white")
import matplotlib.pyplot as plt

# 1. Coleta dos Dados
de  = '13/05/2019'
ate = '09/04/2026'

df_historico = ettj.get_ettj_historico(
    de, ate,
    curva="PRE",
    proxies=proxies,   # omitir se não usar proxy
)
O DataFrame retornado por get_ettj_historico tem estrutura longa. Para o HJM precisamos de uma tabela pivô onde o índice são as datas e as colunas os vértices em dias corridos:
def preparar_dataframe_hjm(df: pd.DataFrame, vertices=None) -> pd.DataFrame:
    """
    Converte o DataFrame longo do get_ettj_historico para o formato
    wide exigido pelo ModeloHJM:
        índice  → datas (refdate)
        colunas → dias corridos (vértices)
        valores → taxa em percentual (taxa * 100)
    """
    taxa_wide = df.pivot_table(
        values="taxa",
        index="refdate",
        columns="dias_corridos",
        aggfunc="first",
    ) * 100  # decimal → percentual

    taxa_wide.columns.name = None
    taxa_wide = taxa_wide[sorted(taxa_wide.columns)]

    if vertices:
        colunas = [c for c in taxa_wide.columns if c in vertices]
        return taxa_wide[colunas]

    return taxa_wide.dropna(axis=1)

taxa_pre = preparar_dataframe_hjm(df_historico)
O resultado tem a seguinte estrutura:
| refdate    |   210 |   420 |   630 |   840 |  1050 |  2520 |
|------------|-------|-------|-------|-------|-------|-------|
| 13/05/2019 |  6.41 |  6.56 |  6.99 |  7.38 |  7.73 |  8.81 |
| 14/05/2019 |  6.40 |  6.51 |  6.92 |  7.32 |  7.63 |  8.77 |
| 15/05/2019 |  6.40 |  6.52 |  6.92 |  7.32 |  7.65 |  8.82 |
| 16/05/2019 |  6.43 |  6.59 |  7.01 |  7.43 |  7.75 |  8.93 |
| 17/05/2019 |  6.46 |  6.70 |  7.14 |  7.57 |  7.90 |  9.13 |
No índice estão as datas de coleta das taxas da curva e as colunas são os vértices em dias corridos. Importante ressaltar que haverá dados faltantes (missing values) para vértices com menos liquidez — cabe ao usuário selecionar as melhores colunas e interpolar, se necessário.
# 2. Analisar os dados
# Recomendo fortemente verificar dados faltantes e valores estranhos.
# Use ferramentas gráficas para ajudar:
HP = 10
choques_historicos_pre = taxa_pre.diff(HP).dropna()

sns.histplot(choques_historicos_pre[210])
sns.boxplot(data=choques_historicos_pre[210])

# Veja também os choques históricos.
# Isso ajuda para construir cenários e saber o nível dos choques:
pontos_base_estresses_historicos_pre = pd.concat([
    choques_historicos_pre.quantile(0.99, interpolation="nearest"),
    choques_historicos_pre.quantile(1-0.99, interpolation="nearest"),
], axis=1) * 10_000  # em bps
pontos_base_estresses_historicos_pre.columns = ["Choques Positivos", "Choques Negativos"]
pontos_base_estresses_historicos_pre


# 3. Modelo HJM
modelo = HJM.ModeloHJM(convencao_dias=252, verbose=1)

# Sempre usar dias corridos conforme dados oriundos do pyettj
vertices_calibracao = [420, 840, 1050, 2520]

modelo.calibrar(taxa_pre, vertices_calibracao)
if modelo.calibrado:
    print(f"✅ Calibração concluída! {modelo}")

data_choque = "2026-01-02"

resultado_pos = modelo.aplicar_choques(
    data_choque=data_choque,
    vertices_choques_dias=[21, 504, 252*10],
    choques_observados=np.array([-100, 0, 255]) / 10_000,  # em bps → decimal
    hp_dias=10,
    retornar_detalhes=True,
)

resultado_neg = modelo.aplicar_choques(
    data_choque=data_choque,
    vertices_choques_dias=[21, 504, 252*10],
    choques_observados=np.array([100, 0, -200]) / 10_000,  # em bps → decimal
    hp_dias=10,
    retornar_detalhes=True,
)

# Caso precise salvar o modelo:
caminho_modelo = "modelo_hjm_calibrado.json"
modelo.salvar(caminho_modelo)

# Carregar o modelo salvo:
modelo_carregado = ettj.ModeloHJM.carregar(caminho_modelo, verbose=1)
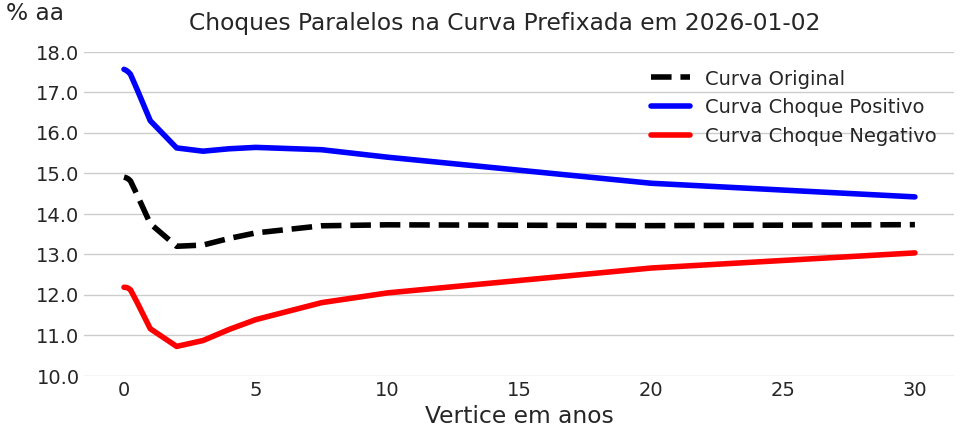
Para visualizar os choques, use:
resultado = resultado_neg["curva"][resultado_neg["curva"].columns[1:]]
resultado.columns = ["Curva Original", "Curva Choque Negativo"]
resultado = pd.concat(
    [resultado, resultado_pos["curva"][resultado_pos["curva"].columns[2:]]],
    axis=1,
).multiply(100)
resultado.columns = ["Curva Original", "Curva Choque Positivo", "Curva Choque Negativo"]

plt.figure(figsize=(10, 6))
plt.plot(resultado[["Curva Original"]], "k--")
plt.plot(resultado[["Curva Choque Positivo"]], "b")
plt.plot(resultado[["Curva Choque Negativo"]], "r")
plt.xlabel("Vértice em anos")
plt.ylabel("% aa", loc="top", rotation=0, labelpad=-20)
locs, _ = plt.yticks()
plt.yticks(locs, np.round(locs, 1))
plt.suptitle(f"Choques Paralelos na Curva Prefixada em {data_choque}")
plt.legend(resultado.columns)
plt.box(False)
plt.grid(axis="y")
plt.show()
Para visualizar os parâmetros e demais resultados:
print("=== Análise de Componentes Principais ===")
print(modelo.pca)

print("=== Parâmetros Estimados ===")
print(modelo.parametros)

print("=== Resumo do Modelo ===")
resumo = modelo.resumo()
print(resumo)

print(f"Número de componentes: {modelo.num_componentes}")

# Vértices usados na calibração (em dias corridos)
print(f"Vértices: {modelo.vertices_dias}")
1 maintainer

Release files for pyettj 0.4.2
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| pyettj-0.4.2.tar.gz | 37.4 kB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| pyettj-0.4.2-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 72.8 kB
Release files / pyettj-0.4.2.tar.gz
| Download URL | pyettj-0.4.2.tar.gz |
|---|---|
| Size | 37.4 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
e9dc1f92097443d45af01fe456a9814f88461ee331f8c9db8f8732d340942254
|
|
BLAKE2b-256 checksum How to use checksums |
947d7fb61aa58abc42b46eeec4437be923a6a12a42c2dbaaabfefb8a8d35ad1e
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.12.10
|
Release files / pyettj-0.4.2-py3-none-any.whl
| Download URL | pyettj-0.4.2-py3-none-any.whl |
|---|---|
| Size | 35.4 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
bef6f93584a50de0af1f9c5ed0a3a5056cd8d77c3f72635722a68d9640deada7
|
|
BLAKE2b-256 checksum How to use checksums |
f7e04adf92e1b565306c2eebb3e9f1d3445f95df97a5061da21b5c03d7c2f21a
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
No |
| Uploaded via |
twine/7.0.0 CPython/3.12.10
|














