
ruTS
Russian Texts Statistics - библиотека для извлечения статистик из текстов на русском языке
Документация · Демо · PyPI · English




ruTS считает по русскому тексту то, для чего обычно приходится собирать несколько разрозненных инструментов: базовые статистики, метрики удобочитаемости и лексического разнообразия, морфологические признаки. Функционал основан на адаптированных для русского языка статистиках библиотеки textacy.
Работать можно как с обычными строками, так и с готовыми Doc-объектами spaCy - каждая статистика доступна и как отдельный класс, и как компонент пайплайна spaCy.
Попробовать без установки можно в демо на Hugging Face Spaces: вставьте текст и получите класс удобочитаемости, метрики, графики и подсветку фрагментов.
- Извлечение объектов - настраиваемые токенизаторы слов, предложений и символьных N-грамм
- Базовые статистики - количество слов, предложений, слогов, знаков препинания и их распределения
- Метрики удобочитаемости - тест Флеша-Кинкайда, индекс SMOG, LIX и другие, с коэффициентами для русского языка
- Метрики лексического разнообразия - TTR и его вариации, MTLD, HD-D, индексы Симпсона и Юла, энтропия, законы Ципфа и Хипса
- Морфологические статистики - часть речи, падеж, наклонение, переходность и другие признаки в терминах Universal Dependencies
- SEO-метрики стиля - тошнота, водность, заспамленность, естественность по Ципфу, плотность ключевых слов, лексические маркеры канцелярита
- Фоностатистики - классы звуков, кластеры, аллитерация и ассонанс, слоги по правилу восходящей звучности
- Синтаксические статистики - длины зависимостей, глубина дерева, сочинительные цепочки, клаузы, обороты, пассив, цепочки родительных падежей, расщеплённые сказуемые и другие маркеры канцелярита по разбору spaCy
- Статистики связности - повторы существительных, аргументов и знаменательных слов между предложениями, данность, темпоральная связность, коннекторы по классам
- Статистики лексической сложности - частотность слов по словарю Ляшевской и Шарова, частотные полосы, сюрпризал, лексическая плотность
- Корпусные меры - ключевые слова относительно эталонного корпуса или частотного словаря, коллокации, дисперсия слов, конкорданс KWIC, стилометрия: дельта Барроуза, Zeta, хи-квадрат Килгарриффа, кривая Менденхолла, профиль служебных слов; сравнение корпусов по всем признакам с размерами эффектов
- Наборы данных - готовые предобработанные корпуса с фильтрацией
- Визуализации - закон Ципфа, литературная дактилоскопия, дерево слов, подсветка текста в стиле Главреда, дисперсия и ключевые слова, сеть коллокаций, дендрограмма и PCA по дельте, рост словаря, длины предложений
- Компоненты spaCy - встраивание любой статистики в пайплайн
Установка
Требуется Python 3.11 или новее.
pip install ruts
Или с помощью uv:
uv add ruts
Для работы с компонентами spaCy и синтаксическими статистиками понадобится русскоязычная модель:
python -m spacy download ru_core_news_sm
Быстрый старт
>>> from ruts import BasicStats, DiversityStats, ReadabilityStats

>>> text = "Существуют три вида лжи: ложь, наглая ложь и статистика"

>>> BasicStats(text).get_stats()
{'c_letters': {1: 1, 3: 2, 4: 3, 6: 1, 10: 2},
 'c_syllables': {1: 5, 2: 1, 3: 1, 4: 2},
 'n_sents': 1,
 'n_words': 9,
 'n_unique_words': 8,
 'n_long_words': 3,
 'n_complex_words': 2,
 'n_simple_words': 7,
 'n_monosyllable_words': 5,
 'n_polysyllable_words': 4,
 'n_chars': 55,
 'n_letters': 45,
 'n_spaces': 8,
 'n_syllables': 18,
 'n_punctuations': 2,
 'c_punctuations': {'comma': 1, 'period': 0, 'question': 0, 'exclamation': 0,
                    'ellipsis': 0, 'colon': 1, 'semicolon': 0, 'dash': 0,
                    'hyphen': 0, 'angle_quotes': 0, 'straight_quotes': 0,
                    'parentheses': 0, 'other': 0}}

>>> ReadabilityStats(text).flesch_reading_easy
74.93500000000003

>>> DiversityStats(text).ttr
0.8888888888888888
Возможности
Извлечение объектов
Библиотека позволяет создавать свои инструменты для извлечения предложений, слов и символьных N-грамм из текста, которые затем можно использовать при вычислении статистик и в стилометрии.
>>> import re
>>> from nltk.corpus import stopwords
>>> from ruts import CharNgramsExtractor, SentsExtractor, WordsExtractor

>>> text = "Не имей 100 рублей, а имей 100 друзей"

>>> se = SentsExtractor(tokenizer=re.compile(r', '))
>>> se.extract(text)
('Не имей 100 рублей', 'а имей 100 друзей')

>>> we = WordsExtractor(use_lexemes=True, stopwords=stopwords.words('russian'), filter_nums=True, ngram_range=(1, 2))
>>> we.extract(text)
('иметь', 'рубль', 'иметь', 'друг', 'иметь_рубль', 'рубль_иметь', 'иметь_друг')

>>> we.get_most_common(3)
[('иметь', 2), ('рубль', 1), ('друг', 1)]

>>> ce = CharNgramsExtractor(n=3, lowercase=True)
>>> ce.extract(text)[:5]
('не ', 'е и', ' им', 'име', 'мей')
>>> ce.get_most_common(2)
[(' им', 2), ('име', 2)]
Подробнее - в документации: слова, предложения, символьные N-граммы.
Базовые статистики
Библиотека позволяет извлекать из текста следующие статистические показатели:
- количество предложений
- количество слов
- количество уникальных слов
- количество длинных слов
- количество сложных слов
- количество простых слов
- количество односложных слов
- количество многосложных слов
- количество символов
- количество букв
- количество пробелов
- количество слогов
- количество знаков препинания
- распределение слов по количеству букв
- распределение слов по количеству слогов
Любую статистику можно вывести на экран в читаемом виде:
>>> from ruts import BasicStats

>>> text = "Существуют три вида лжи: ложь, наглая ложь и статистика"
>>> BasicStats(text).print_stats()
     Статистика     | Значение
------------------------------
Предложения         |    1
Слова               |    9
Уникальные слова    |    8
Длинные слова       |    3
Сложные слова       |    2
Простые слова       |    7
Односложные слова   |    5
Многосложные слова  |    4
Символы             |    55
Буквы               |    45
Пробелы             |    8
Слоги               |    18
Знаки препинания    |    2
Подробнее - в документации.
Метрики удобочитаемости
Библиотека позволяет вычислять для текста следующие метрики удобочитаемости:
- Тест Флеша-Кинкайда
- Индекс удобочитаемости Флеша
- Индекс Колман-Лиау
- Индекс SMOG
- Автоматический индекс удобочитаемости
- Индекс удобочитаемости LIX
- Индекс удобочитаемости RIX
- Формула Соловьёва, Иванова, Солнышкиной
- Формула Мацковского
- Индекс Дейла-Чейла
- Индекс Ганнинга
Поверх формул работает интерпретирующий слой: сводный класс по медиане формул класса, соответствие класса возрасту читателя по таблице plainrussian и время чтения.
Коэффициенты формул, адаптированных для русского языка, задаются пресетом preset: по умолчанию используются коэффициенты проекта Plain Russian Language, полученные на текстах с метками класса (plainrussian), доступны также коэффициенты Оборневой для художественных текстов (fiction) и казанской группы (Соловьёв, Иванов, Солнышкина) для учебных (academic).
>>> from pprint import pprint
>>> from ruts import ReadabilityStats

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"
>>> rs = ReadabilityStats(text)

>>> pprint(rs.get_stats())
{'automated_readability_index': 0.2941666666666656,
 'coleman_liau_index': 1.1700000000000053,
 'consensus_grade': 1.5,
 'dale_chall_index': 4.095000000000001,
 'flesch_kincaid_grade': -2.0633333333333326,
 'flesch_reading_easy': 87.16833333333334,
 'gunning_fog_index': 6.0,
 'lix': 28.333333333333336,
 'matskovsky_index': 9.351,
 'reading_time': 0.08333333333333333,
 'rix': 2.0,
 'sis_grade': 1.5166666666666675,
 'smog_index': 0.05}

>>> rs.print_stats()
                   Метрика                   | Значение
-------------------------------------------------------
Тест Флеша-Кинкайда                          |  -2.06
Индекс удобочитаемости Флеша                 |  87.17
Индекс Колман-Лиау                           |   1.17
Индекс SMOG                                  |   0.05
Автоматический индекс удобочитаемости        |   0.29
Индекс удобочитаемости LIX                   |  28.33
Индекс удобочитаемости RIX                   |   2.00
Формула Соловьёва, Иванова, Солнышкиной      |   1.52
Формула Мацковского                          |   9.35
Индекс Дейла-Чейла                           |   4.10
Индекс Ганнинга                              |   6.00
Сводный класс                                |   1.50
Время чтения (мин.)                          |   0.08

>>> rs.describe_grade()
'1-3-й класс (6-8 лет)'
Подробнее - в документации.
Метрики лексического разнообразия
Библиотека позволяет вычислять для текста следующие метрики лексического разнообразия:
- Type-Token Ratio (TTR)
- Root Type-Token Ratio (RTTR)
- Corrected Type-Token Ratio (CTTR)
- Herdan Type-Token Ratio (HTTR)
- Summer Type-Token Ratio (STTR)
- Maas Type-Token Ratio (MTTR)
- Dugast Type-Token Ratio (DTTR)
- Moving Average Type-Token Ratio (MATTR)
- Mean Segmental Type-Token Ratio (MSTTR)
- Measure of Textual Lexical Diversity (MTLD)
- Moving Average Measure of Textual Lexical Diversity (MA-MTLD)
- MTLD со скользящим окном и заворотом текста (MTLD-W)
- Hypergeometric Distribution D (HD-D)
- Индекс Симпсона (D), обратный индекс Симпсона (1/D) и индекс Джини-Симпсона (1-D)
- Гапакс-индекс (Honoré's R), доля гапаксов, меры Баайена (P) и показатель α₂
- Характеристики Юла (K и I), меры Хердана (Vm), Сишела (S), Мишеа (M), Брюне (W) и Дюга (k)
- Энтропия Шеннона, выравненность и перплексия
- Наклон закона Ципфа (α) и показатель закона Хипса (β)
Окна, пороги и основание логарифма вынесены в параметры DiversityStats, любую метрику можно посчитать по окнам с доверительным интервалом методом windowed. Часть реализаций метрик взята из проекта lexical_diversity, формулы мер по спектру частот сверены с Tweedie и Baayen (1998), zipfR и quanteda.
>>> from pprint import pprint
>>> from ruts import DiversityStats

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"

>>> pprint(DiversityStats(text).get_stats())
{'alpha2': 0.5,
 'baayen_p': 0.5333333333333333,
 'brunet_w': 6.00637847898991,
 'cttr': 2.008316044185609,
 'dttr': 10.268784661968118,
 'dugast_k': 14.783895126869226,
 'entropy': 3.3232314287976203,
 'evenness': 0.9606293157795304,
 'gini_simpson_index': 0.9523809523809523,
 'hapax_index': 992.9517404041437,
 'hapax_ratio': 0.7272727272727273,
 'hdd': nan,
 'heaps_beta': 0.8366147342060046,
 'herdan_vm': 0.1421338109037403,
 'httr': 0.8854692840710255,
 'inverse_simpson_index': 21.0,
 'mamtld': 12.0,
 'mattr': 0.7333333333333333,
 'michea_m': 5.5,
 'msttr': 0.7333333333333333,
 'mtld': 15.0,
 'mtldw': 13.25,
 'mttr': 0.09738250756232528,
 'perplexity': 10.009038104159247,
 'rttr': 2.840187787218772,
 'sichel_s': 0.18181818181818182,
 'simpson_index': 0.047619047619047616,
 'sttr': 0.2500605793160848,
 'ttr': 0.7333333333333333,
 'yule_i': 8.642857142857142,
 'yule_k': 444.44444444444446,
 'zipf_alpha': 0.4884512334695912}

>>> DiversityStats(text).windowed("ttr", window_len=5)
WindowStats(mean=0.9333333333333332, std=0.11547005383792512, lower=0.6464898180167025, upper=1.220176848649964, n_windows=3)
Подробнее - в документации.
Морфологические статистики
Библиотека позволяет извлекать из текста следующие морфологические признаки:
- часть речи
- одушевленность
- вид
- падеж
- род
- совместность
- наклонение
- число
- лицо
- время
- переходность
- форма глагола
- залог
Значения выдаются в терминах Universal Dependencies: для Doc spaCy с разметкой они берутся из token.pos_ и token.morph с учётом контекста, для строки - из первого разбора pymorphy3 с переводом граммем OpenCorpora в UD.
>>> from pprint import pprint
>>> from ruts import MorphStats

>>> text = "Постарайтесь получить то, что любите, иначе придется полюбить то, что получили"
>>> ms = MorphStats(text)

>>> ms.pos
('VERB', 'VERB', 'CCONJ', 'SCONJ', 'VERB', 'ADV', 'VERB', 'VERB', 'CCONJ', 'SCONJ', 'VERB')

>>> pprint(ms.get_stats())
{'animacy': {None: 11},
 'aspect': {None: 5, 'Imp': 1, 'Perf': 5},
 'case': {None: 11},
 'gender': {None: 11},
 'involvement': {None: 10, 'Ex': 1},
 'mood': {None: 7, 'Imp': 1, 'Ind': 3},
 'number': {None: 7, 'Plur': 3, 'Sing': 1},
 'person': {None: 9, '2': 1, '3': 1},
 'pos': {'ADV': 1, 'CCONJ': 2, 'SCONJ': 2, 'VERB': 6},
 'tense': {None: 8, 'Fut': 1, 'Past': 1, 'Pres': 1},
 'transitivity': {None: 5, 'Intr': 2, 'Tran': 4},
 'verb_form': {None: 5, 'Fin': 4, 'Inf': 2},
 'voice': {None: 11}}

>>> ms.print_stats('pos', 'tense')
---------------Часть речи---------------
Глагол                        |    6
Сочинительный союз            |    2
Подчинительный союз           |    2
Наречие                       |    1

-----------------Время------------------
Неизвестно                    |    8
Настоящее                     |    1
Будущее                       |    1
Прошедшее                     |    1
Отдельные слова можно разобрать с расшифровкой признаков через ms.explain_text(filter_none=True).
Подробнее - в документации.
SEO-метрики стиля
Библиотека повторяет показатели сервисов Advego и Text.ru:
- Классическая и академическая тошнота
- Водность
- Заспамленность
- Естественность по закону Ципфа
- Плотность ключевых слов и фраз
- Лексические маркеры канцелярита: отглагольные существительные, производные предлоги, вводные слова, штампы
Точные формулы сервисов не опубликованы, поэтому реализованы общепринятые определения; стоп-слова для водности определяются по части речи с помощью pymorphy3 или задаются списком.
>>> from pprint import pprint
>>> from ruts import StyleStats

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"
>>> ss = StyleStats(text)

>>> pprint(ss.get_stats())
{'academic_nausea': 93.33333333333333,
 'classic_nausea': 1.7320508075688772,
 'cliches': 0.0,
 'compound_prepositions': 0.0,
 'parentheticals': 0.0,
 'spam': 26.666666666666668,
 'verbal_nouns': 0.0,
 'water': 46.666666666666664,
 'zipf_naturalness': 33.333333333333336}

>>> ss.keyword_density("когда", "нет а")
{'когда': 20.0, 'нет а': 13.333333333333334}

>>> ss = StyleStats("В целях повышения качества в кратчайшие сроки, как правило, проводится проверка")
>>> ss.verbal_nouns, ss.compound_prepositions, ss.parentheticals, ss.cliches
(16.666666666666664, 9.090909090909092, 9.090909090909092, 9.090909090909092)
Подробнее - в документации.
Фоностатистики
Библиотека считает по буквам, без учета оглушения и ударения:
- Доли гласных, сонорных, звонких и глухих согласных, отношение согласных к гласным
- Консонантные кластеры и зияния гласных
- Энтропию CV-шаблонов слов и «жёсткость»
- Индексы аллитерации и ассонанса относительно ожидаемых повторов
- Слоги по правилу восходящей звучности: доля открытых слогов, средняя длина слога, CV-шаблоны
>>> from pprint import pprint
>>> from ruts import PhonStats
>>> from ruts.phon_stats import syllabify

>>> text = "Ног нет, а хожу, рта нет, а скажу: когда спать, когда вставать, когда работу начинать"
>>> ps = PhonStats(text)

>>> pprint(ps.get_stats())
{'alliteration': 0.9149440867502556,
 'assonance': 0.802520508857449,
 'consonant_vowel_ratio': 1.48,
 'cv_entropy': 3.1395722619867223,
 'hardness': 0.5625,
 'mean_syllable_len': 2.6,
 'p_heavy_clusters': 0.034482758620689655,
 'p_hiatus': 0.0,
 'p_open_syllables': 0.76,
 'p_sonorants': 0.11290322580645161,
 'p_voiced': 0.1935483870967742,
 'p_voiceless': 0.2903225806451613,
 'p_vowels': 0.4032258064516129}

>>> syllabify("здравствуйте")
['здра', 'вствуй', 'те']
Подробнее - в документации.
Синтаксические статистики
Библиотека считает по дереву зависимостей spaCy (нужна модель с парсером):
- Длины зависимостей, глубину дерева, число листьев и поддеревьев, валентность глаголов
- Сочинительные цепочки, клаузы и придаточные
- Модификаторы именной группы и цепочки родительных падежей
- Причастные и деепричастные обороты, пассив, инфинитивы и отрицания
- Синтаксические маркеры канцелярита: расщеплённые сказуемые («осуществлять проверку»), отношение существительных к глаголам
>>> import spacy
>>> from ruts import SyntaxStats

>>> nlp = spacy.load('ru_core_news_sm')
>>> text = "Дом, построенный рабочими в прошлом году, был продан. Он сказал, что не придёт, и ушёл, хлопнув дверью."
>>> ss = SyntaxStats(nlp(text))

>>> ss.tree_depth, ss.mean_dependency_distance
(4.0, 1.9333333333333333)
>>> ss.clauses_per_sent, ss.subordinate_clauses_per_sent
(1.5, 0.5)
>>> ss.participle_clauses_per_sent, ss.converb_clauses_per_sent, ss.p_passive
(0.5, 0.5, 0.4)
Подробнее - в документации.
Статистики связности
Библиотека считает по леммам (spaCy для Doc с разметкой, pymorphy3 для строки), разбор зависимостей не нужен:
- Повторы существительных, аргументов и знаменательных слов между соседними предложениями и всеми парами предложений (бинарные и пропорциональные, как в Coh-Metrix)
- Данность: доля местоимений, отношение местоимений к существительным, доля указательных и уже встречавшихся знаменательных слов
- Темпоральную связность: повтор времени и вида глаголов в соседних предложениях
- Плотность коннекторов на 1000 слов по классам (причинные, противительные, уступительные, временные, аддитивные, условные, переформулирующие) и типам по собственному словарю из 317 единиц
>>> from ruts import CohesionStats

>>> text = "Кот сидел на окне. Он смотрел на птиц. Птицы улетели, и кот уснул. Завтра он снова будет сидеть на этом окне."
>>> cs = CohesionStats(text)

>>> cs.noun_overlap_adjacent, cs.noun_overlap_all
(0.3333333333333333, 0.5)
>>> cs.argument_overlap_all, cs.content_overlap_prop_adjacent
(0.6666666666666666, 0.1111111111111111)
>>> cs.p_pronouns, cs.p_given, cs.temporal_cohesion
(0.14285714285714285, 0.2857142857142857, 0.5)

>>> cs = CohesionStats("Кот ждал птиц, потому что был голоден. Однако птицы улетели, и всё же кот не ушёл.")
>>> cs.connectors_causal, cs.connectors_adversative, cs.connectors_concessive
(62.5, 62.5, 62.5)
Подробнее - в документации.
Статистики лексической сложности
Насколько слова текста редки относительно языка (lexical sophistication по образцу TAALES):
- Средняя частотность, диапазон и дисперсия лемм по частотному словарю Ляшевской и Шарова (загружается один раз:
FreqDict().download()) - Доли слов из частотных полос топ-1000, 2000, 5000 и 10000 по вшитому списку Шарова - работают без словаря
- Сюрпризал и перплексия по униграммной модели словаря, покрытие словарём, лексическая плотность
- Формула Соловьёва, Иванова, Солнышкиной с частотностью -
ReadabilityStats.sis_grade_by_freq
>>> from ruts import LexicalStats
>>> from ruts.datasets import FreqDict

>>> FreqDict().download()
>>> ls = LexicalStats("Кот сидел на окне и смотрел на птиц")

>>> ls.mean_ipm_content, ls.mean_log_ipm, ls.surprisal
(324.18, 3.0674194359404705, 9.74182176626998)
>>> ls.p_top1000, ls.p_top10000, ls.lexical_density
(0.75, 1.0, 0.625)

>>> LexicalStats("Фелинолог пребывал на подоконнике").p_beyond_top10000
0.25
Подробнее - в документации.
Корпусные меры
Инструменты корпусной лингвистики над списками слов - функции подпакета ruts.corpus, результаты - списки именованных кортежей (pd.DataFrame(result) даёт таблицу):
- Ключевые слова относительно эталонного корпуса или частотного словаря Ляшевской и Шарова: G² с p-значением, Log Ratio, %DIFF, BIC, ELL, отношение шансов
- Коллокации в окне по logDice, MI, MI³, t-score, Dice, G², NPMI, минимальной чувствительности; сочетаемость одного слова
- Дисперсия слов по частям текста: DP Гриса, D Жюйана, D2 Кэрролла, S Розенгрена, дивергенция Кульбака-Лейблера
- Конкорданс KWIC по словоформе или лемме; подгонка закона Ципфа-Мандельброта -
fit_zipf_mandelbrotвruts.diversity_stats - Стилометрия: дельта Барроуза с вариантами (квадратичная, Эдера, косинусная) по словам или символьным N-граммам, Zeta с логарифмической Zeta, хи-квадрат Килгарриффа, кривая Менденхолла, профиль служебных слов
- Сравнение корпусов
compare_corpora: 130 признаков текста (базовые, удобочитаемость, разнообразие, морфология, ритм предложений, профиль пунктуации) по окнам одинаковой длины, для каждого - критерий Манна-Уитни с поправкой Холма, d Коэна, дельта Клиффа, AUC и бутстрэп-интервал разности медиан
>>> from ruts import WordsExtractor
>>> from ruts.corpus import keyness, collocations, dispersion, kwic, print_kwic, delta, zeta

>>> we = WordsExtractor(use_lexemes=True, lowercase=True)
>>> text = "Кот сидел на окне и смотрел на птиц. Птицы улетели, и кот уснул на окне. Завтра кот снова будет сидеть на окне и смотреть на птиц."
>>> target = we.extract(text)
>>> reference = we.extract("Собака лежала на полу и дремала. Потом собака ела и снова дремала. Завтра собака будет гулять.")

>>> [(k.word, round(k.g2, 2), round(k.log_ratio, 2)) for k in keyness(target, reference, top_n=2)]
[('кот', 2.88, 1.88), ('окно', 2.88, 1.88)]
>>> [(c.left, c.right, c.freq_pair, round(c.score, 2)) for c in collocations(target, window=2, top_n=2)]
[('птица', 'улететь', 2, 13.0), ('и', 'смотреть', 2, 12.68)]
>>> [(d.word, round(d.dp, 2)) for d in dispersion(target, parts=3, min_freq=3)][:3]
[('на', 0.15), ('кот', 0.32), ('окно', 0.03)]
>>> print_kwic(kwic(text, "окно", by_lemma=True, window=2), width=16)
        сидел на  окне  и смотрел
        уснул на  окне  . Завтра кот
       сидеть на  окне  и смотреть

>>> both = we.extract("Кот и собака дремали на окне. Завтра кот будет смотреть на птиц, а собака - спать на полу.")
>>> delta({"кот": target, "собака": reference, "кот и собака": both}, n_mfw=10).round(2)
               кот  собака  кот и собака
кот           0.00    1.74          0.96
собака        1.74    0.00          1.11
кот и собака  0.96    1.11          0.00
>>> [(z.word, round(z.zeta, 2)) for z in zeta(target, reference, segment_size=5, top_n=2)]
[('на', 0.67), ('кот', 0.6)]
Подробнее - в документации: корпусные меры, стилометрия.
Наборы данных
Библиотека позволяет работать с несколькими заранее предобработанными наборами данных:
- sov_chrest_lit - советские хрестоматии по литературе
- stalin_works - полное собрание сочинений И.В. Сталина
- freq2011 - частотный словарь Ляшевской и Шарова: 52 138 лемм с ipm, диапазоном и дисперсией по НКРЯ
- texts_by_grade - тексты с метками класса проекта Plain Russian Language (CC0), на которых проверяются формулы удобочитаемости
- poetry_corpus - корпус русской поэзии PoetryCorpus Ильи Гусева: 16 694 стихотворения 195 авторов с годами и темами (Apache-2.0)
- russian_literature - собрание русской классической литературы RusLit: 373 произведения 12 авторов в трёх жанрах с годами написания (общественное достояние)
Существует возможность работать как с чистыми текстами (без заголовочной информации), так и с записями, а также фильтровать их по различным критериям.
>>> from pprint import pprint
>>> from ruts.datasets import SovChLit

>>> sc = SovChLit()
>>> sc.info
{'Наименование': 'sov_chrest_lit',
 'url': 'https://dataverse.harvard.edu/file.xhtml?fileId=3670902&version=DRAFT',
 'description': 'Корпус советских хрестоматий по литературе',
 'author': 'Шкарин С.С.'}

>>> for record in sc.get_records(max_len=100, category='Весна', limit=1):
...     pprint(record)
{'author': 'С. Маршак',
 'book': 'Родная речь. Книга для чтения в I классе начальной школы',
 'category': 'Весна',
 'file': PosixPath('.../ruts_data/texts/sov_chrest_lit/grade_1/114'),
 'grade': 1,
 'subject': 'Март',
 'text': 'Рыхлый снег темнеет в марте, тают льдинки на окне.\n'
         'Зайчик бегает по парте и по карте на стене.',
 'type': 'Стихотворение',
 'year': 1963}
Набор данных скачивается методом download() и кэшируется локально, повторный вызов ничего не качает; до загрузки get_texts() и get_records() поднимают OSError с подсказкой. Корпус поэзии и классическая литература загружаются с первоисточников по закреплённым коммитам с проверкой SHA-256.
Визуализации
Библиотека позволяет визуализировать тексты с помощью следующих видов графиков:
- Закон Ципфа (Zipf's law)
- Литературная дактилоскопия (Literature Fingerprinting)
- Дерево слов (Word Tree)
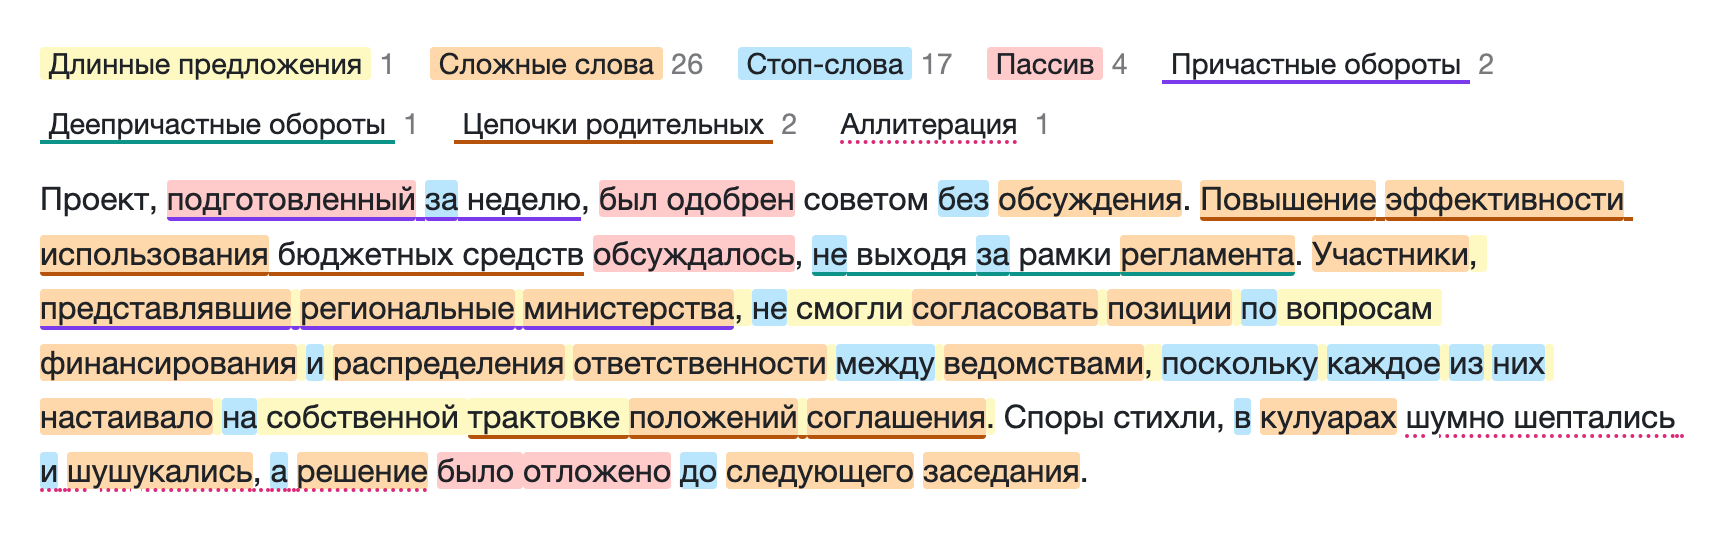
- Подсветка текста по 15 слоям в пяти группах: читаемость (длинные предложения, сложные и редкие слова), синтаксис (пассив, обороты, цепочки родительных, расщеплённые сказуемые), канцелярит (отглагольные существительные, производные предлоги, штампы), стиль (стоп-слова, вводные слова, коннекторы), фоника (аллитерации)
- Корпусные графики: лексическая дисперсия, диаграмма ключевых слов, сеть коллокаций
- Стилометрические графики: дендрограмма, главные компоненты и многомерное шкалирование по дельте, кривые Менденхолла
- Рост словаря и спектр частот, длины предложений со скользящим средним
Графики matplotlib принимают оси ax и возвращают Axes, поэтому их можно раскладывать по одной фигуре. Подсветка возвращает объект, который отображается в Jupyter как HTML с легендой и всплывающими пояснениями; по умолчанию включены шесть слоёв, layers="all" включает все; синтаксические слои требуют Doc с разбором зависимостей:
>>> import spacy
>>> from ruts.visualizers import highlight

>>> nlp = spacy.load('ru_core_news_sm')
>>> text = (
...     "Проект, подготовленный за неделю, был одобрен советом без обсуждения. "
...     "Повышение эффективности использования бюджетных средств обсуждалось, не выходя за рамки регламента. "
...     "Участники, представлявшие региональные министерства, не смогли согласовать позиции по вопросам "
...     "финансирования и распределения ответственности между ведомствами, поскольку каждое из них "
...     "настаивало на собственной трактовке положений соглашения. "
...     "Споры стихли, в кулуарах шумно шептались и шушукались, а решение было отложено до следующего заседания."
... )
>>> ht = highlight(nlp(text))
>>> ht.counts
{'long_sents': 1, 'complex_words': 26, 'passive': 4, 'genitive_chains': 2, 'split_predicates': 0, 'cliches': 1}
>>> highlight(nlp(text), layers=["verbal_nouns", "connectors", "rare_words"]).counts
{'rare_words': 3, 'verbal_nouns': 10, 'connectors': 4}
>>> ht  # в Jupyter отобразится подсветка, разметка доступна через ht.to_html()
>>> from collections import Counter
>>> from nltk.corpus import stopwords
>>> from ruts import WordsExtractor
>>> from ruts.datasets import SovChLit
>>> from ruts.visualizers import zipf

>>> sc = SovChLit()
>>> text = "\n".join(text for text in sc.get_texts(limit=100))
>>> we = WordsExtractor(use_lexemes=True, stopwords=stopwords.words("russian"), filter_nums=True)
>>> tokens_with_count = Counter(we.extract(text))
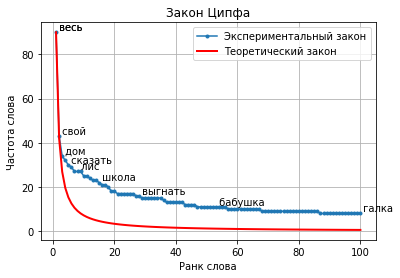
>>> zipf(tokens_with_count, num_words=100, num_labels=10, log=False, show_theory=True, alpha=1.1)
Компоненты spaCy
Библиотека позволяет создавать компоненты spaCy для следующих классов:
BasicStatsCohesionStatsDiversityStatsLexicalStatsMorphStatsPhonStatsReadabilityStatsStyleStatsSyntaxStats
>>> import ruts
>>> import spacy

>>> nlp = spacy.load('ru_core_news_sm')
>>> nlp.add_pipe('basic', last=True)

>>> doc = nlp("Существуют три вида лжи: ложь, наглая ложь и статистика")
>>> doc._.basic.c_letters
{1: 1, 3: 2, 4: 3, 6: 1, 10: 2}

>>> doc._.basic.n_words
9
Значения совпадают с примером выше: знаки препинания и пробельные токены spaCy при подсчёте отфильтровываются.
Подробнее - в документации.
Разработка
Проект использует uv для управления зависимостями и ruff для линтинга и форматирования.
git clone https://github.com/SergeyShk/ruTS.git
cd ruTS

make deps        # создать окружение и установить зависимости
make nltk-data   # загрузить данные NLTK, нужные для тестов
make test        # запустить тесты
make lint        # ruff + mypy
Полный список команд - make help.
Перед отправкой изменений стоит установить хуки, которые прогонят линтеры на коммите и тесты на пуше:
uv run pre-commit install
Участие в проекте
Баг-репорты, идеи и пул-реквесты приветствуются - issues открыты. Перед отправкой пул-реквеста убедитесь, что make lint и make test проходят без ошибок.
Структура проекта
- docs - документация по проекту
- ruts:
- basic_stats.py - базовые текстовые статистики
- cohesion_stats.py - статистики связности текста
- components.py - компоненты spaCy
- constants.py - основные используемые константы
- diversity_stats.py - метрики лексического разнообразия текста
- extractors.py - инструменты для извлечения объектов из текста
- lexical_stats.py - статистики лексической сложности текста
- morph_stats.py - морфологические статистики
- phon_stats.py - фоностатистики текста
- readability_stats.py - метрики удобочитаемости текста
- style_stats.py - SEO-метрики стиля текста
- syntax_stats.py - синтаксические статистики текста
- utils.py - вспомогательные инструменты
- corpus - корпусные меры:
- collocations.py - коллокации и меры ассоциации
- compare.py - сравнение корпусов по признакам текста
- dispersion.py - дисперсия слов по частям текста
- keyness.py - ключевые слова относительно эталонного корпуса
- kwic.py - конкорданс KWIC
- stylometry.py - дельта Барроуза, Zeta и другие меры стилометрии
- datasets - наборы данных:
- dataset.py - базовый класс для работы с наборами данных
- freq2011.py - частотный словарь Ляшевской и Шарова
- poetry_corpus.py - корпус русской поэзии PoetryCorpus
- russian_literature.py - собрание русской классической литературы RusLit
- sov_chrest_lit.py - советские хрестоматии по литературе
- stalin_works.py - полное собрание сочинений И.В. Сталина
- texts_by_grade.py - тексты с метками класса проекта Plain Russian Language
- resources - вшитые лексические ресурсы (список самых частых лемм, словарь коннекторов)
- visualizers - инструменты для визуализации текстов:
- corpus.py - Лексическая дисперсия, ключевые слова, сеть коллокаций
- fingerprinting.py - Литературная дактилоскопия
- highlight.py - Подсветка текста
- sentences.py - Длины предложений
- stylometry.py - Дендрограмма, главные компоненты, шкалирование, кривые Менденхолла
- vocabulary.py - Закон Хипса и спектр частот
- word_tree.py - Дерево слов
- zipf.py - Закон Ципфа
- tests - тесты, повторяющие структуру пакета
Авторы
- Шкарин Сергей (kouki.sergey@gmail.com)
- Смирнова Екатерина (ekanerina@yandex.ru)
Лицензия
Цитирование
Пожалуйста, используйте следующую BibTeX нотацию для цитирования библиотеки ruTS, если вы используете ее в своих исследованиях или программах. Цитирование является очень полезным для дальнейшей разработки и поддержки данного проекта.
@software{ruTS,
  author = {Sergey Shkarin},
  title = {{ruTS, a library for statistics extraction from texts in Russian}},
  year = 2026,
  publisher = {Moscow},
  url = {https://github.com/SergeyShk/ruTS}
}
1 maintainer

Release files for ruts 0.12.0
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| ruts-0.12.0.tar.gz | 236.1 kB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| ruts-0.12.0-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 480.9 kB
Release files / ruts-0.12.0.tar.gz
| Download URL | ruts-0.12.0.tar.gz |
|---|---|
| Size | 236.1 kB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
0162bb307698703c8c44841dbac86bef27483bd07121ffe42ff8df404694b12f
|
|
BLAKE2b-256 checksum How to use checksums |
b69c264ebb4f89b778df5642852dcdc9f51367f084304175e76f956fee1faaf2
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
uv/0.12.15 {"installer":{"name":"uv","version":"0.12.15","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
|
Release files / ruts-0.12.0-py3-none-any.whl
| Download URL | ruts-0.12.0-py3-none-any.whl |
|---|---|
| Size | 244.7 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
4aa0bcddc605230f1ef874f677ca155a47c37cb54e4995aeb8a7952d64e27248
|
|
BLAKE2b-256 checksum How to use checksums |
29cc53b14373f240db07fd895b4438d2f21d9d90b6d8b065ef8d1d0a5c4131f7
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
uv/0.12.15 {"installer":{"name":"uv","version":"0.12.15","subcommand":["publish"]},"python":null,"implementation":{"name":null,"version":null},"distro":{"name":"Ubuntu","version":"24.04","id":"noble","libc":null},"system":{"name":null,"release":null},"cpu":null,"openssl_version":null,"setuptools_version":null,"rustc_version":null,"ci":true}
|














