


Andere Werkzeuge erzeugen ein PDF. falzmarke prüft das Ergebnis.
Du schreibst den Inhalt als Markdown. falzmarke setzt daraus einen Geschäftsbrief nach DIN 5008:2020 als PDF/A — und misst anschließend das fertige PDF nach. Sitzt die Falzmarke nicht auf 105,0 mm, endet der Lauf mit einem Fehler statt mit einem Brief, der nur ungefähr stimmt.
falzmarke.com — Anleitung ohne Terminal · ⬇ Als Claude-Skill laden · In 60 Sekunden ausprobieren · Beispielbrief ansehen
Linux · macOS · Windows · 34 Maße je Seite · PDF/A-2b · MIT
In Bewegung
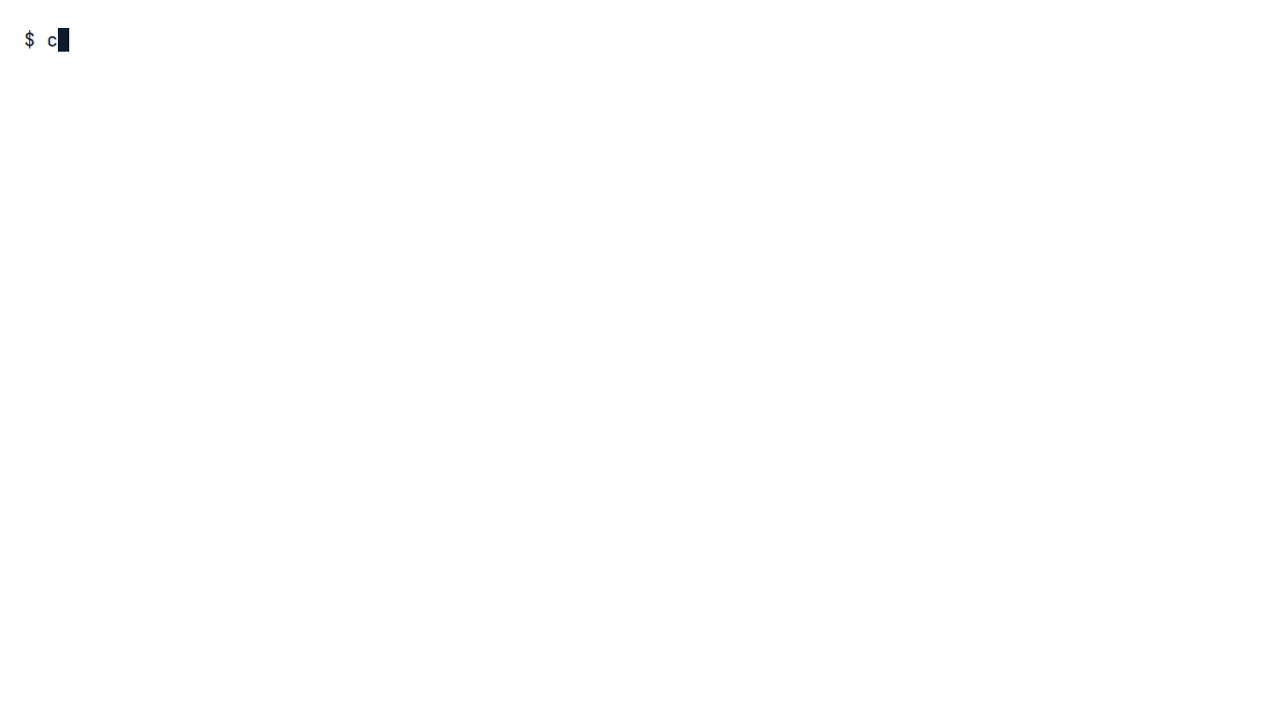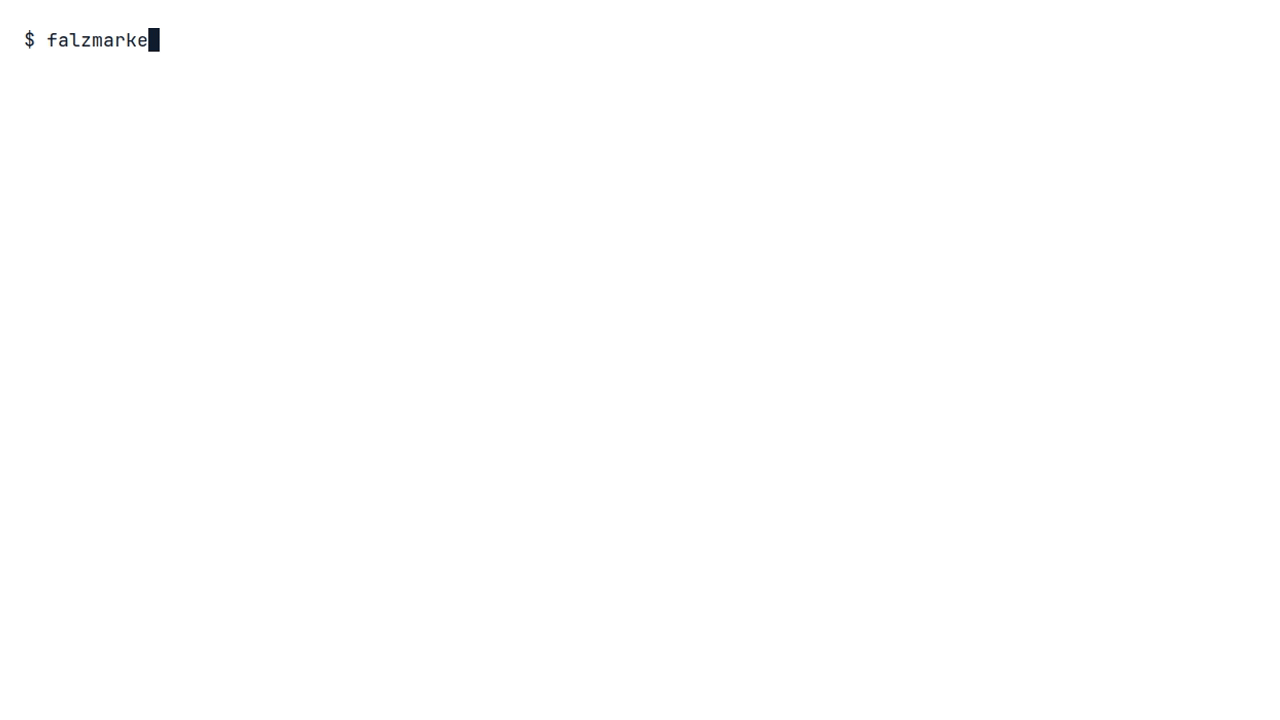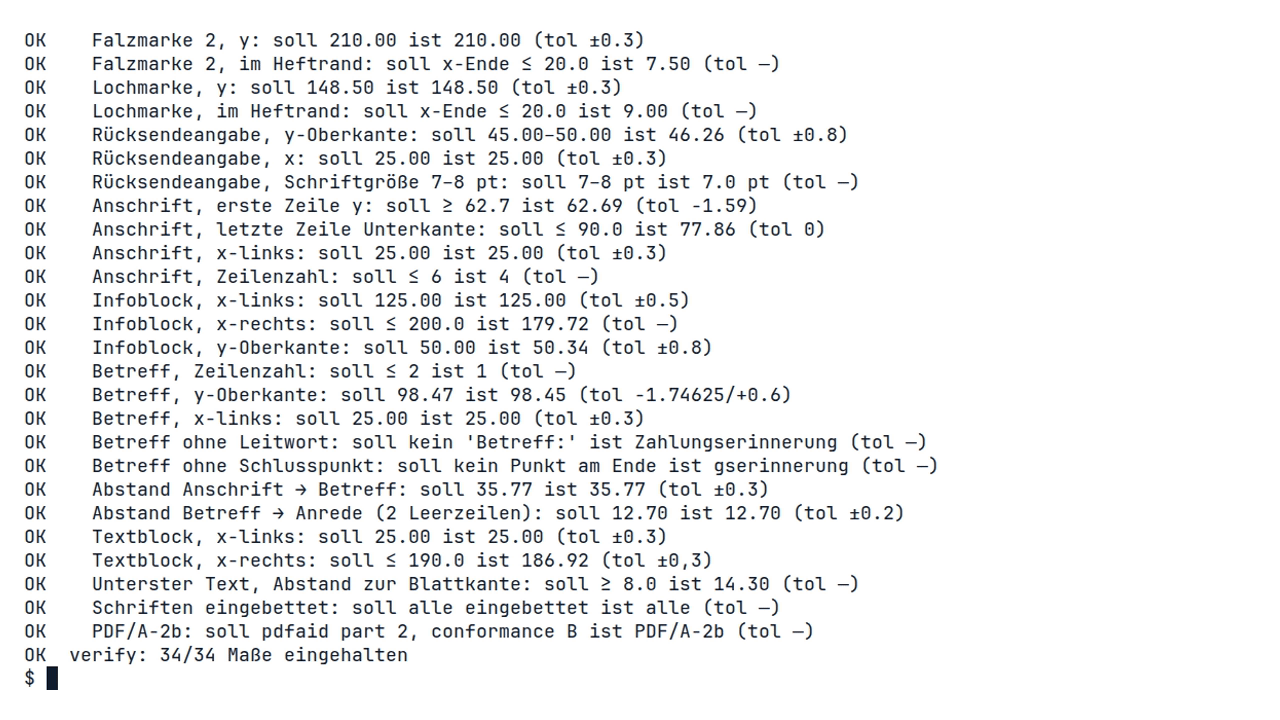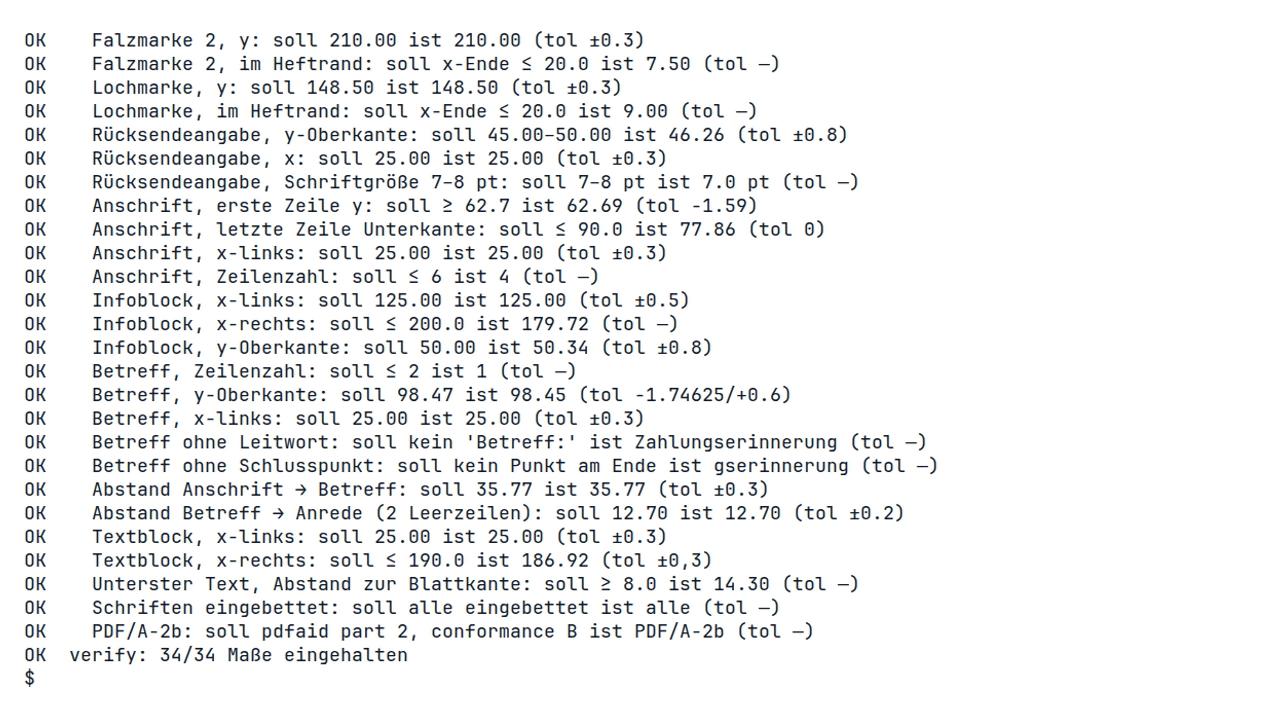
Aufgezeichnet aus der echten CLI mit vhs;
das Drehbuch steht in docs/marke/video/readme.tape.
Ein Test hält den Mitschnitt gegen einen frischen Lauf, damit hier kein Terminal
steht, das es so nie gab (tests/test_tape.py).
Was dabei herauskommt
Und was danach geprüft wird — Auszug aus dem Bericht, den jeder Lauf ausgibt:
OK    Falzmarke 1, y: soll 105.00 ist 105.00 (tol ±0.3)
OK    Infoblock, x-links: soll 125.00 ist 125.00 (tol ±0.5)
OK    Betreff, y-Oberkante: soll 98.47 ist 97.91 (tol -1.75/+0.6)
OK    Abstand Betreff → Anrede (2 Leerzeilen): soll 12.70 ist 12.70 (tol ±0.2)
Das sind vier von 33 Zeilen des Geometrieberichts. Der Film zeigt, wie die übrigen entstehen: Eine Linie fährt das Blatt ab und hält an jedem gemessenen Höhenmaß. Sie hält dort, wo die Messung es sagt — bei diesen Prüfungen ist der gemessene Wert zugleich die Stelle.
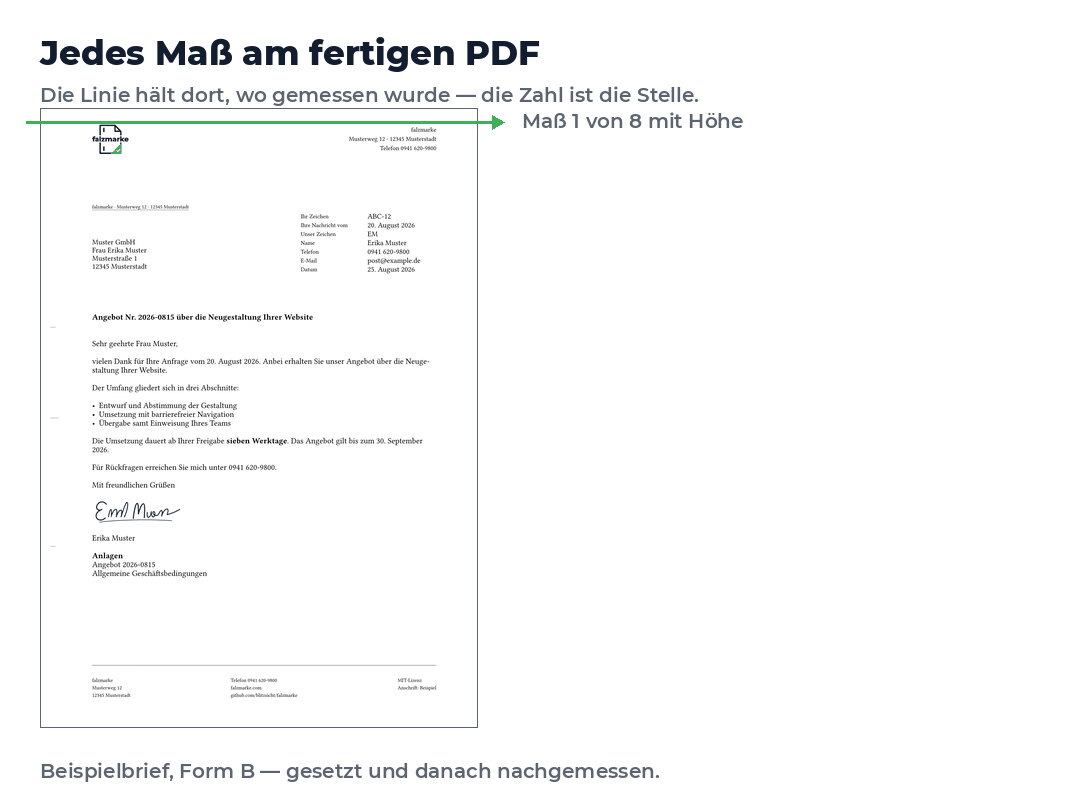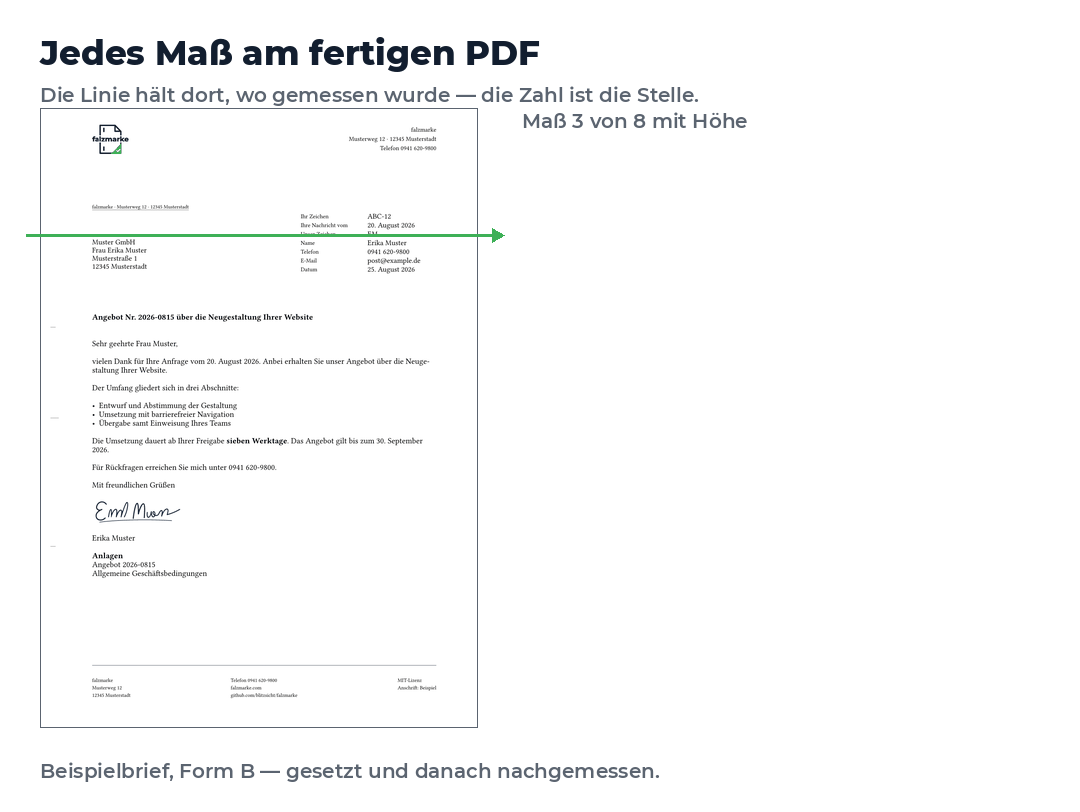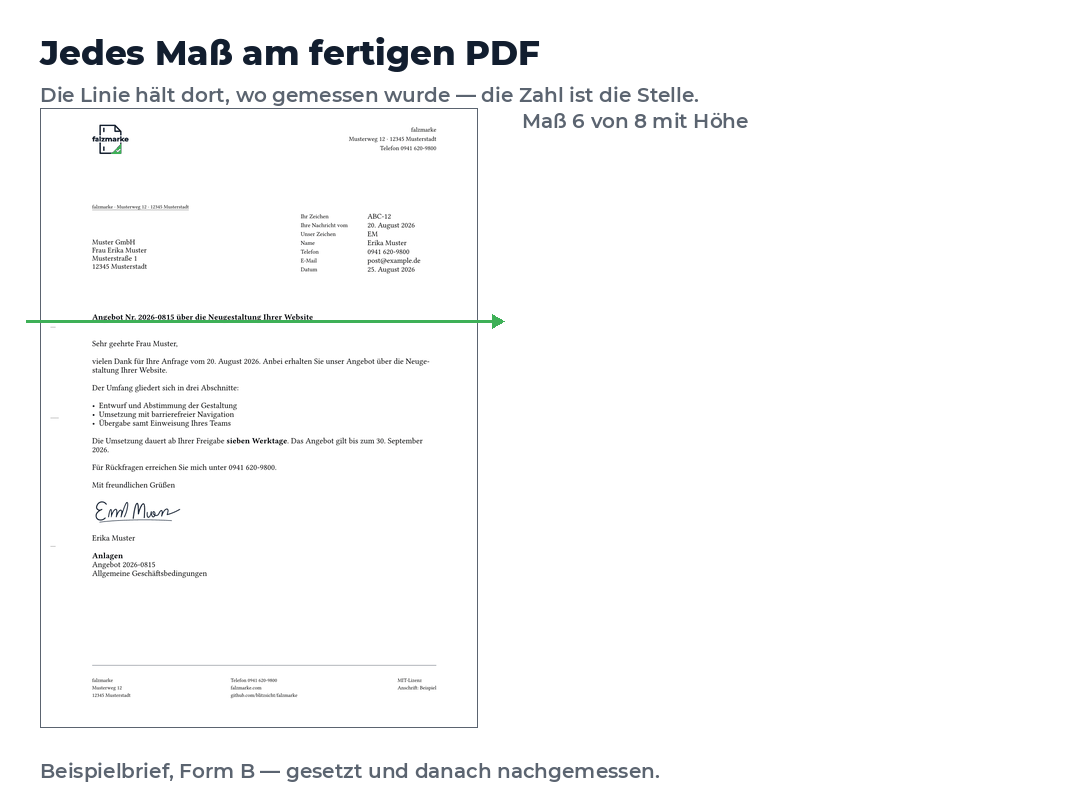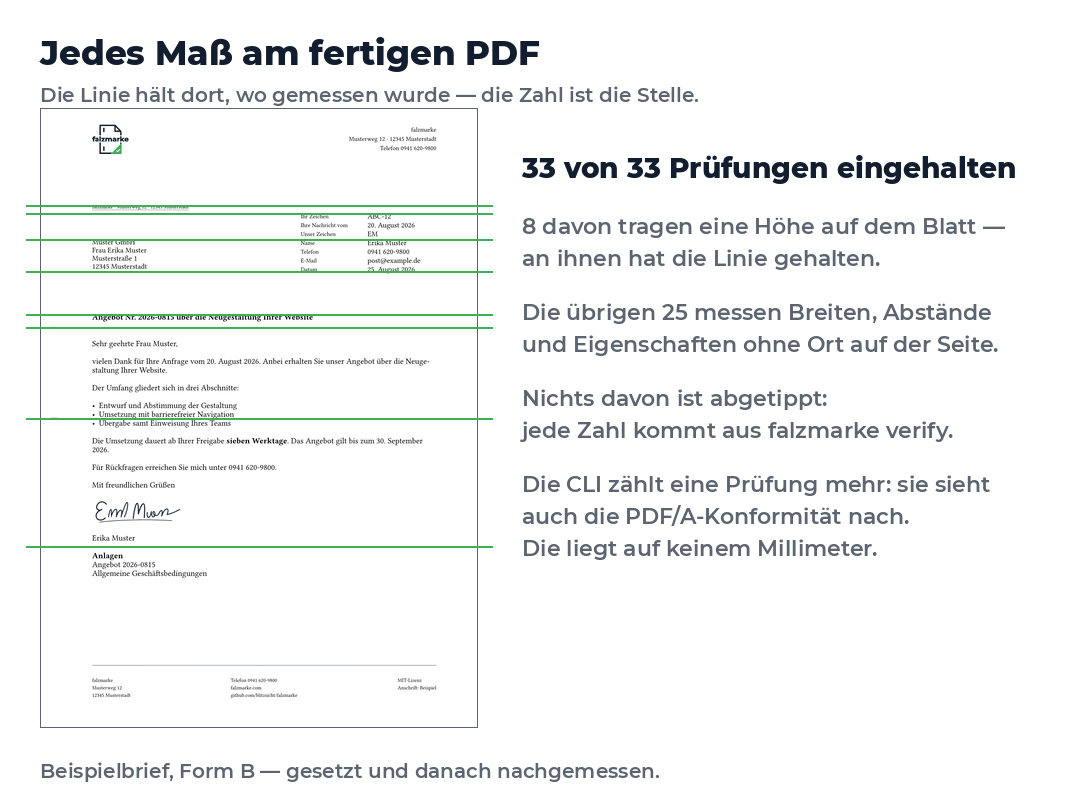
Acht der 33 Geometrieprüfungen tragen eine Höhe auf dem Blatt; die übrigen messen Breiten,
Abstände und Eigenschaften ohne Ort auf der Seite. Die Zahl 34 weiter oben zählt eine
mehr: Nach einem render sieht die CLI zusätzlich die PDF/A-Konformität nach, und die
liegt auf keinem Millimeter. Beide Zahlen stimmen, sie zählen Verschiedenes.
Keine Zahl im Film ist abgetippt — sie kommen alle aus verify --json, und
tests/test_messfilm.py hält den Film gegen einen frischen Messlauf. Verschiebt jemand
die Falzmarke um 2 mm, muss der betroffene Halt rot werden; tut er es nicht, schlägt der
Test fehl.
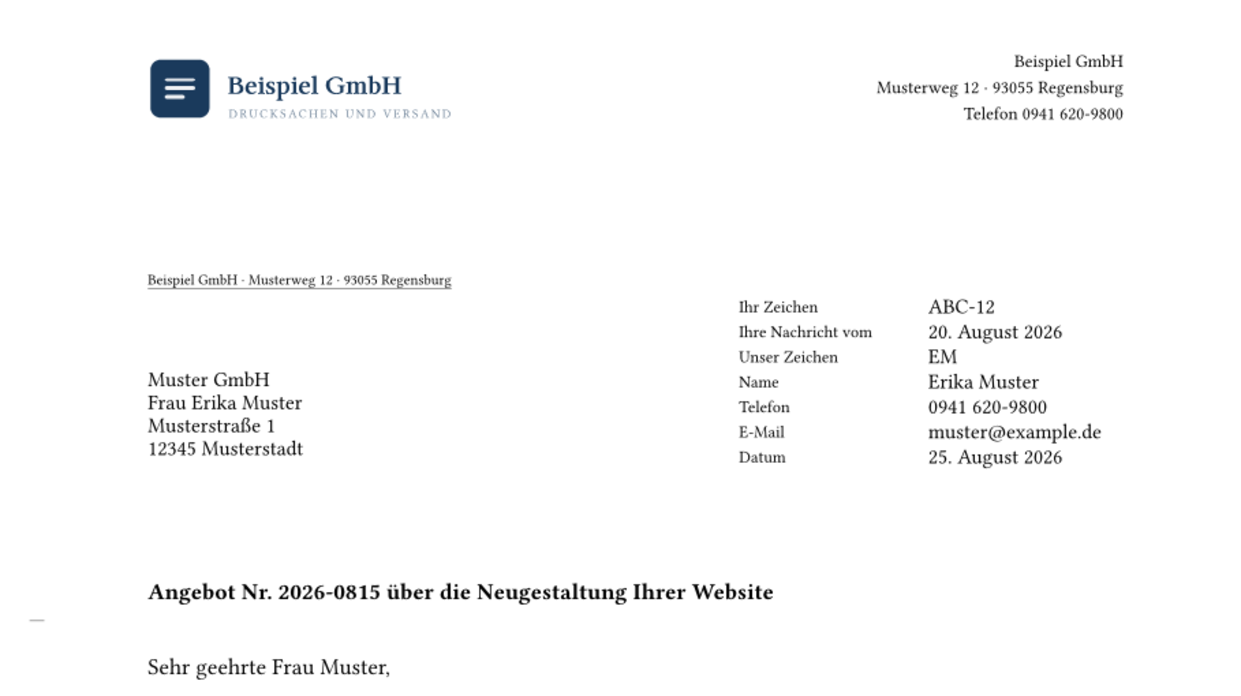
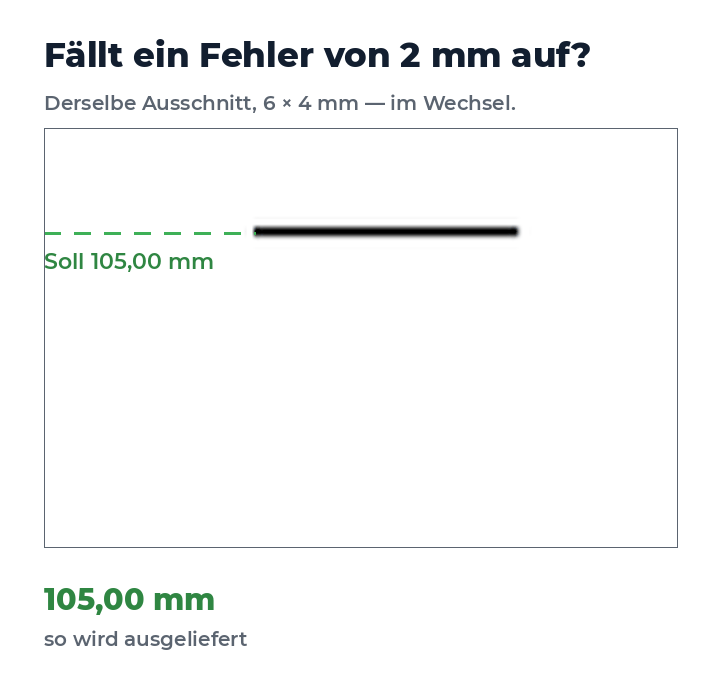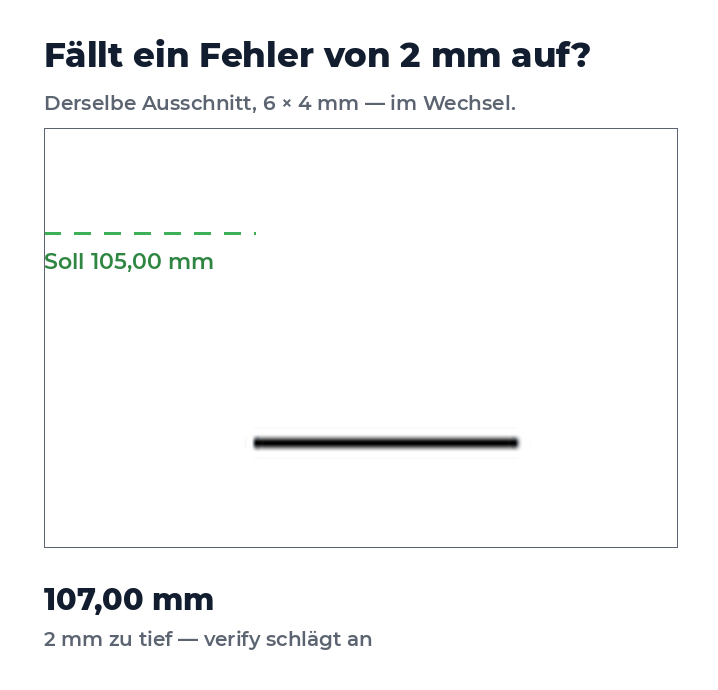
Die erste Zeile des Berichts oben spricht von einem Strich, den man auf einem Vorschaubild kaum sieht — er ist 0,25 pt stark. Vergrößert sieht die Stelle so aus:
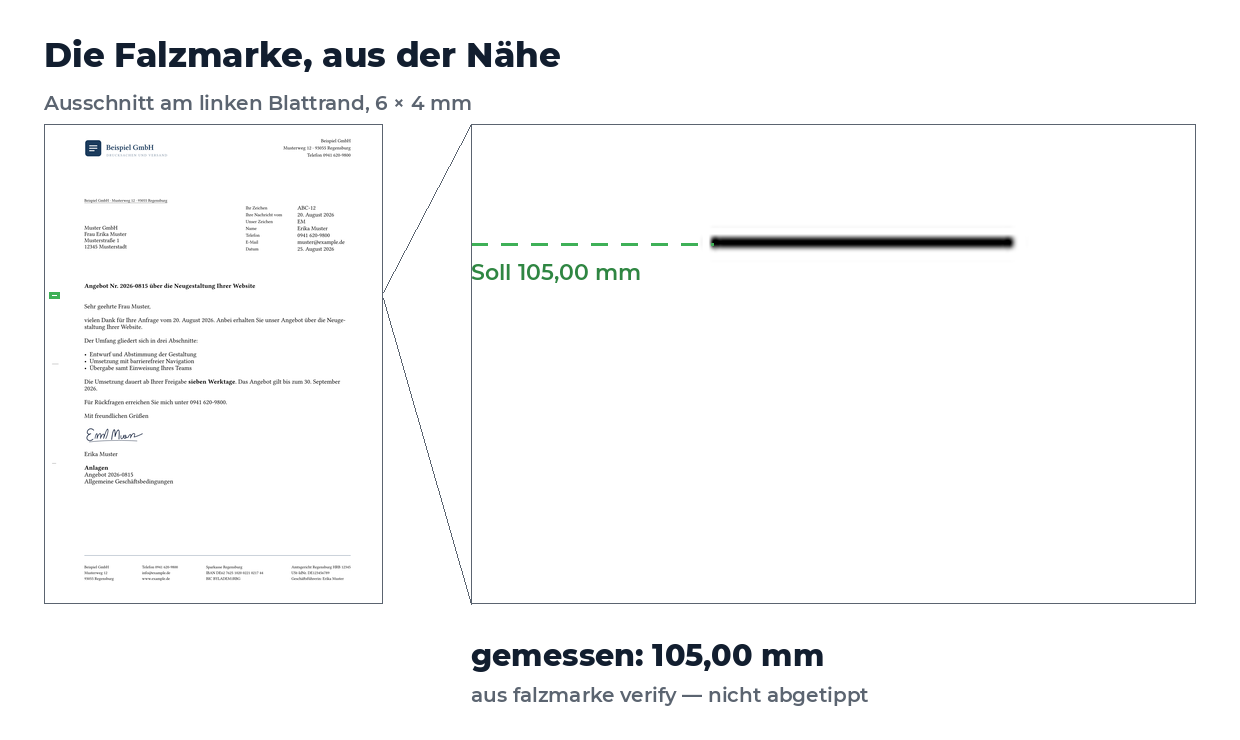
Dort wird der Bogen gefaltet, damit die Anschrift im Fensterumschlag steht. Sitzt die Marke falsch, faltet der Stapel falsch — und das fällt erst nach dem Druck auf.
Das Problem
Eine Briefvorlage kann nicht prüfen, ob das Ergebnis stimmt. Sie wird kopiert, jemand verschiebt eine Zeile, und der Fehler fällt erst am fertigen Stapel auf: Die Anschrift steht nicht mehr im Fensterausschnitt, alles muss neu gedruckt und kuvertiert werden — und wer mit Automationsrabatt einliefert, verliert ihn für diese Sendung.
Sprachmodelle verschärfen das. Sie formulieren gut, aber sie können keinen Text auf 45,0 mm setzen. Wer einen Brief von einer KI schreiben lässt, bekommt zuverlässig guten Inhalt in unzuverlässigem Layout.
Und ein Renderer kann ebenfalls Fehler haben — auch dieser hier.
Deshalb trennt falzmarke drei Dinge: Inhalt kommt als Markdown, lesbar und versionierbar. Das Layout setzt ein Renderer, der es immer gleich macht. Und die Prüfung misst das fertige PDF, statt dem Renderer zu glauben.
Warum nicht einfach Word oder ein Prompt?
Verglichen wird der typische Arbeitsablauf, nicht das Werkzeug an sich — mit einer sorgfältig gepflegten Vorlage lässt sich vieles davon erreichen.
| Vorlage in Word / LibreOffice | Brief direkt von einer KI | falzmarke | |
|---|---|---|---|
| Quelle diffbar und versionierbar | teilweise | selten | ja — Markdown und YAML |
| Layout reproduzierbar | hängt an Vorlage und Umgebung | nicht zugesichert | ja — derselbe Renderer, dieselbe Ausgabe |
| Fertiges PDF wird nachgemessen | nein | nein | ja — 34 Maße, jede Seite, Abweichung ist ein Fehler |
| Absenderprofile | von Hand gepflegt | uneinheitlich | ja — einmal anlegen, überall nutzen |
| Prüfbericht maschinenlesbar | nein | nein | ja — --json und Exit-Codes |
| PDF/A als Voreinstellung | nicht automatisch | nicht zugesichert | ja — ohne zusätzliches Flag |
Was du davon hast
- Der Brief sitzt im Fensterumschlag — Anschriftfeld, Falz- und Lochmarken werden am fertigen PDF vermessen, nicht beim Setzen angenommen.
- Änderungen bleiben nachvollziehbar — Markdown und YAML sind Textdateien. Ein Diff zeigt, was sich geändert hat; das PDF ist Ergebnis, nicht Quelle.
- Ein Auftritt, viele Briefe — Profile bündeln Briefkopf, Fußzeile, Logo, Farben und Voreinstellungen. Auch die Unterschrift, je Brief überschreibbar.
- Fehler sind maschinenlesbar — eigene Exit-Codes für Eingabe-, Geometrie- und
Umgebungsfehler, dazu
--json. Damit läuft es in CI und in Automatisierungen. - Für Langzeitarchivierung ausgelegt — im Normalfall entsteht ein PDF/A-2b ohne
zusätzliches Flag, wird eine Datei eingebettet — jede Rechnung tut das —, entsteht stattdessen
ein PDF/A-3b
(ADR 0033).
Dass die Datei die behauptete Stufe wirklich einhält, sagt nicht dieses Werkzeug, sondern
veraPDF — die Referenzimplementierung der PDF Association, in CI bei
jedem Push. Optional PDF/UA-1 mit
--pdfua, ebenfalls dort geprüft. - Im Gespräch oder im Terminal — als Claude-Skill oder als CLI, ohne Systeminstallation.
Woran man sieht, dass es stimmt
Das ist der Teil, an dem sich das Versprechen entscheidet — deshalb steht er vor der Installation.
-
Gemessen wird das fertige PDF, nicht die Eingabe.
verifyliest das erzeugte Dokument mit pdfplumber und vergleicht Zonen, Marken und Abstände gegen die Sollwerte. -
Jede tragende Prüfung hat eine Gegenprobe. Sie läuft gegen ein absichtlich verschobenes Layout und muss dort anschlagen — ein Prüfmittel, das nie rot werden kann, wäre kein Nachweis. Das gilt auch für das Bild oben: Es entsteht zweimal, einmal aus dem ausgelieferten Layout und einmal aus einem, in dem die Marke 2 mm zu tief sitzt.
Unterscheiden sich die beiden Ausschnitte nicht, zeigt der Ausschnitt die Marke gar nicht — dann ist das Bild oben wertlos, und
tests/test_detailbild.pyschlägt fehl. -
CI auf Linux, macOS und Windows, bei jedem Push.
-
Ein Frischinstallations-Test führt die Befehle aus dieser README wirklich aus. Hier steht kein Befehl, den niemand ausprobiert hat.
-
Alle Beispielbriefe werden in CI gerendert und vermessen.
-
Die PDF-Konformität bestätigt ein fremdes Werkzeug. Alles andere auf dieser Liste misst mit demselben Code, der das PDF erzeugt hat — das belegt Selbsttreue, nicht Konformität. veraPDF hat den Brief nicht geschrieben und teilt keine Zeile mit dem Renderer. Geprüft wird, was die Datei selbst deklariert, auf der ausgelieferten Datei, mit Prüfsummen-Abgleich — und mit einer Gegenprobe, die ein absichtlich nicht-konformes PDF durchfallen lässt (
scripts/pdf_konformitaet.py). -
Die Layoutbasis ist vendort und prüfsummengesichert —
vendor/README.md.
Zwei Aussagen, die gern verwechselt werden, hält das Projekt auseinander:
Der Sollwert ist fachlich belegt und der Verifier erkennt eine Abweichung davon sind verschiedene Dinge. Das Zweite ist bewiesen. Das Erste hat Grenzen.
Woher die Sollwerte stammen: Maße und Schreibregeln folgen öffentlich dokumentierten Quellen
(Liste in skill/references/din5008.md); der Abgleich mit dem
Originaltext der DIN 5008:2020-03 einschließlich Berichtigung 1:2020-07 steht aus. Regeln aus
einzelnen Quellen wirken nur als Warnung. Welche Regel worauf beruht, steht in der
Quellenlage je Regel; was daraus rechtlich
folgt, in docs/recht.md.
python3 -m pytest -q
Sicherheit
Genannt wird nur, was im Code steht und geprüft ist. falzmarke ist nicht unabhängig auditiert — Sicherheitsrelevantes bitte nach SECURITY.md, nicht als Issue.
- Verarbeitung bleibt lokal. Der Renderpfad importiert keine Netzwerkbibliothek.
- YAML wird ausschließlich mit
safe_loadgelesen — an jeder Stelle, auch beim eingebetteten Profil. - Markdown läuft gegen eine Positivliste von Knotentypen. Was nicht daraufsteht, ist ein Fehler mit Zeilenangabe — nie ein stilles Durchreichen.
- Brieftext wird nie zu Typst-Code. Der Emitter übergibt ihn als maskierte Zeichenkette; Sonderzeichen können die Struktur nicht verlassen.
- Profil- und Briefdateien bleiben in ihrem Ordner. Logo, Unterschrift und eigener Briefkopf dürfen nicht darüber hinauszeigen, Symlinks werden aufgelöst (Gegenproben).
- Typst läuft auf ein eigenes Wurzelverzeichnis begrenzt, Systemschriften sind abgeschaltet.
- Alle Abhängigkeiten des Programms sind permissiv lizenziert — THIRD_PARTY_LICENSES.md.
- Die CI-Aktionen hängen an vollständigen Commit-SHAs, nicht an verschiebbaren Tags.
Das Release-Asset lässt sich auf seine Herkunft prüfen:
gh attestation verify falzmarke.skill --repo blitzsicht/falzmarke
Das belegt, aus welchem Lauf und welchem Commit die Datei stammt — nicht, dass sie fehlerfrei
ist. Die SHA-256-Summe steht in der Release-Notiz und als falzmarke.skill.sha256 daneben.
In 60 Sekunden
Vier Wege, und sie können nicht dasselbe:
| Weg | rendert ohne Netz | Größe | wofür |
|---|---|---|---|
falzmarke.skill hochladen |
nein, der erste Lauf lädt nach | ~0,8 MB | claude.ai — der Upload-Dialog nimmt höchstens 30 MB |
falzmarke-offline.skill |
ja — der Typst-Compiler reist mit | ~34 MB | Sandboxen ohne PyPI-Zugriff; zu groß für den Upload-Dialog |
pipx / uvx |
nein, der erste Lauf lädt nach | ~1 MB | Terminal |
| Repository klonen | nein, der erste Lauf lädt nach | ~1 MB | Mitarbeit am Werkzeug |
Die beiden Skill-Pakete unterscheiden sich in genau einer Datei: Das Offline-Paket trägt das
typst-Wheel in vendor/, das schlanke nicht. Warum es zwei sind und nicht eines, steht in
skill/vendor/README.md.
Mit Claude
falzmarke.skillherunterladen- In Claude unter Einstellungen › Capabilities hochladen (Tarif mit Code-Ausführung nötig).
Für Claude Code genügt ein Symlink:
ln -s "$PWD/skill" ~/.claude/skills/falzmarke
- „Schreib einen Brief an die Muster GmbH, Angebot über …"
Im Terminal
uvx falzmarke init brief.md --profil example --betreff "Angebot Nr. 2026-0815"
oder dauerhaft installiert, danach genügt falzmarke render brief.md --png:
pipx install falzmarke
Das Paket liegt auf PyPI. Wer den unveröffentlichten
Stand von main will, nimmt weiterhin die Adresse:
pipx install git+https://github.com/blitzsicht/falzmarke
Der Typst-Compiler kommt als Python-Wheel mit: keine Systeminstallation, kein LaTeX, kein wkhtmltopdf, keine Schriftinstallation.
In einem Repository voller Briefe
Wer seine Briefe versioniert, lässt sie bei jedem Push setzen und nachmessen:
- uses: blitzsicht/falzmarke@main
  with:
    briefe: "briefe/*.md"
    profile: "profile"
Die PDFs hängen danach als Artefakt am Lauf. Hält ein Brief die Maße nicht ein, wird der Lauf
rot und nennt Datei und Maß — ein Serienbrief-Archiv merkt einen verrutschten Betreff damit
beim Push und nicht beim Empfänger. Die Eingaben stehen in
action.yml; die Aktion
installiert falzmarke von PyPI und baut keine zweite Installationsstrecke auf. Wer den Lauf
nachfahrbar halten will, nennt eine feste Fassung: paket: "falzmarke==0.7.3".
In einem anderen KI-Client
falzmarke spricht MCP — damit setzen auch Clients Briefe, die keinen Claude-Skill kennen.
pip install 'mcp>=2,<3'          # das SDK ist nicht in der Grundausstattung
falzmarke mcp                    # Server über stdio
Der Server steht im offiziellen MCP-Registry
unter io.github.blitzsicht/falzmarke. Die Zeile im Kommentar darüber ist kein Schmuck: Das
Registry prüft damit, dass dieses PyPI-Paket zu diesem Servernamen gehört — es liest die
Projektbeschreibung auf PyPI, und die ist diese Datei.
Vier Werkzeuge: brief_rendern, email_setzen, brief_pruefen, profile_auflisten.
Der Messbericht kommt bei jedem Rendern mit — ein Dienst, der ein PDF zurückgibt und
offenlässt, ob die Maße stimmen, wäre ein PDF-Generator wie jeder andere.
Im Container — so bauen ihn auch die MCP-Verzeichnisse, das
Dockerfile liegt im
Wurzelverzeichnis:
git clone https://github.com/blitzsicht/falzmarke.git && cd falzmarke
docker build -t falzmarke-mcp .
docker run --rm -i falzmarke-mcp   # `-i` ist nötig: der Server liest von stdin
Das Absenderprofil darf als Objekt im Aufruf stehen. Ein Client ohne Zugriff auf das Dateisystem des Servers kann so seinen eigenen Absender mitgeben, statt mit den Profilen zu leben, die dort zufällig liegen.
Was der Dienst nicht tut: versenden, ablegen, zustellen. Er setzt und prüft (ADR 0029).
Aus einem Clone, ohne Installation
git clone https://github.com/blitzsicht/falzmarke.git
cd falzmarke
python3 skill/scripts/bootstrap.py
python3 skill/scripts/falzmarke.py render examples/brief-form-b.md --png
Einen Brief schreiben
---
profil: example
empfaenger:
  - Muster GmbH
  - Frau Erika Muster
  - Musterstraße 1
  - 12345 Musterstadt
datum: 2026-08-25
betreff: Angebot Nr. 2026-0815 über die Neugestaltung Ihrer Website
anrede: Sehr geehrte Frau Muster,
anlagen:
  - Angebot 2026-0815
---
vielen Dank für Ihre Anfrage vom 20. August 2026. Anbei erhalten Sie unser Angebot.

Die Umsetzung dauert ab Ihrer Freigabe **sieben Werktage**.
python3 skill/scripts/falzmarke.py render brief.md --png
Alle Felder stehen im Datenvertrag. Ein Feld, das dort nicht steht, bricht mit Zeilennummer und Vorschlag ab — es wird nie stillschweigend verworfen.
Was im Brieftext erlaubt ist
Der Text unter dem Frontmatter ist falzmarke-Markdown, eine dokumentierte Teilmenge von CommonMark:
| Das geht | Das erledigt falzmarke selbst |
|---|---|
Absätze, **fett**, *kursiv* |
§ 5 mit geschütztem Leerzeichen |
| Aufzählungen und nummerierte Listen | -- wird zum Halbgeviertstrich – so |
Harter Umbruch mit \ am Zeilenende |
"Wort" wird zu „Wort“ |
| Pipe-Tabellen mit Ausrichtung |
Abkürzungen (z. B.), Datum (25. August), Einheiten (10 %, 5 kg) und Kürzel vor einer
Angabe (Tel., Nr.) setzt falzmarke nicht von selbst: Keine dieser Regeln steht auf
mehr als einer Quelle, die etwas dazu sagt — bei Abkürzungen und Datum trägt nur Wikipedia,
die zweite volle Quelle schweigt (#31). Deshalb warnt lint, statt zu ersetzen. Es meldet die
Stelle mit Zeile — dann setzt du das Leerzeichen selbst, mit (5 km). Welche
Regeln mehrfach belegt sind, steht in der
Tabelle Quellenlage je Regel.
Links, Bilder und HTML sind Fehler — mit Zeile, Grund und Korrektur, nie stillschweigend. Auf Papier gibt es keinen Link, und ein Bild im Fließtext verschöbe die Geometrie, die danach gemessen wird.
Zwischenüberschriften (# bis ####), tiefere Aufzählungen, Blockzitate und
wortgetreue Auszüge gibt es für lange Schreiben: dialekt: "1.1" im Frontmatter schaltet
sie frei. Ein Auszug bleibt Zeichen für Zeichen stehen — keine typografischen Ersetzungen,
kein Umbruch, keine Einfärbung, und nichts darin wird ausgeführt. Ohne das Feld gilt Fassung 1.0, und ein
bestehender Brief rendert unverändert.
Die vollständige Liste: falzmarke-Markdown.
Dieselbe Datei als E-Mail
Ein Schreiben mit typ: email im Frontmatter wird keine PDF-Seite, sondern eine .eml —
dieselbe Quelle, dasselbe Profil, dieselbe Signatur.
falzmarke email nachricht.md --html
OK  geschrieben: nachricht.eml
OK  geschrieben: nachricht.html
OK  verify: 22/22 Prüfungen bestanden
Die .eml öffnet das Mailprogramm, die .html der Browser. Mit --oeffnen legt falzmarke auf
macOS gleich einen Entwurf an — Empfänger, Betreff, Rumpf und Anhänge, mit Senden-Knopf, und
erst nach bestandener Prüfung. Wo dieser Weg nicht gemessen ist (Windows, Linux, Apple Mail),
wird die Datei übergeben; sie erscheint dort als Lesefenster, nicht als Entwurf, und das ist eine
Eigenschaft des Formats. Geprüft wird die fertige Datei:
MIME-Aufbau, format=flowed, Space-Stuffing, die Signaturtrennzeile, und ob im HTML nichts
steht, was dort nicht hingehört — kein Skript, kein externes Stylesheet, kein Zählpixel, keine
Tabelle als Layout. falzmarke verify --email misst auch Dateien, die von woanders kommen.
falzmarke versendet nichts. Es gibt keinen Versandbefehl und keine Option, die sendet: Wer eine Datei erzeugt, haftet für ihren Inhalt; wer sie befördert, für Zustellung und Nachweis. Das sind zwei Versprechen, und falzmarke gibt nur das erste (ADR 0034). Der Entwurf ist davon nicht berührt und geht keinen Schritt weiter: Entwurf ja, Senden nie — im Steuerskript steht kein Versandbefehl, und ein Test misst das am ganzen Paket (ADR 0038).
Wie die Datei aufgebaut ist, was bewusst fehlt und wo die Grenzen liegen:
Die E-Mail-Fassung. Vier
Beispiele liegen unter
examples/email/.
Rechnungen: ZUGFeRD und XRechnung
Ein Schreiben mit typ: rechnung wird wie ein Brief gesetzt und trägt zugleich einen Datensatz,
den keine Person liest: An Firmen geht die Rechnung als PDF mit eingebetteter ZUGFeRD-XML, an
Behörden geht dieselbe Rechnung als reine XRechnung-XML, ohne PDF.
falzmarke render rechnung.md                 # PDF/A-3b mit eingebetteter ZUGFeRD-XML
falzmarke xml xrechnung.md -o rechnung.xml   # nur die XML, für eine Behörde
Abgenommen wird das Ergebnis nicht von falzmarke selbst, sondern von zwei fremden Werkzeugen in der CI: Mustang 2.26.0 prüft PDF und eingebettete XML gegen die Schematron-Regeln der jeweiligen Fassung, der KoSIT-Validator 1.6.3 prüft eine XRechnung ein zweites Mal mit der amtlichen Konfiguration.
falzmarke rechnet nicht. Es überträgt Positionen, Steuersätze und Summen aus der Quelle, ohne sie zu bilden — es vergibt keine Rechnungsnummern, bucht nicht, mahnt nicht und versendet nichts. Was das im Einzelnen heißt und was ausdrücklich nicht behauptet wird: Rechnungen mit falzmarke.
Beispiele
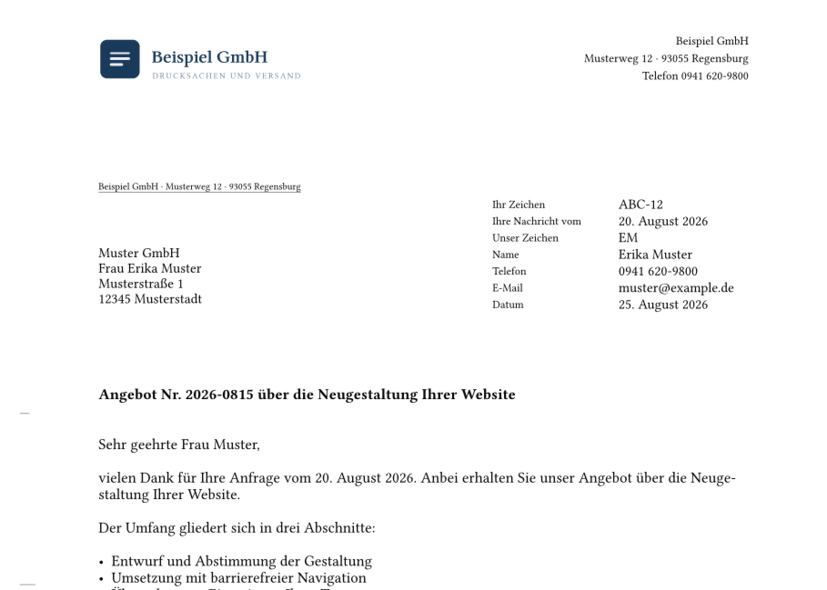
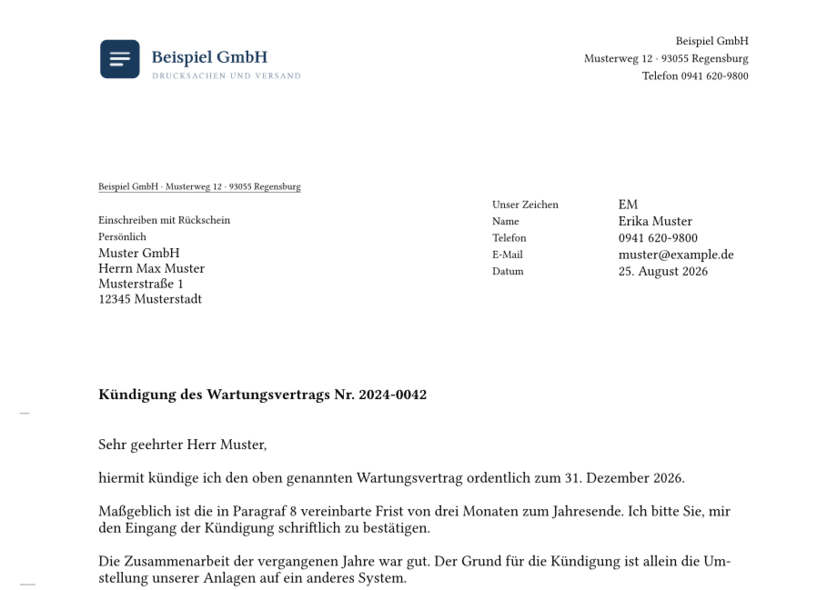
| Standardbrief | Einschreiben | Mehrseitig |
|---|---|---|
 |
 |
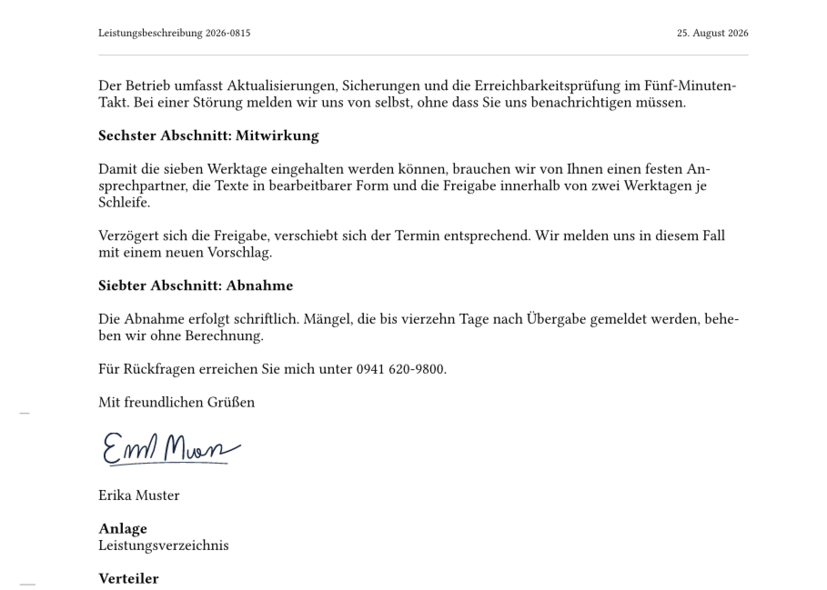 |
| Form B mit Informationsblock | Zusatz- und Vermerkzone | Kopfzeile und Seitenzählung |
Dazu Form A, Auslandsanschrift, Tabelle, ein Brief mit langem Informationsblock und einer
mit englischer Beschriftung (sprache: en — deutsche Maße, englische Wörter) —
alle Beispiele und ihre vollständigen Renderings.
Grenzen
- falzmarke-Markdown (CommonMark-Teilmenge): Absätze, fett, kursiv, Aufzählungen, nummerierte Listen, harter Umbruch, Pipe-Tabellen. Alles andere bricht mit Zeilenangabe ab, statt still etwas anderes zu setzen.
- Zonengrößen der Norm: Anschrift höchstens 6 Zeilen, Vermerke höchstens 3, Werte im Informationsblock höchstens 21 Zeichen.
- Keine Bilder im Fließtext — ein Logo gehört ins Profil.
- Nur DIN 5008. Schweiz (SN 010130) und Österreich (ÖNORM A 1080) sind vorgemerkt
(#10); das Frontmatter-Feld
norm:ist dafür reserviert. - Keine Signatur. Das Unterschriftsbild ist Erscheinungsbild, kein Nachweis. Eine kryptografische Signatur ist Gegenstand von #14.
Weiterlesen
| Befehle | alle Unterbefehle, Exit-Codes, was geprüft wird |
| Absenderprofile | Profil anlegen, Suchreihenfolge, eigener Briefkopf |
| Die E-Mail-Fassung | Aufbau der .eml, ihre Teile und Grenzen |
| Rechnungen mit falzmarke | ZUGFeRD, XRechnung, was geprüft wird und was nicht |
| Datenvertrag | jedes Frontmatter-Feld mit Beispiel |
| falzmarke-Markdown | was im Brieftext möglich ist |
| Normmaße und Quellenlage | Sollwerte und ihre Herkunft |
| Was falzmarke behauptet — und was nicht | Grenzen der Normaussage |
| Aufbau des Repositorys | Schichten, Vendoring, warum das Paket unter skill/ liegt |
| Roadmap | in welcher Reihenfolge gearbeitet wird, und was noch offen ist |
| Changelog · Releases | was sich geändert hat |
Mitmachen
Fehlerberichte und Vorschläge sind willkommen — siehe CONTRIBUTING.md.
Bei einem Geometriefehler bitte die Ausgabe von verify mitschicken; ohne sie lässt sich nicht
unterscheiden, ob das Layout oder die Messung danebenliegt.
Sicherheitsrelevantes bitte nicht als Issue, sondern nach SECURITY.md.
Herkunft und Dank
Markdown wurde 2004 von John Gruber gemeinsam
mit Aaron Swartz entworfen. Die Spezifikation dazu ist CommonMark
(John MacFarlane und Mitwirkende). falzmarke setzt eine dokumentierte Teilmenge davon um
— falzmarke-Markdown — und weicht an drei Stellen bewusst
ab: HTML wird nie durchgereicht, Links werden nie gesetzt, und eine einzelne 2. Text-Zeile
ohne weitere Listenpunkte wird gemeldet — gesetzt mit erhaltenem Startwert, damit nichts still
umnummeriert wird.
Das Seitenlayout stammt von typst-letter-pro
(MIT) von Sematre und ist unverändert vendort — Prüfsumme in
vendor/README.md. falzmarke ergänzt die Schicht
darüber: Datenvertrag, Profile, Markdown-Eingabe, Messung und den Skill.
Gesetzt wird mit Typst (Apache-2.0), geparst mit markdown-it-py (MIT), gemessen mit pdfplumber (MIT) und pypdf (BSD-3). Schriften: Libertinus und Source Sans 3 (beide OFL 1.1). Die vollständige Aufstellung samt der Begründung, warum PyMuPDF (AGPL-3.0) ersetzt wurde, steht in THIRD_PARTY_LICENSES.md.
Alle Abhängigkeiten des Programms sind permissiv lizenziert — falzmarke lässt sich damit auch in geschlossene Systeme einbauen. Nicht permissiv ist allein Remotion, womit der Erklärfilm gerendert wird: am Programm ist es nicht beteiligt und wird nicht mitgeliefert.
DIN 5008 ist eine Norm des DIN Deutsches Institut für Normung e. V. falzmarke ist kein
Produkt des DIN, steht in keiner Verbindung zum DIN und behauptet keine Zertifizierung. Wie die
Maße gemessen wurden, steht in docs/normmasse.md.
Was sich zuletzt getan hat
Die letzten zwei Versionen im Wortlaut. Erzeugt aus CHANGELOG.md — dort ändern, dann python3 scripts/changelog.py.
v0.9.9 — 25.09.2026
Neu
Entschieden: falzmarke rechnet nicht (ADR 0039). Das Werkzeug überträgt, was ihm gegeben wurde — es summiert keine Positionen, bildet keine Steuerbeträge und prüft nicht, ob Netto plus Steuer den Bruttobetrag ergibt. Wer rechnet, haftet für das Ergebnis; wer überträgt, muss sagen, dass er nicht rechnet. Dieselbe Linie wie bei „keine Zertifizierung", „kein Versand" und „falzmarke prüft die Pflichtangaben nicht".
Dazu die beiden Festlegungen, die erst nach der Erhebung aus #113 entscheidbar waren: ZUGFeRD in einer ausdrücklich benannten Fassung (gemessen am 11.09.2026 ist 2.5.2 die aktuelle) — eine Fassung, die sich zur Laufzeit ändert, ist kein Datenvertrag, denn jede schreibt Dateinamen, XMP-Schema und Beziehungsangabe im PDF vor. Und Profil EN 16931 (COMFORT) als Vorgabe, weil das genau der Umfang ist, den § 14 Absatz 1 Satz 6 UStG verlangt.
MINIMUM und BASIC WL erzeugt falzmarke nicht: Sie enthalten keine Rechnungspositionen und sind keine Rechnung im umsatzsteuerlichen Sinn. Ein Werkzeug, das „Rechnung" in den Dateinamen schreibt und eine Buchungshilfe erzeugt, behauptet zu viel.
Und die Zurückhaltung bleibt: Solange kein unabhängiges Prüfwerkzeug das Ergebnis durchlässt, sagt falzmarke nicht „ZUGFeRD-konform" — dieselbe Regel wie beim Wort „normgerecht".
Was das Umsatzsteuerrecht bei Rechnungen verlangt — erhoben, mit Fundstelle. docs/recht.md
führte bisher keine einzige Frist zur E-Rechnung. Jetzt steht dort, was § 14 UStG als
elektronische Rechnung definiert (strukturiertes Format, elektronisch verarbeitbar) und was
als sonstige — und damit die Antwort auf die Frage, die den ganzen Vorgang ausgelöst hat: Ein
PDF ohne strukturierte Daten ist keine elektronische Rechnung. Das ist, was falzmarke heute
erzeugt.
Dazu die gestaffelten Fristen aus § 27 Absatz 38 UStG (allgemein bis Ende 2026, für Aussteller mit höchstens 800 000 € Vorjahresumsatz bis Ende 2027), die zehn Pflichtangaben aus § 14 Absatz 4 und die drei Fälle, die dauerhaft als sonstige Rechnung gehen dürfen: Kleinbeträge bis 250 € (§ 33 UStDV), Fahrausweise (§ 34) und Rechnungen von Kleinunternehmern (§ 34a).
Ein Befund, der keine eigene Norm hat: Eine Empfangspflicht ist nirgends formuliert. Sie entsteht durch einen Wegfall — § 14 Absatz 1 Satz 5 verlangt die Zustimmung des Empfängers nur „soweit keine Verpflichtung nach Absatz 2 Satz 2 Nummer 1 besteht". Wo die Ausstellungspflicht greift, kann der Empfänger nicht mehr ablehnen.
Erhoben aus dem Volltext, nicht aus dem Gedächtnis: UStG und UStDV liegen seit heute im lokalen Rechtstext-Spiegel. Der Anlass für diese Sorgfalt steht in derselben Datei — § 125a HGB stand dort noch, als es ihn nicht mehr gab.
Der Datenvertrag typ: rechnung steht — gesetzt wird noch nicht. Die Felder leiten sich aus
§ 14 Absatz 4 UStG ab, den zehn Pflichtangaben einer Rechnung, erhoben in #113: Rechnungsnummer,
Leistungsdatum oder -zeitraum, Zahlungsziel, Positionen mit Bezeichnung, Menge, Steuersatz und
Betrag, dazu die Summen. Kein Feld ist erfunden. falzmarke lint prüft eine Rechnung vollständig,
meldet jedes unbekannte Feld — auch in einer Position — mit dem Vorschlag des nächstgelegenen
Namens, und lässt die Briefprüfungen weiterlaufen: Eine Rechnung ist ein Schreiben.
Statt zu rechnen, macht das Werkzeug die Probe. Es bildet keinen Positionsbetrag, keine
Summe und keinen Steuerbetrag (ADR 0039) — es rechnet die gegebenen Werte gegeneinander — Positionen gegen
Netto, Netto plus Steuer gegen Brutto —, die eine Abweichung als Warnung meldet und den Lauf
mit Code 0 beendet. Eine Rechnung mit widersprüchlichen Summen geht also durch, und
skill/references/frontmatter.md sagt das ausdrücklich.
Der Renderer bricht bei einer Rechnung ab. Das war ein Befund und keine Vorsorge: Ohne den
Abbruch fiel typ: rechnung in den Briefzweig und entstand als PDF — ohne Positionen und Summen,
die der Brief nicht kennt, und ohne ein Wort darüber. Genau die Fehlerart, gegen die das Werkzeug
antritt.
Beim Bauen gemessen und behoben: Ein Tippfehler in einer Position stand auf Zeile 1, weil die
Zeilensuche nur die oberste Ebene fand; eine leere Rechnungsnummer gab zwei Befunde für einen
Fehler. Vier Gegenproben machen je genau ihren Test rot — der Renderer-Abbruch, die Doppelmeldung,
der Zweig für Wahrheitswerte und die Zeilenangabe. Der Test für Wahrheitswerte stand im ersten
Entwurf an der falschen Stelle: PyYAML liest ja als Text, erst true trifft den Zweig.
Die Rechnung trägt ihre Daten maschinenlesbar mit. Aus typ: rechnung entsteht neben dem
gesetzten PDF eine XML nach EN 16931, eingebettet in dasselbe Dokument — ein Schreiben für
Menschen und ein Datensatz für Maschinen, aus einer Quelle. Das PDF wird dadurch PDF/A-3b
statt PDF/A-2b; die Datei heißt factur-x.xml und trägt die Beziehung Alternative.
Die Positionstabelle setzt falzmarke selbst aus positionen: und summen:. Sie gehört
nicht mehr in den Rumpf: Stünden dieselben Zahlen zweimal in der Quelle, liefen sie
auseinander — und ein PDF mit 1.190,00 € neben einer XML mit 1.109,00 € sieht zweimal richtig
aus, bis die Buchhaltung des Empfängers die XML einliest.
Neu im Datenvertrag, beides von der XML verlangt und nicht erfunden:
empfaenger_anschrift:mitname,strasse,plz,ort,land.empfaenger:sind ein bis sechs freie Zeilen; ob die zweite die Straße ist oder eine zweite Namenszeile, lässt sich nicht ablesen. Geraten hieße, den Empfänger falsch zu adressieren, ohne dass es auffällt.summen.steuer[].basis— die Bemessungsgrundlage je Steuersatz. Sie aus den Positionen zu summieren wäre Rechnen, und falzmarke rechnet nicht (ADR 0039).
Im Absenderprofil kommt der Abschnitt rechnung: mit ust_idnr: oder steuernummer: und
land: dazu. Name und Anschrift kommen weiter aus absender:. Fehlt eine Angabe, meldet
lint das — aber erst, wenn ein Schreiben typ: rechnung trägt.
Geprüft wird, dass die Angaben da sind, nicht ob sie gelten: Eine USt-IdNr. gegen das Bundeszentralamt abzugleichen hieße Netz (ADR 0005). Ob das Ergebnis als ZUGFeRD-Rechnung durchgeht, sagt nicht falzmarke, sondern der fremde Prüfer in der CI (#118).
Beträge werden übertragen, nicht gebildet — auch der Steuergesamtbetrag. Bei mehreren
Steuersätzen gehört steuer_gesamt: unter summen:; falzmarke summiert die Einzelbeträge
nicht. Ein Betrag mit mehr als zwei Nachkommastellen und ein Summenfeld, das keine Zahl ist,
werden gemeldet statt gerundet oder übergangen — auch beim Setzen über den MCP-Dienst, der
ohne lint arbeitet. Eine Rechnung ohne Umsatzsteuer (etwa nach
§ 19 UStG) erzeugt falzmarke noch
nicht: Die XML zeichnet jede Steuer als Regelsatz aus.
XRechnung für öffentliche Auftraggeber. Mit erechnung: xrechnung und einer leitweg_id: im
Kopf entsteht XRechnung 3.0 in CII. Der neue Befehl falzmarke xml schreibt sie als reine
XML-Datei, ohne PDF — den Weg an Behörden; render setzt sie auch als PDF und sagt dabei, dass
eine Behörde die XML erwartet. lint prüft die Leitweg-ID nach der Format-Spezifikation 2.0.2
(Form und Prüfziffer) und nennt auf einmal alles, was XRechnung zusätzlich verlangt:
Käuferreferenz, Ansprechpartner, Konto und die elektronischen Adressen beider Seiten. Die CI hält
die eigene XRechnung gegen Mustang (XR_30), dazu eine Gegenprobe ohne Käuferreferenz, die an genau
BR-DE-15 scheitern muss. Welche Fassung ein Empfänger annimmt, entscheidet der Empfänger.
Die E-Rechnung trägt Ansprechpartner, Konto und elektronische Adresse. Die eingebettete XML
schreibt jetzt den Kontakt des Ausstellers aus dem Informationsblock (dieselbe Person wie im PDF),
einen Zahlungsweg per Überweisung aus dem neuen Profilfeld rechnung.bank und die elektronische
Adresse aus rechnung.adresse. lint prüft Form und Prüfziffer der IBAN und warnt, wenn sie
nicht auch in der Fußzeile steht. Unter EN 16931 ist alles freiwillig; XRechnung (#117) verlangt
alle drei Angaben. Außerdem liest die Zeile „E-Rechnung“ im Messbericht Beilage, Guideline-ID,
Profil und Factur-X-Fassung jetzt aus der fertigen Datei — vorher stammten sie aus Konstanten,
und die Zeile konnte nie rot werden.
Beispiele und Goldens für Rechnungen. Zwei neue Beispiele laufen in der CI mit: eine Rechnung
mit 19 % und 7 % und eine Kleinbetragsrechnung. Jedes Rechnungsbeispiel wird Byte für Byte gegen
ein festgehaltenes PDF und gegen seine eingebettete XML gehalten; scripts/golden_rechnung.py
erneuert beide. Wie bei der .eml setzt SOURCE_DATE_EPOCH die Erstellungszeit im PDF fest,
ohne die Variable bleibt es bei der Rechnerzeit. lint meldet zwei stille Abweichungen zwischen
PDF und XML als Fehler: einen Steuersatz einer Position ohne eigene Zeile in summen.steuer —
das PDF zeigt nur die Summenzeilen — und einen Ländercode, der kein amtlicher
ISO-3166-1-Alpha-2-Code ist, etwa land: Deutschland.
Behoben dabei: Unter Windows bettete render die Rechnungs-XML mit \r\n statt \n ein, dieselbe
Quelle ergab also je nach Rechner eine andere Datei. falzmarke xml war davon nicht betroffen.
Eine Seite zu Rechnungen. docs/rechnung.md sagt, was falzmarke bei typ: rechnung erzeugt:
ZUGFeRD als PDF/A-3b mit eingebetteter XML für Firmen, XRechnung 3.0 als reine XML für Behörden,
beide im Profil EN 16931. Die Seite nennt auch, wer das Ergebnis mit welcher Regelfassung prüft
und was falzmarke nicht tut: rechnen, Nummern vergeben, buchen, mahnen, versenden. README und
Skill unterscheiden die zwei Formate jetzt in einem Satz, und die PDF/A-Aussage im README ist
eine Fallunterscheidung: A-2b im Normalfall, A-3b, sobald eingebettet wird.
Die Signatur liegt als Daten neben den Goldens. tests/golden/email/signatur-faelle.json
trägt je Fall das vollständige Absenderprofil, den Kopf des Schreibens und die Blöcke, die
eml.signatur_bloecke() daraus macht. Der Anlass: falzmarke.com hat dieselbe Regel als
JavaScript-Port im Browser (Name und Anschrift sind personenbezogen und sollen das Gerät nicht
verlassen) und hält sie gegen die .eml-Goldens. Die laufen aber alle auf einem Profil, und
damit war genau ein Weg durch die Funktion belegt; für die übrigen hatte das Website-Repo eigene
Erwartungen aufgeschrieben, die nur zeigen, dass der Port sich nicht selbst widerspricht. Acht
Fälle deckeln das jetzt ab, darunter alle drei Quellen für den Namen und die Entdoppelung über
zwei Blöcke, die am mitgelieferten Profil leerläuft. Jeder Fall muss sich von jedem anderen
unterscheiden — beim Bauen fiel dadurch auf, dass zwei Fälle für zwei verschiedene
Rückgriffstufen identische Blöcke ergaben, also einen Port durchgelassen hätten, der nur eine
davon kennt. Das JSON entsteht im selben Lauf wie die Goldens; vier Gegenproben verfälschen je
eine Quellzeile in signatur_bloecke() und verlangen namentlich die Fälle, die rot werden.
Nebenwirkung: Das Website-Repo kann seine Abschrift von typst/profiles/example.yaml fallen
lassen — es hat keinen YAML-Parser, das Profil steht jetzt als JSON da.
Ein englisches README. Alle Verzeichnisse und Listen, in die das Werkzeug sachlich gehört,
sind englischsprachig — wer über eines davon kam, landete auf einer Seite, die er nicht liest
(#237). README.en.md ist bewusst eine Kurzfassung und keine Spiegelung der deutschen: Die
lange Fassung hängt an sechs Prüfungen, die eine Zweitfassung nicht hätte, und wäre ab dem
nächsten Merge still veraltet. Der Vorbehalt zur Quellenlage steht auch dort — eigens
geschrieben, nicht übersetzt —, und die gesperrten Konformitätswörter haben jetzt englische
Gegenstücke. Ohne sie hätte die Sperre aus ADR 0032 ausgerechnet dort nicht gegriffen, wo das
Werkzeug neu vor Publikum steht.
Ein Mail-Beispiel mit Listen — examples/email/email-liste.md. Bis dahin enthielt kein
Beispiel eine Liste, und damit belegte kein Golden, wie <ul>, <ol>, die eingerückte
Unterliste und start bei einer Nummerierung ab n aussehen. Aufgefallen ist das in #289, wo
die Breitenprüfung erst nachträglich von Absätzen auf Listen ausgeweitet werden musste — gefunden
hat es dort kein Golden, sondern ein eigens gebauter Test.
Zwei Prüfungen sichern nicht das Verhalten (das tut das Golden byteweise), sondern die
Abdeckung: dass das Beispiel alle vier Formen trägt und dass mindestens ein Listenpunkt
länger als die Faltbreite ist. Der zweite Punkt ist gemessen und nicht vorsorglich: Im ersten
Entwurf waren alle Punkte kürzer als 72 Zeichen, format=flowed hatte also nichts zu falten, und
eine Sabotage der Festzeilen-Logik in emit_text.teile() ließ jedes Golden unberührt. Das
Beispiel deckte die halbe Zusage nicht ab, und zwar unsichtbar.
Rechnungen von Kleinunternehmern (§ 19 UStG). Steht im Profil rechnung.kleinunternehmer: true und ein eigener kleinunternehmer_hinweis:, entsteht eine Rechnung ohne Umsatzsteuer:
- PDF: nur der Gesamtbetrag und darunter der Hinweis.
- XML: Kategorie E mit Satz 0 und Steuer 0, dazu derselbe Hinweis als BT-120 und BT-33.
- Kein Vorgabetext: falzmarke gibt keinen Wortlaut vor und bewertet ihn nicht.
lint-Fehler: ein fehlender Hinweis, ein Steuersatz oder eine Steuerzeile trotz Status, undbruttoungleichnetto.- Neue Beispiele: eine Rechnung als ZUGFeRD und eine als XRechnung. Mustang prüft beide, der KoSIT-Validator die XRechnung, jeweils mit Gegenproben an BR-E-10 und BR-E-05.
Die Umsatzgrenzen prüft falzmarke nicht (ADR 0041).
Geändert
Tabellen stehen nicht auf dem Zeilenraster, und das ist beschlossen. Die Lesbarkeit gewinnt: Der Innenabstand der Zellen bleibt bei 1,4 mm, die Rasterprüfung nimmt Tabellen weiter aus. Der rastertreue Wert (2,293 mm) ließe eine fünfzeilige Tabelle um 9 mm wachsen und änderte jedes Bild mit Tabelle, und die Übergänge blieben auch dann gebrochen. Messwerte und Begründung stehen an einer Stelle, im Docstring von _tabellenbereiche; die Referenz sagt nur noch, dass es so ist. Ein Test misst die Zeilenhöhe im gerenderten PDF gegen einen festen Sollwert, damit die Ausnahme nicht still wächst, mit Gegenprobe an drei verstellten Innenabständen.
Die Form-A-Maße stehen jetzt auf zwei unabhängigen Quellen — mehr als die Form-B-Maße. geometrie.form_a.masse trägt mehrfach_bestaetigt statt einzeln_belegt, getragen von der Form-A-Zeichnung im Onlineprinters-Magazin und dem Federwerk-Artikel: zwei voll zählende Quellen aus zwei Gruppen. Die fünf Form-B-Regeln stehen dagegen auf zwei Ansichten derselben Zeichnung, also auf einer Gruppe. An der Prüfung ändert sich nichts — die Maße am fertigen PDF wirkten seit jeher als Fehler, weil die Nachmessung den Regelkatalog gar nicht kennt; nachgemessen an einem Form-A-Brief, dessen Bericht mit alter und neuer Stufe byte-gleich ist. Was sich ändert, ist die Auskunft des Werkzeugs über die eigene Beleglage, und die war falsch. Die Entscheidung steht in ADR 0046; docs/recht.md sagt jetzt dazu, dass die Herkunftstabelle für die Briefmaße nicht gilt.
Das Regelwerk sagt jetzt auch für GmbH, AG und eG, welche Angaben die Vorschrift aufzählt. Bei email.pflichtangaben nannten hgb_37a und hgb_125 den Inhalt der Pflicht, gmbhg_35a, aktg_80 und geng_25a dagegen nur die Wendung „gleichviel welcher Form" — also den Grund, aus dem die Pflicht auch für E-Mails gilt. Für die häufigste Rechtsform überhaupt stand damit nirgends, was zu nennen ist. Die drei Belege führen die Aufzählung jetzt mit: Rechtsform, Sitz, Registergericht, Registernummer, die vertretungsberechtigten Personen mit ausgeschriebenem Vornamen, dazu die Unterschiede zwischen den drei Vorschriften (Grundkapital statt Stammkapital, der Vorstandsvorsitzende als solcher zu bezeichnen, keine Kapitalangaben im GenG). Am Werkzeug ändert das nichts — Stufe, Ebene und Wirkung der Regel sind unverändert, und der Inhalt von pflichtangaben wird weiterhin nicht geprüft (ADR 0005). Sichtbar wird es dort, wo die Daten gelesen werden: im Signatur-Baukasten auf falzmarke.com.
Eine Mail geht ins Mailprogramm, nicht in den Browser. SKILL.md hat den Umweg bis dahin
selbst empfohlen: „Diese Vorschau ist das, was gezeigt wird — nicht die .eml" machte die
HTML-Vorschau zum Regelfall, und „--oeffnen gehört im Gespräch dazu, sobald ein Mensch die
Nachricht wirklich abschicken will" überließ den Rest der Auslegung. Die Folge war, dass jede
Sitzung es anders machte und die fertige .eml unbenutzt neben der Vorschau lag. Jetzt ist
--oeffnen der Regelfall und legt den Entwurf im Mailprogramm an; die .html entsteht nur auf
ausdrückliche Nachfrage und wird nicht mehr von selbst gezeigt. Ohne das Flag laufen nur Serien,
Prüfläufe und Automatikläufe. Drei Prüfungen halten das fest, samt Gegenprobe gegen die
Rückkehr des alten Wortlauts.
Der Entwurf sagt, dass er den Faden nicht trägt. antwort_auf: setzt In-Reply-To und
References in die .eml; der Weg über das Mailprogramm nimmt beide nicht an — gemessen am
11.09.2026 für Outlook für Mac, drei Versuche, alle abgelehnt. Bis dahin fiel das still unter
den Tisch, und die Antwort begann einen neuen Thread, ohne dass jemand einen Grund sah. Der
Befehl meldet es jetzt, wenn ein Bezug gesetzt ist, und nennt die .eml als den Weg, der den
Faden hält. Nur dann — stünde die Warnung unter jeder Mail, läse sie niemand.
Der Fließtext einer E-Mail nimmt die Breite des Lesefensters. Bis dahin trugen Absätze und
Listen max-width: 640px. Die Überlegung dahinter stimmt — 640 px bei 16 px sind rund 75 Zeichen,
und lange Zeilen lesen sich schlechter —, nur hatte die Zahl keine Quelle: nicht in der DIN 5008,
nicht im Regelkatalog, kein Eintrag in quellen.yaml. Eine Setzung auf Ebene Praxis nach
ADR 0035, und Praxis ist nie ein Fehler — wirkte hier aber als einer, weil Bericht keine
Warnstufe kennt und verify --email mit Code 2 endete. Der Deckel fällt deshalb weg, und die
Prüfung steht in der Gegenrichtung: „Fließtext ohne Breitendeckel" schlägt an, wenn er
zurückkommt. Sie misst nur die eigenen Absätze — eine mitgebrachte Signatur behält ihre Breite,
sonst wäre es der Fehler aus #279 noch einmal. Die Gegenprobe setzt den Deckel wieder ein und ist
einzeln gegen eine wirkungslose Prüfung gefahren. Der Klartextteil bleibt, wie er war: Dort
faltet format=flowed nach RFC 3676 weich, und der Empfänger bricht neu um.
Eine Prüfung der fertigen E-Mail kann jetzt warnen statt zu scheitern. Bis hierher wirkten
alle 24 Prüfungen in pruefung_eml.py als Fehler — nicht aus Absicht, sondern weil keine einen
Regelnamen trug und regeln.deckel(None) vorsichtshalber fehler zurückgibt. Damit lief ADR 0035
an der halben Kette vorbei: Im Linter wird eine Regel auf der Ebene Praxis längst herabgestuft,
an der fertigen Datei gab es nur „Fehler" oder „gar nicht prüfen". Genau daran ist die Lesebreite
in #289 gestorben — eine Setzung ohne Quelle, die als harter Befund wirkte, und der einzige Ausweg
war, sie zu entfernen.
regeln/email.yaml trägt jetzt die Achse pruefung: neben lint: und typografie:, und alle 24
Prüfungen sind zugeordnet: zehn auf RFC-Primärquellen (3676 für format=flowed, delsp,
Space-Stuffing und die Signaturzeile; 2045 für Zeichensatz und Kodierung; 5322 für Date und die
Message-ID; 2046 für die Reihenfolge der Alternativen — jede mit nachgelesener Fundstelle), die
übrigen als Zusagen des Werkzeugs nach ADR 0034. geometrie.Pruefung trägt eine stufe mit der
Vorgabe fehler, Bericht.ok zählt nur Fehler, und eine Warnung erscheint auch im knappen
Bericht samt Schlusssatz — sonst wäre sie im grünen Lauf keine.
Für keine einzige Prüfung ändert sich die Wirkung. Das ist beabsichtigt: Der Gewinn ist nicht
eine mildere Prüfung, sondern eine begründete. Die Briefmaße bleiben ebenfalls unberührt, dort
warnt kein Maß. Drei Gegenproben halten das fest — dieselbe Regel einmal als Fehler und einmal als
Warnung über dieselbe Datei, und ein verschobenes Falzmaß, das weiterhin ein Fehler ist.
tests/test_quellenlage.py liest die Regelnamen aus dem Syntaxbaum von pruefung_eml.py: Eine
neue Prüfung ohne Katalogeintrag besteht nicht, und ein Katalogeintrag ohne Prüfung im Code auch
nicht.
Leitwort und Schlusspunkt im Betreff haben eigene Regeln. Bisher meldeten sie unter dem Namen betreff und hingen damit am Katalogeintrag der Betrefflänge, in Brief und E-Mail. Eine Herabstufung der Länge hätte beide stillschweigend mitgezogen. Jetzt gibt es vier eigene Einträge (betreff.leitwort, betreff.schlusspunkt, email.betreff_leitwort, email.betreff_schlusspunkt), alle mit herkunft: werkzeug und ohne Quelle, denn für beide Regeln hat niemand eine gefunden. Im Brief bleibt die Wirkung ein Fehler. In der E-Mail sind Leitwort und Schlusspunkt jetzt eine Warnung (Ebene praxis, das Leitwort steht im Vorschaufenster neben dem „Betreff“ des Clients) statt eines Fehlers. Die Ausgabe des Linters nennt die neuen Regelnamen; ein Skript, das sie nach betreff durchsucht, findet nur noch die Länge. Ein Test stuft die Länge herab und prüft, dass Leitwort und Schlusspunkt unverändert melden.
Eine Quelle, die zur Regel schweigt, zählt nicht mehr für ihre Stufe: Sieben Regeln gelten jetzt als Werkzeugprüfung, drei warnen statt Fehler zu werfen — und wo der Typografie-Pass deshalb nichts mehr setzt, sagt der Linter es an der Stelle.
Wo eine Regel seit der Quellenprüfung keine Quelle mehr hat, beruft sich ihre Meldung nicht länger auf die Norm: Anrede, Grußformel und Anschriftfeld sagen jetzt, dass das Werkzeug es so hält.
Das geschützte Leerzeichen hinter Kürzeln wie Nr. oder Tel. hat eine eigene Regel (schreibweise.kuerzel_vor_angabe); schreibweise.zahlengliederung bleibt den Dreiergruppen vorbehalten.
text.anschrift_ohne_leerzeilen ist keine Werkzeugprüfung mehr, sondern einzeln belegt: Der
Wikipedia-Artikel nennt beide Hälften der Regel — bis zu 6 Zeilen in der Anschriftzone, keine
Leerzeilen darin —, war aber nie als Quelle eingetragen. Die Meldung beruft sich deshalb wieder
auf die Quelle statt auf das Werkzeug. Die Wirkung bleibt eine Warnung; eine Quelle allein lässt
keinen Lauf scheitern (ADR 0044).
Die Regeldatei sagt jetzt, warum der Wikipedia-Artikel für das Anschriftfeld 32 mm (Form A) und 50 mm (Form B) nennt, während unsere Werte 27 und 45 mm lauten: Es sind zwei verschiedene Kanten — der Artikel meint die Oberkante der Zusatz- und Vermerkzone, wir die des Briefkopfs, und dazwischen liegen die 5 mm der Rücksendeangabe. Kein Widerspruch und keine geänderte Prüfung.
Die Maße, die falzmarke am fertigen PDF nachmisst, tragen jetzt die Stufe, mit der sie wirken. Drei Geometrie-Regeln standen auf „einzeln belegt" und hätten nur warnen dürfen, ließen einen Lauf aber scheitern — die Nachmessung kennt den Regelkatalog nicht. Aufgelöst über die Beleglage: Die Mindesthöhe des Informationsblocks (40 mm) und die Heftrandgrenze der Marken (20 mm) sind aus zwei neuen, unabhängigen Quellen belegt, die Schriftgrößen aus zwei weiteren. Die Länge der Marken ist dagegen keine Aussage der Norm — zwei Quellen sagen das ausdrücklich —, sondern eine Setzung des Werkzeugs; sie ist als solche ausgewiesen und aus der Regel herausgelöst. Am Verhalten ändert sich nichts: Derselbe Brief ergibt denselben Bericht (ADR 0047).
Behoben
Ein doppelt vergebener Schlüssel in einer Regeldatei bricht den Lauf ab, statt den ersten Inhalt stillschweigend zu verwerfen. geometrie.form_a.masse trug einen Tag lang zwei bemerkung:; YAML nimmt in diesem Fall den letzten, und die Erklärung der 32 mm war im geladenen Regelwerk nicht mehr vorhanden — ohne Meldung, denn die Datei lädt ja. regeln._yaml_laden() weist das jetzt mit Datei, Schlüssel und beiden Zeilennummern ab, in den Regeldateien wie im Quellen-Register. Drei Tests halten es fest, darunter die Gegenprobe, dass derselbe Inhalt ohne Duplikat weiter lädt.
veraPDF wird mit fester Version und geprüftem SHA-256 geladen; ein abweichender Digest bricht den Lauf ab, bevor das Archiv entpackt wird.
Eine Mail geht in ein Fenster auf, nicht in zwei. --oeffnen konnte zwei Fenster
hinterlassen: Das Steuerskript öffnete den Entwurf, bevor falzmarke seine Zählung gegen die
Vorgabe halten konnte — fiel sie durch, stand das Fenster schon offen, und der Rückfall legte
die .eml obendrauf. Das zweite Fenster ist ein Lesefenster ohne Senden-Knopf; derselbe Fehler
erklärte also beide Hälften der Meldung vom 11.09.2026. Jetzt legt das Skript die Nachricht nur
an und gibt ihre Kennung zurück; geöffnet wird erst nach bestandener Prüfung, und was durchfällt,
wird verworfen, bevor es jemand sieht. Kehrt das Skript gar nicht zurück, gilt der Zustand als
ungewiss — dann wird weder geöffnet noch verworfen noch nachgeschoben, sondern gesagt, dass
im Mailprogramm nachzusehen ist. Der Rückfall sagt außerdem dazu, dass die Datei als Lesefenster
erscheint und nicht als Entwurf.
Der Outlook-Entwurf kommt vom Konto des Profils. --oeffnen legte den Entwurf ohne Konto an,
und Outlook nahm sein Standardkonto — wer mehrere Postfächer hat, musste „Von" bei jeder Mail von
Hand umstellen und verschickte vom falschen, wenn er es vergaß. Jetzt sucht das Steuerskript das
Konto mit der Adresse aus email.absender und legt den Entwurf darauf an; welches Konto er
tatsächlich trägt, wird am fertigen Objekt zurückgelesen. Passt es nicht oder bietet Outlook keins
an, entsteht der Entwurf trotzdem, und die letzte Zeile der Ausgabe lautet ABSENDER PRÜFEN: ….
Belegt ist der Weg für das klassische Outlook für Mac; im neuen Outlook sieht die
Programmsteuerung keine Konten, dort bleibt es bei der Warnzeile.
Zwei Fehler im selben Weg sind mit behoben, beide am 13.09.2026 am echten Outlook aufgetreten: Die
Suche nach dem Mailprogramm hing über das laufende Outlook und endete nach 20 Sekunden mit einem
Traceback und Exit 1 — sie fragt jetzt NSWorkspace und meldet eine gerissene Frist als Satz. Und
das Öffnen des Entwurfs suchte ihn mit whose unter allen ausgehenden Nachrichten, was im
klassischen Outlook nicht in 90 Sekunden zurückkam; es greift jetzt direkt über die Kennung zu.
Der Mail-Rumpf erscheint im klassischen Outlook nicht mehr kursiv. Die Schriftfolge nannte
„Segoe UI“; die Schrift ist auf dem Mac nicht installiert, und der Editor des klassischen Outlook
für Mac ersetzte sie durch einen kursiven Schnitt — sichtbar in jedem Entwurf aus --oeffnen.
Gemessen am 13.09.2026 mit vier Schriftfolgen in einem Entwurf: beide mit Segoe kursiv, beide ohne
normal. Die Folge lautet jetzt -apple-system, Roboto, Helvetica, Arial, sans-serif; unter Windows
steht damit Arial statt Segoe UI.
Ohne Outlook-Konto zur Profiladresse sagt die Warnzeile, was wirklich los ist. Nannte das Profil
eine Adresse, für die Outlook kein Konto hat, lag der Entwurf auf dem Standardkonto, die Signatur im
Rumpf nannte trotzdem die Profiladresse, und die letzte Zeile riet „unter Von umstellen" — dort stand
die Adresse gar nicht zur Wahl. Das Steuerskript meldet jetzt in einer dritten Nachweiszeile, ob die
Suche das Konto gefunden hat (gefunden), ob Outlook Konten zeigte, aber keins mit dieser Adresse
(fehlt), oder ob es gar keine zeigte (-, nicht geprüft). Bei fehlt nennt die Warnzeile die
abweichende Signatur und rät zu einem anderen Profil oder einem eingerichteten Konto; ohne lesbare
Konten steht „nicht geprüft" da statt einer Behauptung.
Rechnung aus einem Profil ohne USt-IdNr. Trug das Profil nur rechnung.steuernummer:, fiel die eingebettete XML bei einem Prüfprogramm an der Regel BR-CO-26 durch: EN 16931 verlangt eine Verkäuferkennung, eine Registerkennung oder die USt-IdNr., und die Steuernummer zählt dafür nicht. falzmarke schreibt die Steuernummer in diesem Fall zusätzlich als Verkäuferkennung, wie es das Beispiel des FeRD vormacht. Mit USt-IdNr. bleibt die Datei, wie sie war. Mustang und der KoSIT-Validator prüfen den Fall jetzt in der CI, mit einer Gegenprobe, die an BR-CO-26 scheitern muss.
verify --email sieht einen Knopf, der in Outlook zerfällt, und der Abstand unter einer Liste
ist kleiner. Am 14.09.2026 meldete die Prüfung 27/27 und 29/29, während in Outlook für Mac der
Termin-Knopf der mitgebrachten Signatur die Zeile davor überlappte und in zwei Kästen zerfiel. Der
Knopf war ein <a style="display:inline-block;padding:…">; der Google-Knopf derselben Signatur
stand in einem <table><td>-Gerüst und hielt seine Form. Die eingebettete Signatur wurde bis dahin
nicht angesehen.
Neu ist die Prüfung „Kein Anker als Knopf": Sie findet display:inline-block zusammen mit padding
oder margin im style desselben <a> — in jeder Attributreihenfolge, mit einfachen oder doppelten
Anführungszeichen, über mehrere Zeilen. Jedes Merkmal allein und ein Kasten am <span> bleiben
unbeanstandet. Die Meldung nennt Linktext und Ziel und sagt, dass ein <table><td>-Gerüst an die
Stelle gehört. Sie ist eine Warnung (Ebene Praxis, ADR 0035): Beobachtet ist der Unterschied der
beiden Aufbauten, dass inline-block, padding und margin die einzelne Ursache sind, ist nicht
gemessen. Jede Nachricht trägt eine Prüfung mehr. Die Signatur selbst ändert falzmarke nicht.
Der letzte Punkt einer Liste trägt keinen unteren Abstand mehr, den setzt die Liste. Gemessen im gesetzten HTML: Unter dem Listenende standen 16 px (Punkt 4 px plus Liste 12 px), unter einem Absatz 12 px. Ein Browser fasst die Ränder zusammen, die Word-Engine von Outlook addiert sie vermutlich — ungeprüft, hier steht kein Outlook. Die 16 px erklären die beobachteten „etwa zwei Leerzeilen" allein nicht; belegt ist nur, dass der Emitter unter dem Listenende nicht mehr Platz lässt als unter einem Absatz.
docs/recht.md zählt die Stufen nach und datiert sie. Der Abschnitt „Was die Stufen derzeit wert sind“ beschrieb den Stand vom 27.08.2026: zwei Regeln, deren zweite Quelle schweigt, sechs Warnungen ohne tragende Quelle, und dass die Herabstufung „bewusst nicht geschehen“ sei. Seit #31 zählt eine schweigende Quelle nicht mehr, sieben Regeln führen werkzeug, drei fielen von Fehler auf Warnung. Der Abschnitt nennt jetzt die Zahlen von heute mit Standangabe (21.09.2026: 122 Regeln, 10 schweigende Paare, 7 Werkzeugprüfungen, 3 gefallene Regeln, 10 Regeln auf „mehrfach bestätigt“ davon 2 mit ungeprüfter Unabhängigkeit, 44 ungeprüfte Paare als offener Rest, Handarbeit). tests/test_textkanon.py zählt diese Zahlen aus den Regeldaten nach und wird rot, sobald eine Tabellenzelle des Abschnitts ihnen nicht mehr folgt oder der Abschnitt ohne Datum dasteht. (#329)
lint meldet, was der Typografie-Pass zurückhält. typografie.vorschlaege() sollte genau das sagen, hatte aber seit v0.4.0 keinen Aufrufer: Eine Regel aus einer einzigen Quelle ließ den Text unverändert, und niemand erfuhr, dass dort ein geschütztes Leerzeichen stünde, wenn sie es trüge. Jetzt wird aus jeder zurückgehaltenen Stelle eine Warnung mit Kennung der Regel, Quellzeile und der Stelle im Wortlaut (Leerzeichen schützen: „5 kg“); die zweite Zeile sagt, warum der Pass nicht selbst setzt. Trägt die Regel ihre Stufe, wird wie bisher ersetzt und nicht gewarnt — die Warnung ersetzt die Ersetzung, sie begleitet sie nicht. Wortlaut-Auszüge und das Frontmatter bleiben unberührt, eine Regel ohne Beleg schweigt. Die Warnung hält keinen Lauf an. Zurzeit betrifft das die Einheiten (5 kg, 10 EUR, 8:00 Uhr) und Kürzel vor einer Angabe (Tel., Nr., Rechnung 4711); vorschlaege() liefert je Stelle ein Paar aus Kennung und Stelle statt des ganzen geänderten Textes. (#330)
Die Doku sagt, was der Typografie-Pass tatsächlich setzt. SKILL.md, README und references/markdown.md behaupteten, der Pass setze geschützte Leerzeichen bei 10 %, 5 kg und Nr. von selbst. Das stimmt nur für Abkürzungen (z. B.), Datum (25. August) und § 5; Einheiten und Kürzel vor einer Angabe stehen auf einer einzeln belegten Regel, der Pass lässt sie unverändert, und lint meldet sie seit #330 als Warnung. Alle drei Stellen sagen das jetzt mit dem Grund und mit dem Handgriff (5 km). Ein Test liest die zurückgehaltenen Schritte aus den Regeldaten und lässt die Doku rot werden, sobald ein einzelner Schritt seine Stufe erhält oder verliert, statt sie von Hand altern zu lassen. (#331)
Die Meldung nennt keine Quelle mehr, die zur Regel schweigt. Der Zusatz „Quelle: sekundär,
einzeln belegt — …" nahm die erste Quelle unter quellen:, ohne zu lesen, ob sie zur Sache
etwas hergibt. Bei text.vermerke_max_3 (Zusatz- und Vermerkzone fasst 3 Zeilen) stand dort die
Maßzeichnung zur Form B, und die ist in den Regeldaten ausdrücklich als schweigend vermerkt —
sie bemaßt die Zone, zählt aber keine Zeilen. Die Meldung führte damit als Beleg an, was keiner
ist. Sichtbar ändert sich genau diese eine Meldung: Sie nennt jetzt den Wikipedia-Artikel, der
die 3 Zeilen unmittelbar nennt. Schweigen alle genannten Quellen, nennt die Meldung keine, statt
auf die erstbeste zurückzufallen. Die Stufe einer Regel war davon nie betroffen — dass
schweigende Quellen nicht mitzählen, gilt seit #31 unverändert. Damit ist auch die Zusicherung
aus ADR 0044
hinfällig, die Reihenfolge unter quellen: sei inhaltlich; sie war die Umgehung, nicht die
Behebung. (#350)
Infrastruktur
Die fremde Prüfung für E-Rechnungen steht in der CI — das Gegenstück zu veraPDF. Mustang 2.26.0 (Apache-2.0) prüft das PDF gegen PDF/A-3 und das eingebettete XML gegen die Schematron-Regeln des Formats, und es rechnet die Summen nach; das bleibt eingeschaltet, denn falzmarke rechnet nicht (ADR 0039) und lässt nachrechnen. Das Urteil kommt aus dem Exit-Code, gemessen statt angenommen: 0 gültig, 255 ungültig, alles andere ist ein Werkzeugfehler und ergibt NICHT GEPRÜFT. Die Regelfassung steht im Protokoll.
Die Gegenprobe ist Pflicht, und sie ist inhaltlich falsch: ein intaktes PDF, dessen XML eine Regel verletzt. Mustang bringt auch eine kaputte Datei von 15 Byte mit — die fiele aus dem banalsten Grund durch und sagte nichts über die Schematron-Prüfung.
Zwei Dinge, die gemessen und nicht übergangen sind: Auf macOS liegt unter /usr/bin/java ein
Platzhalter, den eine bloße Suche für Java hält — das Skript führt java -version deshalb aus. Und
Mustang prüft ZUGFeRD gegen die Regeln der Fassung 2.5.0, während ADR 0039 2.5.2 als aktuelle
Fassung des Standards nennt; das Protokoll sagt, wogegen tatsächlich geprüft wurde.
Noch prüft der Job nur Referenzdateien des Werkzeugs: Eine eigene Rechnung erzeugt falzmarke erst mit #116. Deshalb bleibt #118 offen, bis die eigenen Beispielrechnungen dazukommen.
Der MCP-Dienst ist auffindbar: Themen, Dockerfile, Handschlag-Prüfung. Das Repository
trägt jetzt mcp, mcp-server und model-context-protocol — bis dahin übersah jedes
Verzeichnis, das GitHub nach MCP-Servern durchsucht, das Werkzeug. Die Themenliste steht dafür
neu in scripts/topics.py und wird von scripts/repo_pruefung.py bewacht; sie war der einzige
Repo-Sollwert ohne Wächter, und deshalb ist nie aufgefallen, dass das Setz-Skript zehn Themen
nannte, während am Repository fünfzehn lagen. Dazu ein Dockerfile im Wurzelverzeichnis, wie
es die MCP-Verzeichnisse zum Bauen erwarten. Ein CI-Job baut das Image bei jedem Push, spricht
über stdio initialize und tools/list, lässt einen echten Brief im Container setzen und
prüft dessen Messbericht — samt Gegenprobe gegen ein Image ohne das MCP-SDK, in dem derselbe
Handschlag scheitern muss.
Der MCP-Dienst geht ins offizielle Registry. server.json liegt im Wurzelverzeichnis, und
der Release-Lauf trägt den Server unter io.github.blitzsicht/falzmarke ein — per OIDC, ohne
Token und ohne Konto. Der Job steht hinter dem PyPI-Job, und das ist keine Vorsicht: Das
Registry prüft die Eigentümerschaft, indem es mcp-name: <servername> in der Projektbeschreibung
auf PyPI sucht, und die entsteht erst mit dem Upload. Zwei Workflows auf dasselbe Tag liefen
parallel, und welcher zuerst fertig wäre, entschiede das Wetter. Der Eintrag konnte deshalb nicht
mit dem Vorgang selbst entstehen, sondern erst mit dem nächsten Release — also mit diesem.
Vier Wächter halten die Kette, jeder mit Gegenprobe: die Version in server.json gegen
pyproject.toml (bei jedem Push) und gegen den Tag (im Release-Lauf), der identifier gegen den
Paketnamen, und die mcp-name-Zeile im README gegen den Namen in server.json — samt der
Grenze dahinter, denn ein angeklebter Satzpunkt verhindert den Treffer des Registry.
scripts/repo_pruefung.py fragt zusätzlich das Registry selbst und meldet, solange der Eintrag
fehlt; diese Abweichung ist erwartet und benannt.
Was Glama angeht, bleibt #237 offen: Der Einreichungsweg ist nicht öffentlich dokumentiert (am
11.09.2026 gemessen), und ob Glama den Registry-Eintrag übernimmt, ist nicht zugesagt.
docs/mcp-verzeichnisse.md hält den Stand aller Verzeichnisse fest und beschreibt den
Fünf-Minuten-Weg über den Add-Server-Knopf, der ein Konto braucht.
Der Verlauf in der README trägt keine toten Links mehr. Die README ist zugleich die
Projektseite auf PyPI, und dort löst docs/entscheidungen/… nicht auf. Beim Bündeln dieser
Fassung verwiesen drei Fragmente relativ auf Entscheidungen; scripts/paket_pruefen.sh hat es
vor dem Tag gemeldet — die Projektseite einer veröffentlichten Version lässt sich nicht mehr
ändern. scripts/changelog.py schreibt solche Verweise beim Erzeugen des Auszugs jetzt auf
absolute Adressen um (Bilder auf raw, alles andere auf blob), Anker und mailto: bleiben
unberührt. Im CHANGELOG selbst bleiben sie relativ, dort sind sie richtig. Mit Gegenprobe: Ohne
die Umschreibung steht der relative Verweis wieder im Auszug.
.gstack/ steht in .gitignore. Das Arbeitsverzeichnis der gstack-Skills lag im Baum und
tauchte bei jedem git status auf — eine uncommittete Zeile, die die nächste echte Änderung
verdeckt. Für das Werkzeug ändert sich nichts; der Eintrag steht hier, weil .gitignore nach der
Regel in scripts/changelog_pflicht.py keine Doku ist und die Ausnahme ausdrücklich ein
Maintainer setzt.
17 der 44 offenen Quelle-Regel-Paare sind nachgelesen, dann wurde die Arbeit eingestellt.
Der offene Rest aus #31 war bis dahin nur eine Zahl. Nachgelesen wurden die beiden Quellen, deren
Prüfung überhaupt etwas bewegen konnte: die Maßzeichnung massskizze_b (zwölf Paare — elf
tragen, eines schweigt) und der Wikipedia-Artikel (fünf Paare, alle tragend). Vier Belege nennen
jetzt ausdrücklich ihre Lücke, etwa bei geometrie.form_b.zonen: Die Zeichnung zeigt 17,7 mm als
eine Zone, die Aufteilung in 5 + 12,7 mm zeigt sie nicht.
Ein Fund verbessert die Beleglage: text.vermerke_max_3 hing nach der Zeichnungsprüfung nur noch
an einer Implementierung, weil beide Sekundärquellen zur Zeilenzahl schweigen. Der
Wikipedia-Artikel nennt sie wörtlich („3 Zeilen für die Zusatz- und Vermerkzone") und war dort nie
als Quelle eingetragen.
Die verbleibenden 27 Paare werden nicht weiter geprüft (ADR 0042). Der Grund steht in der
Entscheidung: Ein ungeprüftes Paar wird bereits mitgezählt, Nachlesen kann eine Regel also nur
bestätigen oder herabstufen — und von den 27 liegen 16 bei Quellen, die gar keine Belegsgruppe
tragen, und 10 bei einer, die keine zweite liefern kann. Was dabei ungeprüft bleibt, steht in
docs/recht.md und in der erzeugten Liste docs/offene-quellenpruefungen.md mit Zahlen daneben.
An den Sollwerten und an der Wirkung der Regeln ändert sich nichts: Was heute Fehler ist, bleibt Fehler, was Warnung ist, bleibt Warnung.
Ein zweiter, unabhängiger Prüfer für XRechnung. Die CI hält die eigene XRechnung jetzt auch
gegen den KoSIT-Validator (1.6.3, Konfiguration XRechnung 3.0.2 vom 31.08.2026) — das Werkzeug
der herausgebenden Stelle, mit einer neueren Schematron-Fassung als Mustang. Das Urteil liest
scripts/erechnung_kosit.py aus dem Bericht und nicht aus dem Exit-Code, verlangt das Szenario
„EN16931 XRechnung (CII)“ und lässt die eigene Gegenprobe ohne Käuferreferenz nur gelten, wenn
sie an genau BR-DE-15 scheitert. Validator und Konfiguration sind über Prüfsummen festgelegt;
fällt das Werkzeug aus, ist der Lauf nicht grün.
Jeder Job in jedem Workflow hat jetzt ein Zeitlimit. Bisher stand in keinem der sechs
Workflows ein einziges timeout-minutes — es galt überall der GitHub-Default von 360 Minuten
pro Job. Auf einem macOS-Runner kostet ein einzelner hängender Job damit rund 22 USD, auf Linux
knapp 2,20 USD, und niemand merkt es, bis die Abrechnung kommt. Betroffen waren 18 Jobs: die acht
in ci.yml und zehn weitere in aktion.yml, release.yml, video.yml, roadmap.yml und
oeffentlichkeit.yml — darunter der PyPI-Upload und zwei wöchentliche Cron-Jobs.
Die Limits liegen zwischen 5 und 15 Minuten. Wo Laufzeiten vorlagen, sind sie daran ausgerichtet und mindestens dreifach großzügig: der längste Job über sechs CI-Läufe brauchte 3,8 Minuten, der GIF-Bau 1,4, der PyPI-Upload 1,2. Die ungemessenen Cron- und Selbsttest-Jobs bekommen einheitlich 15 Minuten.
Ebenfalls hier, weil es zur selben Frage gehört: kein workflow_dispatch in ci.yml. Ein
erster Entwurf hatte es — ein Lauf ohne Commit ist bequem. Es hätte aber zwei Pflicht-Checks
aushebeln können: Changelog-Eintrag und Closing-Keyword laufen nur bei pull_request, melden
bei jedem anderen Ereignis skipped, und GitHub wertet einen übersprungenen Job als erfüllt. Weil
für die Mergebarkeit der jüngste Check-Run je Name zählt, hätte ein manueller Lauf auf dem
PR-Branch ein rotes Changelog-Gate durch ein grünes skipped ersetzt, ohne dass das Gate je
gelaufen wäre. Wer die Suite ohne Commit fahren will, nimmt einen Draft-PR.
Anlass war das erreichte Actions-Spending-Limit der Organisation am 21.09.2026, das in allen
blitzsicht-Repos jeden Job stoppte. falzmarke ist mit 45,72 USD brutto das teuerste Repo, und der
Grund sind die Runner-Preise, nicht die Rechenzeit: 430 macOS-Minuten kosten 26,66 USD, dieselbe
Zeit auf Linux 2,58 USD. Die Plattform-Matrix bleibt trotzdem unangetastet — sie im Pull Request
auf Linux zu kürzen würde main sperren, weil das Ruleset tests (macos-latest) und
tests (windows-latest) namentlich als Pflicht-Check verlangt. Der Umbau gehört in einen eigenen
Vorgang, in dem Workflow und Ruleset zusammen umgestellt werden; im Workflow stehen jetzt die drei
möglichen Wege samt ihrem gemeinsamen Haken.
v0.9.8 — 10.09.2026
Neu
-
Eine fertige Signatur mitbringen, statt eine zweite zu pflegen.
email.signatur_htmlim Profil zeigt auf eine HTML-Datei neben dem Profil,email.signatur_textauf ihre Textfassung. Ist das Feld gesetzt, ersetzt diese Signatur die aus dem Profil gebaute — sie tritt nicht daneben, denn zwei Signaturen unter einer Nachricht sind der Fehler, den dieser Weg abstellt. Aus demselben Grund bleibtemail.logodabei unbeachtet: Das Logo steckt schon darin.Der Anlass ist praktisch: Für Blitzsicht, Siluri und die Kunden erzeugt ein anderes Werkzeug längst eine gestaltete Signatur, und die steht in den Mailprogrammen. Wer eine hat, soll sie nicht ein zweites Mal beschreiben.
Übernommen wird der Rumpf, nicht das Dokument:
<head>und<style>fallen weg, der Stil wandert getrennt heraus und steht hinter dem eigenen Dunkelblock im Kopf der Nachricht. Ein zweiter<style>mitten im Rumpf wäre in mehreren Programmen wirkungslos — Gmail entfernt ihn — und in der eigenen Prüfung ein Verstoß.Der Kanal gibt dabei nicht nach. Die Regeln von ADR 0034 gelten für eine fremde Signatur wie für eigenen Satz: kein Skript, kein externes Stylesheet, kein Zählpixel, keine Layouttabelle ohne
role="presentation", kein Verweis nach außen im Stil. Was durchfällt, wird abgelehnt — mit Fundstelle und dem Namen der Datei, nicht stillschweigend eingesetzt.Damit ändert sich eine Zusage, und der ADR-Nachtrag sagt genau, um welches Maß: Der Stilblock war eine Konstante und sonst nichts. Er hat jetzt zwei Teile — der eigene steht vorn und wird weiter Zeichen für Zeichen verglichen, der mitgebrachte dahinter wird geprüft. Die Reihenfolge ist Teil der Zusage; etwas vor der Konstante bleibt ein Verstoß. (#275)
Behoben
-
Eine Signatur darf ihre eigene Breite haben. Die Prüfung aus #264 lehnte jede Layouttabelle mit
max-widthab; gemeint war eine einzige — der Umschlag, den falzmarke selbst um die Nachricht legt. Er umfasst alles und quetscht deshalb alles, wenn er einen Deckel trägt. Eine mitgebrachte Signatur (#275) ist etwas anderes: ein kurzer Block am Ende, dessen eigene Breite niemanden quetscht. Die voncw-coreerzeugten tragen 580 px, und eine Mail damit endete mit Exit-Code 2, obwohl inhaltlich nichts falsch war.Gemessen wird jetzt die äußerste Layouttabelle. Die Gegenprobe hält: Ein
max-widtham Umschlag selbst wird weiterhin rot — das ist der Fall aus #264, und er darf nicht mit durchrutschen. Die Prüfung heißt entsprechend „Umschlag ohne Breitendeckel". (#279)
Infrastruktur
-
Die beiden Ausnahme-Labels der Prüfer gibt es jetzt wirklich.
changelog_pflicht.pyundclosing_keyword.pybieten je einen ausdrücklichen Fluchtweg an, undCONTRIBUTING.mdbeschreibt den ersten — nur existierteohne-changelogim Repository überhaupt nicht (37 Labels, keins mit dem Namen), undohne-autoschlusswar von Hand angelegt. Ein dokumentierter Fluchtweg ohne Label ist keiner. Beide stehen jetzt imLABELS-Block vonrepo-einstellungen.sh, und ein Test liest die Namen aus den Prüfern statt aus einer zweiten Liste: Wird eines umgetauft, fällt der Test, statt dass still eine Ausnahme zumacht. -
changelog_pflicht.pybleibt unter Windows lesbar. Dieselbe Falle, die den Windows-Lauf zu #268 rot gemacht hat: Der Prüfer druckt typografische Anführungszeichen, dort schreibt Python in cp1252, und beim Aufrufer kommt statt des Befundes gar nichts an. Aufgefallen wäre es hier nie von selbst — der Job läuft ausschließlich auf ubuntu. Der Regressionstest erzwingt cp1252 überPYTHONIOENCODINGund läuft damit auf jedem System. (#276)
Davor liegen 27 weitere Versionen — der vollständige Verlauf steht in CHANGELOG.md.
Lizenz
1 maintainer

Release files for falzmarke 0.9.9
For a detailed explanation of source distributions (sdists) and built distributions (wheels), please see the package formats documentation.
Source distribution (sdist)
| File | Size | Uploaded | |
|---|---|---|---|
| falzmarke-0.9.9.tar.gz | 1.4 MB | Details |
Built distribution (wheel)
| File | Interpreter | ABI | Platform | Reset |
|---|---|---|---|---|
| falzmarke-0.9.9-py3-none-any.whl | Python 3 | none | any | Details |
Total release size: 2.4 MB
Release files / falzmarke-0.9.9.tar.gz
| Download URL | falzmarke-0.9.9.tar.gz |
|---|---|
| Size | 1.4 MB |
| Tags | Source |
|
SHA-256 checksum How to use checksums |
9697b8c2243aad8aa5f77d4f60d13674f46a32ae85363f9f157068a3acc8fcfd
|
|
BLAKE2b-256 checksum How to use checksums |
b4ab85fba54825141638cb24ccf3790f909fd4dbdfa8f02a4f4a09a0b77a2cfc
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.14
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.


PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Sep 25, 2026.
Transparency logRelease files / falzmarke-0.9.9-py3-none-any.whl
| Download URL | falzmarke-0.9.9-py3-none-any.whl |
|---|---|
| Size | 987.6 kB |
| Tags | Python 3 |
|
SHA-256 checksum How to use checksums |
edf4b56f8fb25d47ad97b7dee78446eff3a9fe516b62d7e44613beb6624a1fa3
|
|
BLAKE2b-256 checksum How to use checksums |
73d2271c35eac032d32c599ff3097226f94d25ea7d5d720112d0c2572df137d5
|
| Upload date | |
|
Uploaded using Trusted Publishing? What is trusted publishing? |
Yes |
| Uploaded via |
twine/7.0.0 CPython/3.13.14
|
Provenance
Provenance describes where a file came from. On PyPI, provenance is shared via attestations, which provide a verifiable record of the build or publishing details. View details, limitations and caveats.
PyPI Publish Attestation
PyPI verified that this artifact, at this checksum, originated from the publisher listed below.
Signed by GitHub Actions, verified by PyPI on Sep 25, 2026.
Transparency log














